

Ahoj, Habr.
Jmenuji se Misha Butrimov a chtěl bych vám říct něco o Cassandře. Můj příběh bude užitečný pro ty, kteří se nikdy nesetkali s NoSQL databázemi - má spoustu specifik a skrytých problémů, o kterých je potřeba vědět. A pokud jste nic neviděli kromě Oracle nebo jiných relačních databází, tyto věci vám zachrání život.
Co je na Cassandře dobré? Je to NoSQL databáze navržená bez jediné vhodného bodu selhání, která se dobře škáluje. Pokud potřebujete přidat pár terabajtů k nějaké databázi, jednoduše přidáte uzly do kruhu. Rozšířit ji do dalšího datového centra? Přidáte uzly do clusteru. Zvětšit zpracovávaný RPS? Přidáte uzly do clusteru. A naopak také to funguje.
V čem je ještě dobrá? V tom, že dokáže zpracovávat velké množství dotazů. Ale co to znamená hodně? 10, 20, 30, 40 tisíc dotazů za sekundu – to je málo. 100 tisíc dotazů za sekundu na zápis – také málo. Existují společnosti, které tvrdí, že zvládají 2 miliony dotazů za sekundu. Tak těm asi bude muset věřit.
A v zásadě má Cassandra jedno velké odlišení od relačních dat – vůbec na ně nepřipomíná. A na to je velmi důležité nezapomínat.
Není všechno, co vypadá stejně, to samé.
Jednou ke mně přišel kolega a zeptal se: „Tady je SQuL Cassandra query language, má select statement, má where, má and. Píšu písmena, a nefunguje to. Proč?“. Pokud se k Cassandře přistupuje jako k relační databázi, je to ideální způsob, jak skončit s krutým sebevraždou. A já to nepropaguji, to je v Rusku zakázáno. Jen prostě navrhnete něco špatně.
Například k nám přijde zákazník a říká: „Pojďme postavit databázi pro seriály, nebo databázi pro recepty. Budeme mít jídla s ingrediencemi nebo seznam seriálů a herců v nich.“ Radostně říkáme: „Pojďme na to!“. To jsou dva bajty poslat, pár tabulek a je to hotové, vše bude fungovat velmi rychle a spolehlivě. A všechno je skvělé, dokud zákazníci nepřijdou a neřeknou, že hospodyňky chtějí řešit i opačný problém: mají seznam ingrediencí a chtějí zjistit, který pokrm chtějí připravit. Jste mrtví.
Všechno to proto, že Cassandra je hybridní databáze: je to jak key-value, tak ukládá data ve velkých sloupcích. Pokud bychom mluvili jazykem Java nebo Kotlin, dalo by se to popsat takto:
Map<RowKey, SortedMap>
To znamená mapa, uvnitř které je další seřazená mapa. Prvním klíčem k této mapě je Row key nebo Partition key — klíč pro partioning. Druhý klíč, který je klíčem k již seřazené mapě, je Clustering key.
Abychom ilustrovali rozložení databáze, nakreslíme tři uzly. Nyní je potřeba pochopit, jak rozložit data na uzly. Protože pokud všechno naskládáme do jednoho (může jich být tisíc, dvě tisíce, pět — kolik chcete), není to příliš o rozložení. Proto potřebujeme matematickou funkci, která vrátí číslo. Prostě číslo, dlouhý int, který spadá do nějakého rozsahu. A jeden uzel bude odpovídat za jeden rozsah, druhý za druhý, a n-tý za n-tý.
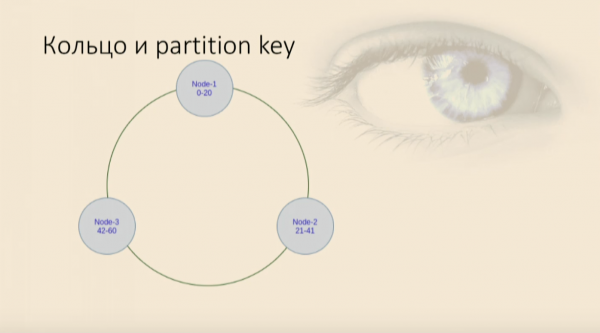
Toto číslo se vezme pomocí hashovací funkce, která se aplikuje právě na to, co nazýváme Partition key. To je ten sloupec, který se uvádí v direktivě Primary key, a to je ten sloupec, který bude prvním a nejzákladnějším klíčem mapy. Určuje, na který uzel jaká data spadnou. Tabulka se v Cassandře vytváří téměř se stejnou syntaxí jako v SQL:
CREATE TABLE users (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY(user_id)

)
Primary key v tomto případě se skládá z jednoho sloupce, který je zároveň klíčem pro partitioning.
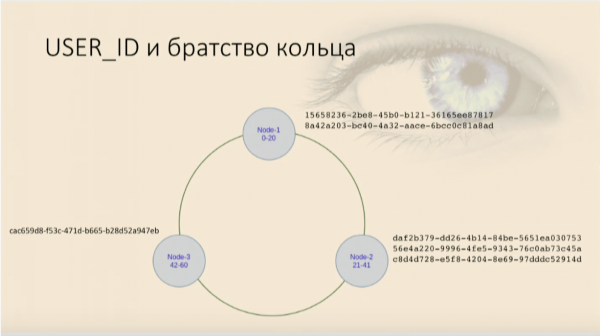
Jak se nám uživatelé rozdělí? Část spadne na jeden uzel, část na druhý a část na třetí. Vzniká klasická hash tabulka, také mapa, také ve Pythonu — slovník, a také — jednoduchá struktura Key value, ze které můžeme číst všechny hodnoty, číst a psát podle klíče.
Select: když allow filtering se mění na full scan, nebo jak to dělat špatně
Pojďme napsat nějaký select statement: select * from users where userid = Je to podobné jako v Oracle: napíšeme select, vymezíme podmínky a všechno funguje, uživatelé se vytáhnou. Ale pokud vybereme například uživatele s určitým rokem narození, Cassandra se ozve, že nemůže provést dotaz. Protože vůbec nic neví o tom, jak máme rozložená data o roce narození — klíč má definován pouze v jedné koloně. V tom okamžiku říká: „Dobře, mohu tento dotaz stále provést. Přidejte allow filtering.“ Přidáme direktivu, všechno funguje. A v tomto okamžiku se stane něco hrozného.
Když zpracováváme testovací data, vše je skvělé. Ale když provedete dotaz v produkci, kde máme například 4 miliony záznamů, není to vůbec dobré. Protože allow filtering je direktiva, která umožňuje Cassandře shromáždit všechna data z této tabulky ze všech uzlů, všech datová centra (pokud jich je v tomto klastru hodně), a až poté je filtrovat. To je ekvivalent Full Scan a těžko by někdo byl z něj nadšený.
Kdybychom potřebovali uživatele pouze podle identifikátorů, to by nám vyhovovalo. Ale někdy musíme psát jiné dotazy a uplatnit další omezení na výběr. Tak si vzpomeneme: to všechno je mapa, která má klíč partition, ale uvnitř je to seřazená mapa.
A ta má také klíč, kterému říkáme Clustering Key. Tento klíč se skládá z sloupců, které vybereme, a na základě kterých Cassandra chápe, jak budou data fyzicky seřazena a uložena na každém uzlu. Tedy, pro nějaký Partition key Clustering key říká, jak přesně vložit data do tohoto stromu, jaké místo tam zaberou.
To je skutečný strom, kde se pouze vyvolává komparátor, do kterého předáme sadu sloupců ve formě objektu, a také se specifikuje jako výčet sloupců.
CREATE TABLE users_by_year_salary_id (
	user_id uuid,
	name text,
	year int,
	salary float,
	PRIMARY KEY((year), salary, user_id)
Všimněte si direktivy Primary key, jejíž první argument (v našem případě rok) vždy představuje Partition key. Může se skládat z jedné nebo více sloupců, na tom nezáleží. Pokud je sloupců více, je třeba je ještě jednou umístit do závorek, aby preprocesor jazyka pochopil, že se jedná o Primary key, a za ním následují všechny ostatní sloupce — Clustering key. Přitom budou v komparatoru předávány v tom pořadí, v jakém jdou. To znamená, že první sloupec je významnější, druhý — méně významný a tak dále. Jak například píšeme pro datové třídy pole equals: uvádíme pole a pro ně určujeme, která jsou více a která méně. V Cassandře jsou to, tak říkajíc, pole datové třídy, na kterou se aplikuje napsané equals.
Nastavujeme třídění, přikládáme omezení
Je třeba mít na paměti, že pořadí třídění (sestupné, vzestupné, nezáleží) se nastavuje ve stejnou chvíli, kdy je vytvořen klíč, a později jej nebude možné změnit. Fyzicky určuje, jak budou data seřazena a jak budou uložena. Pokud bude potřeba změnit Clustering key nebo pořadí třídění, bude nutné vytvořit novou tabulku a přetáhnout do ní data. S již existující to nebude možné.
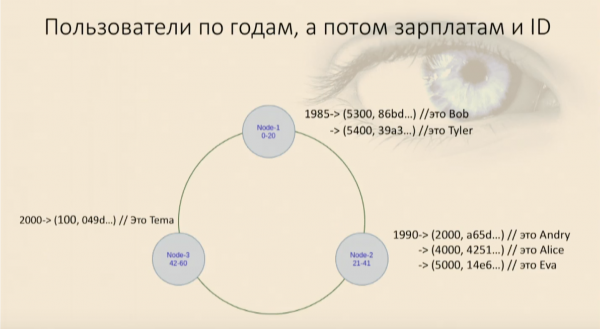
Naplnili jsme naši tabulku uživateli a viděli jsme, že se seřadili nejprve podle roku narození a potom uvnitř na každém uzlu podle platu a podle user ID. Nyní můžeme vybírat s přiloženými omezeními.
Znovu se objevuje náš fungující where, and, a uživatelé se k nám dostávají, všechno je opět v pořádku. Ale pokud se pokusíme použít pouze část Clustering key, a to tu méně významnou, Cassandra okamžitě upozorní, že nemůže ve naší mapě najít místo, kde tento objekt, jehož tato pole pro komparator jsou null, a ten, který jsme právě nastavili, — kde se nachází. Budu muset znovu stáhnout všechna data z tohoto uzlu a filtrovat je. A to je analogie Full Scan v rámci uzlu, což je špatně.
V jakékoli nejasné situaci vytvářej novou tabulku
Pokud chceme mít možnost vybírat uživatele podle ID, věku nebo platu, co dělat? Nic. Stačí použít dvě tabulky. Pokud budeme potřebovat vybírat uživatele třemi různými způsoby — tabulek bude tři. Ty časy, kdy jsme šetřili místo na disku, už dávno pominuly. To je nejlevnější zdroj. Je mnohem levnější než doba odezvy, která může být pro uživatele zničující. Uživatel bude mnohem spokojenější, když něco dostane za sekundu než za 10 minut.
Vyměňujeme nadbytečně zabrané místo, denormalizovaná data za možnost dobře škálovat a spolehlivě fungovat. Klaster, který se skládá ze tří datových center, přičemž každé má pět uzlů, při přijatelném úrovni uchovávání dat (kdy se určitě nic neztratí), dokáže překonat zánik jednoho datového centra úplně. A ještě po dva uzly v každém z těch dvou zbývajících. A až po tom začnou problémy. To je docela dobré zálohování, to stojí pár-tři navíc SSD disků a procesorů. Proto, abychom mohli použít Cassandra, která není SQL, nemá vztahy, cizí klíče, je potřeba znát jednoduchá pravidla.
Navrhujeme vše od dotazu. Hlavními nejsou data, ale jak s nimi bude aplikace pracovat. Pokud potřebuje získávat různá data různými způsoby, nebo stejná data různými způsoby, musíme je uložit tak, jak bude aplikaci pohodlné. Jinak se dostaneme do Full Scan a žádné výhody Cassandra nám nepřinese.
Denormalizovat data je normální. Zapomínáme na normální formy, už nemáme relační databáze. Uložíme něco 100krát, bude ležet 100krát. Je to stále levnější, než zpomalit.
Vybíráme klíče pro partitioning tak, aby se normálně rozdělovaly. Nepotřebujeme, aby hash našich klíčů spadl do úzkého rozsahu. To znamená, že rok narození v předchozím příkladu — je špatný příklad. No, je dobrý, pokud máme uživatele podle roku narození správně rozloženy, a špatný, pokud se jedná o žáky 5. třídy — tam to nebude dobře partitionovat.
Seřazení se vybírá pouze jednou při vytváření Clustering Key. Pokud je třeba jej změnit, bude nutné přetáhnout naši tabulku s jiným klíčem.
A to nejdůležitější: pokud potřebujeme 100 různými způsoby získat stejná data, budeme mít 100 různých tabulek.
Zdroj: habr.com
