

Někdy je třeba se na problém podívat z jiného úhlu, abychom ho vyřešili. I když se v posledních deseti letech podobné problémy řešily stejným způsobem s různými výsledky, není jisté, že tento způsob je jediný.
Existuje téma odlivu zákazníků. Je to nevyhnutelný jev, protože zákazníci jakékoli společnosti mohou z mnoha důvodů přestat využívat její produkty nebo služby. Samozřejmě, pro společnost je odliv — ačkoliv přirozený — nežádoucí jev, a proto se všichni snaží minimalizovat tento odliv. Ještě lépe — předpovědět pravděpodobnost odlivu určité kategorie uživatelů nebo konkrétního uživatele a nabídnout nějaké kroky k jejich udržení.
Analyzovat a pokusit se udržet zákazníka, pokud je to možné, je třeba alespoň z následujících důvodů:
- získání nových zákazníků je dražší než procesy udržení. Na získání nových zákazníků je obvykle třeba investovat určité peníze (reklama), zatímco stávající zákazníky lze aktivovat speciální nabídkou s mimořádnými podmínkami;
- pochopení příčin odchodu zákazníků je klíčem ke zlepšení produktů a služeb.
Existují standardní přístupy k předpovědi odlivu. Na jednom z mistrovství v AI jsme se rozhodli vyzkoušet pro tento účel Weibullovo rozdělení. Nejčastěji se používá pro analýzu přežívání, předpověď počasí, analýzu přírodních katastrof, v průmyslovém inženýrství a podobně. Weibullovo rozdělení je speciální funkce rozdělení, parametrizovaná dvěma parametry.  a
 .
Wikipedia
Celkově je to zajímavá věc, ale pro předpověď odlivu, a vůbec v fintechu, se to nevyužívá příliš často. V následujícím textu se podělíme o to, jak jsme (Laboratoř inteligentní analýzy dat) tuto metodu aplikovali a zároveň získali zlato na Mistrovství v umělé inteligenci v kategorii „AI v bankách“.
O odlivu obecně
Pojďme si trochu objasnit, co to je odliv zákazníků a proč je tak důležitý. Pro podnikání je důležitá zákaznická základna. Do této základny přicházejí noví zákazníci, například když se dozvědí o produktu nebo službě prostřednictvím reklamy, nějakou dobu fungují (aktivně využívají produkty) a po nějaké době přestanou. Tento období nazýváme „Životní cyklus zákazníka“ (angl. Customer Lifecycle) — to je termín, který popisuje fáze, jimiž zákazník prochází, když se dozví o produktu, rozhoduje o koupi, platí, využívá a stává se loajálním spotřebitelem, a nakonec přestává používat z různých důvodů produkty. Odliv tedy představuje závěrečnou fázi životního cyklu zákazníka, kdy zákazník přestává využívat služby, což pro podnikání znamená, že zákazník přestal přinášet zisk a jakýkoli prospěch.
Každý zákazník banky je konkrétní osoba, která si vybírá tu či onu bankovní kartu speciálně pro své potřeby. Často cestuje — karta se mílemi bude užitečná. Hodně nakupuje — ahoj, karta s cashbackem. Hodně nakupuje v konkrétních obchodech — na to už existují speciální partnerské plastové karty. Samozřejmě, někdy se karta vybírá také podle kritéria „Nejlevnější služby“. V každém případě je tu dost proměnných.
A ještě si člověk vybírá sám banku — jaký smysl má vybírat kartu banky, jejíchž poboček je pouze v Moskvě a okolí, když jsi z Chabarovska? Ať je karta takové banky jakkoli výhodná, přítomnost poboček banky v blízkosti stále zůstává důležitým kritériem. Ano, 2019 už je tady a digital — to je naše všechno, ale řadu otázek někteří banky mohou vyřešit pouze na pobočce. Navíc, opět část populace důvěřuje mnohem více fyzické bance než aplikaci v chytrém telefonu, to je také třeba brát v úvahu.
V důsledku toho může mít člověk mnoho důvodů k odchodu od produktů banky (nebo od samotné banky). Změnil práci, a sazba karty se změnila z platbní na „pro obyčejné smrtelníky“, což je méně výhodné. Přestěhoval se do jiného města, kde nejsou pobočky banky. Nelíbilo se mu jednání s nekvalifikovaným operátorem na pobočce. Tedy důvodů pro uzavření účtu může být daleko více, než pro používání produktu.
Klient může nejen výslovně vyjádřit svůj úmysl – přijít do banky a napsat žádost, ale také jednoduše přestat používat produkty, aniž by zrušil smlouvu. Právě pro porozumění takovým úlohám bylo rozhodnuto použít strojové učení a AI.
Co více, odliv zákazníků může nastat v jakémkoli odvětví (telekomunikace, internetoví poskytovatelé, pojišťovací společnosti, jednoduše všude, kde existuje zákaznická základna a pravidelné transakce).
Co jsme udělali
Nejprve bylo nutné popsat jasnou hranici – od kterého okamžiku začneme počítat zákazníka jako odcházejícího. Z pohledu banky, která nám poskytla údaje k analýze, byla aktivita zákazníka binární – buď byl aktivní, nebo ne. Existovala značka ACTIVE_FLAG v tabulce „Aktivita“, jejíž hodnota mohla být buď „0“, nebo „1“ (příslušně „Neaktivní“ a „Aktivní“). A to by bylo v pořádku, ale člověk je takový, že může nějakou dobu aktivně používat službu a pak na měsíc vypadnout ze seznamu aktivních – například z důvodu nemoci, odjezdu do zahraničí na dovolenou, nebo dokonce vyzkoušení karty jiné banky. Anebo se po dlouhém období neaktivity znovu začít bankovními službami zabývat.
Proto jsme se rozhodli nazývat obdobím neaktivity určitý nepřetržitý časový úsek, během kterého se pro něj nastavila značka jako „0“.
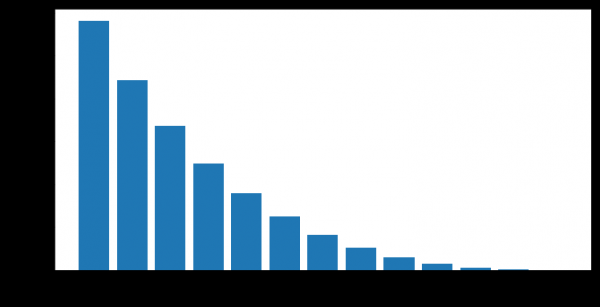
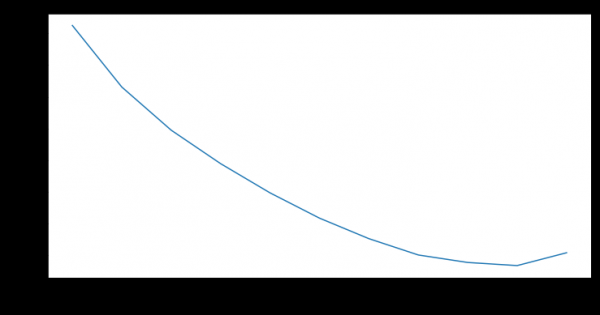
Zákazníci přecházejí z neaktivních do aktivních po různě dlouhých obdobích neaktivity. Máme možnost vypočítat empirickou veličinu „spolehlivost období neaktivity“ – tedy pravděpodobnost, že člověk znovu začne používat produkty banky po určité dočasné neaktivitě.
Například na tomto grafu je zobrazeno obnovení aktivity (ACTIVE_FLAG=1) zákazníků po několika měsících neaktivity (ACTIVE_FLAG=0).
Zde trochu upřesníme soubor dat, se kterými jsme začali pracovat. Banka poskytla agregované informace za 19 měsíců v následujících tabulkách:
- „Aktivita“ – měsíční transakce zákazníků (karty, internetové bankovnictví a mobilní bankovnictví), včetně výplat a informací o obratech.
- „Karty“ – údaje o všech kartách, které má klient, s podrobným ceníkem.
- „Smlouvy“ – informace o smlouvách klienta (jak otevřených, tak uzavřených): úvěry, vklady a další, s uvedením parametrů každé z nich.
- „Klienti“ – soubor demografických údajů (pohlaví a věk) a dostupnost kontaktních údajů.
Pro naši práci byly potřeba všechny tabulky kromě „Karet“.
Obtížnost byla také v tom, že banka v těchto datech neuváděla, jaká konkrétní aktivita probíhala na kartách. To znamená, že jsme mohli zjistit, zda došlo k transakcím, ale určit jejich typ – to už ne. Proto nebylo jasné, zda klient vybíral hotovost, zda mu byla na účet zaslána mzda, nebo zda utrácel peníze na nákupy. A navíc jsme neměli data o zůstatcích na účtech, což by bylo užitečné.
Samotný výběr byl nezkreslený – na tomto řezu za 19 měsíců banka nepodnikla žádné pokusy o udržení klientů a minimalizaci odtoku.
Teď k obdobím neaktivity.
Pro formulaci definice odtoku je potřeba vybrat období neaktivity. Abychom vytvořili prognózu odtoku v určitém čase,  je nutné mít historii klientů minimálně za 3 měsíce v intervalu
 . Historie byla u nás omezena na 19 měsíců, proto jsme se rozhodli brát období neaktivity na 6 měsíců, pokud existuje. A za minimální období pro kvalitní prognózu jsme vzali 3 měsíce. Čísla 3 a 6 měsíců jsme vzali empiricky na základě analýzy chování těchto klientů.
Definici odtoku jsme formulovali takto: měsíc odtoku klienta  je první měsíc s ACTIVE_FLAG=0, kde od tohoto měsíce následuje alespoň šest nul v poli ACTIVE_FLAG, jinými slovy, měsíc, od kterého klient nebyl 6 měsíců aktivní.
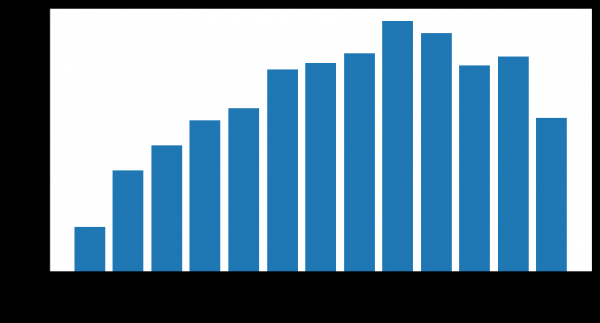
Počet odchozích klientů
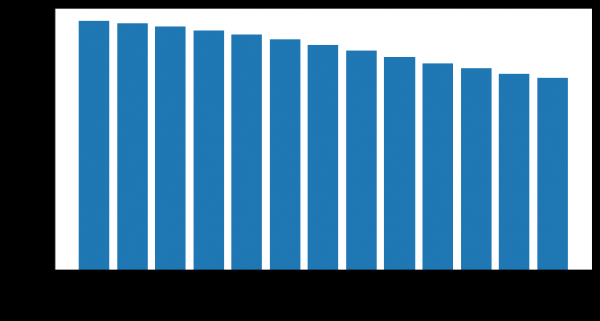
Počet zbývajících klientů
Jak se obecně považuje za odtok
V takových soutěžích, a obecně v praxi, se odtok často prognózuje tímto způsobem. Klient používá produkty a služby v různých časových intervalech, data o jeho interakcích se prezentují jako vektor rysů pevné délky n. Nejčastěji tato informace zahrnuje:
- Charakterizující uživatelská data (demografické údaje, marketingový segment).
- Historii používání bankovních produktů a služeb (toto jsou akce klientů, které jsou vždy vázány na konkrétní čas nebo období požadovaného intervalu).
- Externí data, pokud se je podařilo získat – například recenze ze sociálních sítí.
A až poté se vyvodí definice odchodu, vlastní pro každou úlohu. Poté se použije algoritmus strojového učení, který předpovídá pravděpodobnost odchodu zákazníka.  na základě vektoru faktorů.
 Pro trénink algoritmu se používá jeden z běžně známých rámců pro vytváření ensemble rozhodovacích stromů, , , nebo jejich modifikace.
Algoritmus není špatný, ale v oblasti predikce odchodu má několik vážných nedostatků.
- Nemá takzvanou „paměť“.Do modelu vstupuje stanovený počet znaků, které odpovídají aktuálnímu okamžiku. Aby bylo možné zahrnout informace o historii změny parametrů, je nutné vypočítat speciální znaky, které charakterizují změny parametrů v čase, například počet nebo součet bankovních transakcí za poslední 1, 2, 3 měsíce. Tento přístup může pouze částečně odrážet povahu časových změn.
- Pevně stanovený horizont predikce. Model dokáže předpovídat odchod zákazníků pouze na předem stanovené časové období, například predikce na jeden měsíc dopředu. Pokud je třeba předpovědět na jiné časové období, například na tři měsíce, je nutné restrukturalizovat tréninkový vzorek a znovu naučit nový model.
Náš přístup.
Rozhodli jsme se hned na začátku, že nebudeme používat standardní přístupy. V soutěži se kromě nás zaregistrovalo dalších 497 lidí, z nichž každý měl značné zkušenosti. Takže snažit se dělat něco podle standardního schématu za takových podmínek – není nejlepší nápad.
A začali jsme řešit problémy, které stáli před modelem binární klasifikace, pomocí predikce pravděpodobnostního rozdělení času odchodu zákazníků. Takový přístup si můžete prohlédnout, umožňuje flexibilněji předpovídat odchod a ověřovat složitější hypotézy než v klasickém přístupu. Jako rodinu rozdělení modelujících čas odchodu jsme zvolili rozdělení pro jeho široké využití v analýze přežití. Chování zákazníka lze považovat za jakýsi druh přežití.
Zde jsou příklady rozdělení hustot pravděpodobnosti Weibulla v závislosti na parametrech  a
 :
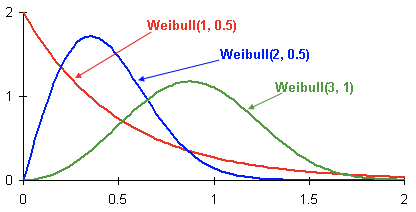
Toto je hustota rozdělení pravděpodobnosti odchodu zákazníka tří různých klientů v průběhu času. Čas je znázorněn v měsících. Jinými slovy, tento graf ukazuje, kdy je nejpravděpodobnější, že dojde k odchodu zákazníka v následujících dvou měsících. Jak je vidět, klient s rozdělením má větší potenciál odejít dříve než klienti s rozděleními Weibull(2, 0.5) a Weibull(3, 1).
Výsledkem je model, který pro každého klienta v jakémkoli
měsíci predikuje parametry rozdělení Weibulla, které nejlépe odráží pravděpodobnost odchodu v průběhu času. Pokud podrobněji:
- Cílové znaky na trénovací vzorku - čas zbývající do odchodu v konkrétním měsíci pro konkrétního klienta.
- Pokud nemáme údaj o odchodu klienta, předpokládáme, že čas odchodu je delší než počet měsíců, počínaje aktuálním měsíce a až do konce dostupných historických dat.
- Použitý model: rekurentní neuronová síť s LSTM vrstvou.
- Jako ztrátovou funkci používáme zápornou logaritmickou funkci pravděpodobnosti pro rozdělení Weibulla.
Zde jsou výhody této metody:
- Pravděpodobnostní rozdělení, kromě zřejmé možnosti binární klasifikace, umožňuje flexibilně predikovat různé události, například zda klient přestane využívat služeb banky během 3 měsíců. Pokud je potřeba, na základě tohoto rozdělení lze také průměrovat různé metriky.
- Rekurentní neuronová síť LSTM má paměť a efektivně využívá celou dostupnou historii. S rozšířením nebo upřesněním historie se přesnost zvyšuje.
- Přístup lze snadno škálovat při rozdělení časových úseků na menší (například při rozdělení měsíců na týdny).
Ale nestačí vytvořit dobrý model, je také nutné správně zhodnotit jeho kvalitu.
Jak jsme hodnotili kvalitu
Jako metrikou jsme zvolili Lift Curve. Používá se v obchodě pro podobné případy díky jasné interpretaci, je dobře popsána a . Pokud bychom popsali smysl této metriky jednou větou, byla by to „O kolik lépe algoritmus předpovídá v prvních  % oproti náhodnému výběru“.
Školíme modely
Podmínky soutěže neuváděly konkrétní metriky kvality, podle kterých by bylo možno porovnávat různé modely a přístupy. Navíc definice pojmu odtoku může být různá a může záviset na formulaci úkolu, která je zase určena obchodními cíli. Proto, abychom pochopili, který způsob je lepší, jsme vytrénovali dva modely:
- Často používaný přístup binární klasifikace s využitím algoritmu strojového učení na základě rozhodovacích stromů ();
- Model Weibull-LSTM
Testovací vzorek sestával z 500 předem vybraných klientů, kteří nebyli ve tréninkovém vzorku. Pro model se prováděl výběr hyperparametrů pomocí křížové validace rozdělené podle klientů. Pro trénink každého modelu byly použity stejné sady znaků.
Vzhledem k tomu, že model nemá paměť, byly pro něj brány speciální znaky, které ukazují na poměr změn parametrů jednoho měsíce k průměrnému hodnocení za poslední tři měsíce. To charakterizovalo rychlost změny hodnot za poslední tři měsíce. Bez toho by byl model na bázi Random Forest v předem nevýhodné pozici vůči Weibull-LSTM.
Jak je LSTM s Weibullovým rozdělením lepší než přístup založený na rozhodovacích stromech
Zde je vše názorné doslova pár obrázky.
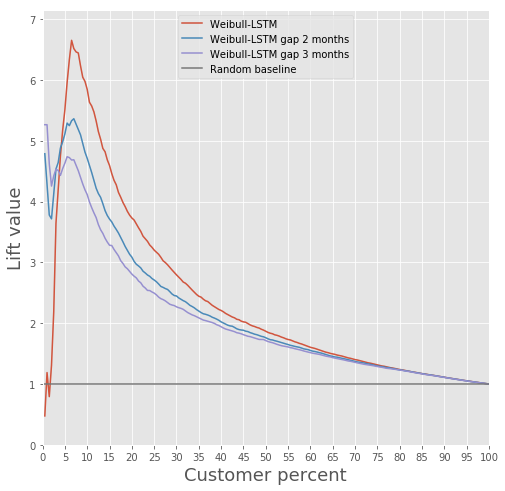
Srovnání Lift Curve pro klasický algoritmus a Weibull-LSTM
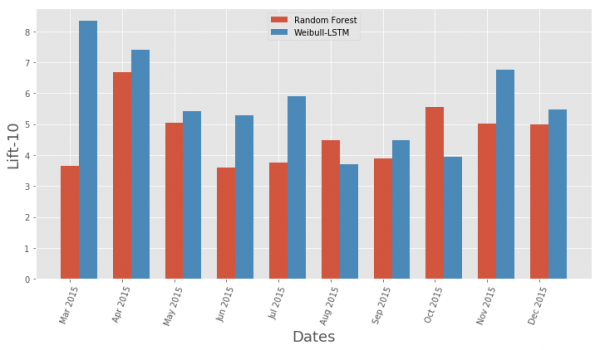
Srovnání metriky Lift Curve podle měsíců pro klasický algoritmus a Weibull-LSTM
Obecně LSTM překonává klasický algoritmus téměř ve všech případech.
Predikce odtoku
Model na základě rekurentní neuronové sítě s LSTM buňkami a Weibullovým rozdělením může předvídat odtok předem, například predikovat odchod klienta během následujících n měsíců. Zvažme případ pro n = 3. V tomto případě musí neuronová síť správně určit: odejde-li klient od příštího měsíce až do n-tého měsíce. Jinými slovy, musí správně určit, zda klient zůstane po uplynutí n měsíců. To lze považovat za předpověď dopředu: predikci okamžiku, kdy klient právě začal uvažovat o odchodu.
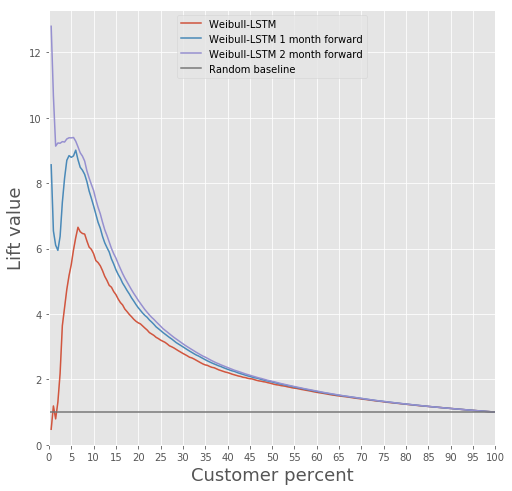
Porovnejme Lift Curve pro Weibull-LSTM na 1, 2 a 3 měsíce před odtokem:
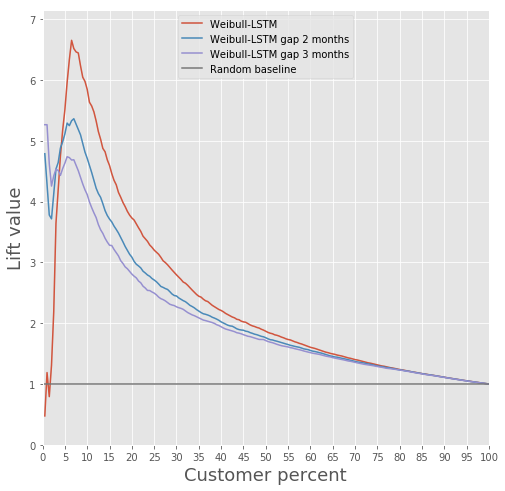
Jak jsme již zmínili výše, důležité jsou také ty předpovědi, které byly provedeny pro klienty, kteří jsou na nějakou dobu neaktivní. Proto tu přidáme do výběru takové případy, kdy byl odchozí klient neaktivní jeden nebo dva měsíce, a zkontrolujeme, zda Weibull-LSTM správně klasifikuje tyto případy jako odliv. Vzhledem k tomu, že takové případy byly ve výběru, očekáváme, že si síť s nimi poradí dobře:
Udržení klientů
Ve skutečnosti, to je hlavní, co lze udělat, když máte informace o tom, že tito klienti se chystají přestat používat produkt. Pokud hovoříme o budování modelu, který by mohl nabízet něco užitečného klientům, abychom je udrželi — toho nebude možné dosáhnout, pokud nemáte historické pokusy, které by skončily dobře.
Takovou historii jsme neměli, a proto jsme se rozhodli takto.
- Vytváříme model, který určuje zajímavé produkty pro každého klienta.
- Každý měsíc spouštíme klasifikátor a určíme potenciálně odcházející klienty.
- Částem klientů nabízíme produkt podle modelu z bodu 1, zapamatujeme si naše akce.
- Po několika měsících se podíváme, kdo z těchto potenciálně odcházejících klientů odešel a kdo zůstal. Tímto způsobem vytváříme tréninkovou sadu.
- Trénujeme model na historii získané v bodě 4.
- Volitelně opakujeme postup a nahrazujeme model z bodu 1 modelem získaným v bodě 5.
Kontrolou kvality takového udržení může být běžné A/B testování — rozdělíme klienty, kteří potenciálně odcházejí, do dvou skupin. Jedné nabízíme produkty na základě našeho modelu udržení, druhé nenabízíme nic. Rozhodli jsme se vytrénovat model, který by mohl přinést užitek již v bodě 1 našeho příkladu.
Chtěli jsme segmentaci udělat co nejvíce interpretovatelnou. K tomu jsme vybrali několik znaků, které by mohly být snadno interpretovatelné: celkový počet transakcí, mzda, celkový obrat na účtu, věk, pohlaví. Znaky z tabulky „Karty“ nebyly brány v úvahu jako málo informativní, a znaky z tabulky 3 „Smlouvy“ byly vypuštěny kvůli složitosti zpracování, aby se předešlo úniku údajů mezi validačním a tréninkovým souborem.
Klástrování bylo provedeno pomocí Gaussovských směsných modelů. Kritérium Akaike umožnilo určit 2 optimální hodnoty. První optimální hodnota odpovídá 1 klastru. Druhá, méně výrazná optimální hodnota odpovídá 80 klastrům. Na základě tohoto výsledku lze učinit následující závěr: data je velmi obtížné rozdělit na klastry bez apriorní informace. Pro kvalitnější klástrování jsou zapotřebí data, která detailně popisují každého klienta.
Proto byla zvážena úloha učení s učitelem, aby bylo možné nabídnout každému jednotlivému klientovi jeho produkt. Byly zvažovány následující produkty: „Termínovaný vklad“, „Kreditní karta“, „Ovdrafter“, „Spotřebitelský úvěr“, „Autoúvěr“, „Hypotéka“.
V datech byl přítomen ještě jeden typ produktu: „Běžný účet“. Ale ten jsme nezvažovali kvůli nízké informační hodnotě. Byla sestavena model založený na uživatelích, kteří jsou klienty banky, t.j. nepřestali používat její produkty, které předpovídají, jaký produkt by je mohl zajímat. Jako model byla vybrána logistická regrese a jako metrika kvality byla použita hodnota Lift pro prvních 10 percentilů.
Kvalitu modelu lze posoudit na obrázku.
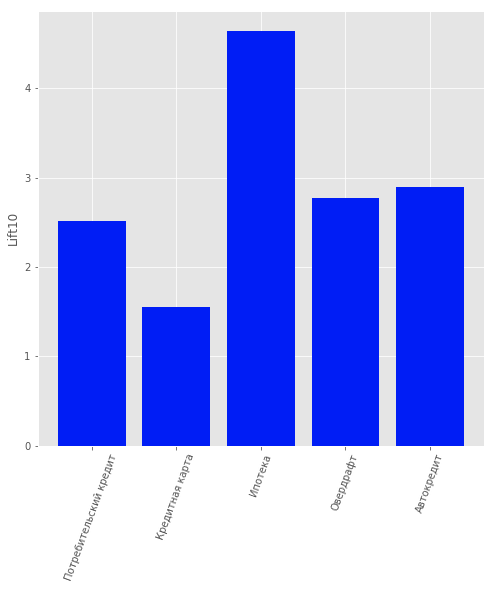
Výsledky doporučovacího modelu produktů pro klienty
Výsledek
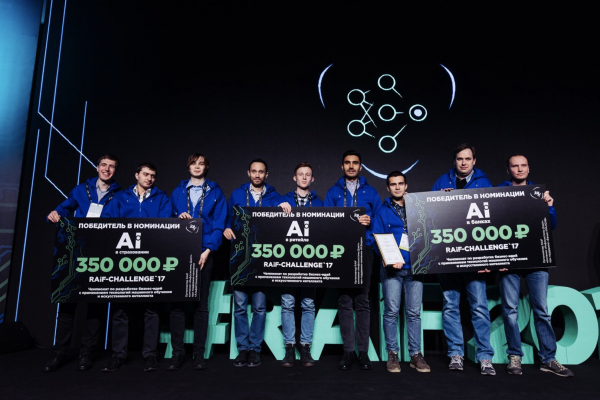
Tento přístup nám přinesl první místo v kategorii „AI v bankách“ na Šampionátu AI RAIF-Challenge 2017.
Zřejmě bylo hlavním cílem přistoupit k problému z méně obvyklého úhlu a použít metodu, která se běžně používá v jiných situacích.
I když masivní odliv uživatelů může být pro služby živelnou pohromou.
Tuto metodu lze vzít na vědomí a pro jakoukoli jinou oblast, kde je důležité zohlednit odliv, nejen u bank. Například jsme ji použili i k výpočtu vlastního odlivu — v sibiřském a petrohradském filiale Rostelekomu.
„Laboratoř inteligentní analýzy dat“ společnost „Vyhledávací portál „Sputnik“
Zdroj: habr.com
