

Tento článek je napsán, aby pomohl vybrat si vhodné řešení a porozumět rozdílům mezi SDS jako Gluster, Ceph a Vstorage (Virtuozzo).
Text obsahuje odkazy na články s podrobnějším rozsahem určitých problémů, proto budou popisy co nejstručnější, s využitím klíčových bodů bez zbytečných informací, které si můžete sami najít na internetu.
Opravdu jsou dotčená témata náročná na tón textu, ale v dnešním světě stále více lidí nemá rádo dlouhé čtení))), proto si je možné rychle přečíst a udělat výběr, a pokud něco není jasné, projít odkazy nebo vyhledat neznámá slova))), a tento článek funguje jako průhledný obal pro tato hluboká témata, ukazující náplň – hlavní klíčové body každého řešení.
Gluster
Začněme s Gluster, který je aktivně využíván výrobcem hyperkonvergovaných platforem se SDS založeným na open source pro virtuální prostředí a lze ho nalézt na webových stránkách RedHat v sekci storage, kde si můžete vybrat ze dvou variant SDS: Gluster nebo Ceph.
Gluster se skládá ze zásobníků překladačů – služba, která vykonává veškeré práce související s distribucí souborů atd. Brick – služba, která obsluhuje jeden disk, Volume – svazek (pool) – který spojuje tyto brick’y. Následuje služba distribuce souborů do skupin pomocí funkce DHT (distributed hash table). Službu Sharding nebudeme zahrnovat do popisu, protože v níže uvedených odkazech bude popsáno několik problémů s ní spojených.
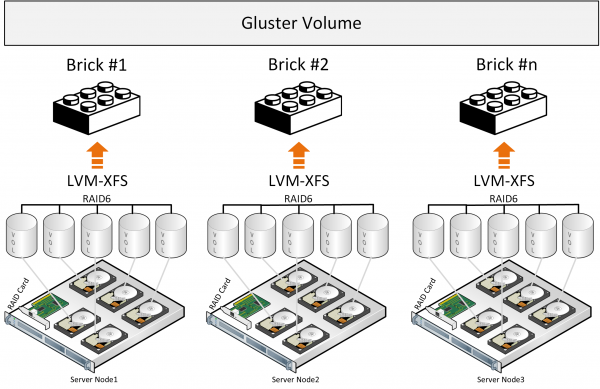
Při zápisu se celý soubor ukládá do brick a jeho kopie se paralelně zapisuje na brick na druhém serveru. Následně bude druhý soubor zapisován do druhé skupiny dvou bricků (nebo více) na různých serverech.
Pokud jsou soubory přibližně stejné velikosti a svazek se bude skládat pouze z jedné skupiny, vše funguje správně, ale při jiných podmínkách vzniknou z popisů následující problémy:
- místo ve skupinách se nevyužívá rovnoměrně, závisí to na velikostech souborů, a pokud ve skupině není dostatek místa pro zápis souboru – dostanete chybu, soubor nebude zapsán a nebude redistribuován do jiné skupiny;
- při zápisu jednoho souboru IO probíhá pouze na jednu skupinu, ostatní zůstávají nevyužité;
- nelze získat IO celého svazku při zápisu jednoho souboru;
- A celková koncepce vypadá méně výkonně kvůli absenci rozdělení dat na bloky, což usnadňuje vyvážení a řešení problému rovnoměrného rozložení, namísto toho, jak nyní celý soubor spadá do bloku.
Z oficiálního popisu také nevědomky vyvstává pochopení, že Gluster funguje jako souborové úložiště nad klasickým hardwarovým RAID. Byly pokusy o vývoj rozdělení (Sharding) souborů na bloky, ale to vše jsou doplňky, které snižují výkon stávajícího architektonického přístupu, navíc použití těchto volně šířených komponent s omezením výkonnosti jako Fuse. Neexistují služby metadat, což omezuje možnosti výkonu a dostupnosti úložiště při rozdělení souborů na bloky. Lepší výkony lze pozorovat při konfiguraci “Distributed Replicated” a počet uzlů by měl být alespoň 6 pro zajištění spolehlivé repliky 3 s optimálním rozložením zátěže.
Tyto závěry jsou také spojeny s popisem zkušenosti s a při porovnání s , a také existuje popis zkušenosti vedoucí k pochopení této výkonnější a spolehlivější konfigurace
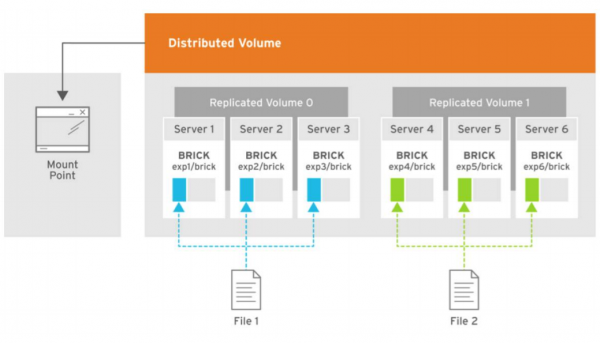
Na obrázku je znázorněno rozložení zátěže při zápisu dvou souborů, kde kopie prvního souboru jsou rozloženy na prvních třech serverech, které jsou spojeny ve skupině volume 0, a tři kopie druhého souboru padnou na druhou skupinu volume 1 ze tří serverů. Každý server má jeden disk.
Celkový závěr je, že Gluster lze použít, ale s pochopením toho, že ve výkonu a odolnosti budou omezení, která vytvářejí potíže za určitých podmínek hyperkonvergentního řešení, kde jsou zdroje potřebné i pro výpočetní zátěže virtuálních prostředí.
Existují také některé výkonnostní parametry Gluster, kterých lze dosáhnout za určitých podmínek s omezením v
Ceph
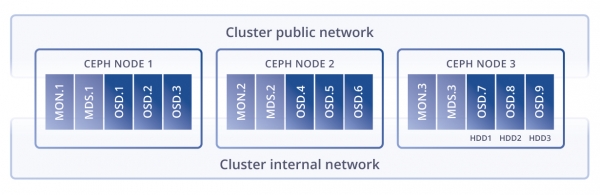
Nyní se podívejme na Ceph z popisů architektury, které se mi podařilo Také existuje srovnání mezi , kde lze ihned pochopit, že Ceph je lepší nasazovat na samostatné servery, neboť jeho službám jsou potřebné všechny zdroje hardwaru při zátěžích.
Architektura je složitější než Gluster a existují takové služby jako služby metadat, ale celkový stack komponentů je poměrně složitý a není příliš flexibilní pro použití v řešeních virtualizace. Data jsou ukládána po blocích, což vypadá výkonněji, ale v hierarchii všech služeb (komponentů) se vyskytují ztráty a latence při určitých zatíženích a nouzových podmínkách, jako je následující příklad.
Z popisu architektury vyplývá, že srdcem je CRUSH, díky němuž se vybírá místo pro umístění dat. Následuje PG — což je nejkomplexnější abstrakce (logická skupina) pro porozumění. PG slouží k tomu, aby byl CRUSH efektivnější. Hlavním účelem PG je seskupení objektů pro snížení potřeby zdrojů, zvýšení výkonu a škálovatelnosti. Přímé adresování objektů, jednotlivě, bez jejich seskupení do PG by bylo velmi nákladné. OSD – je služba pro každý jednotlivý disk.
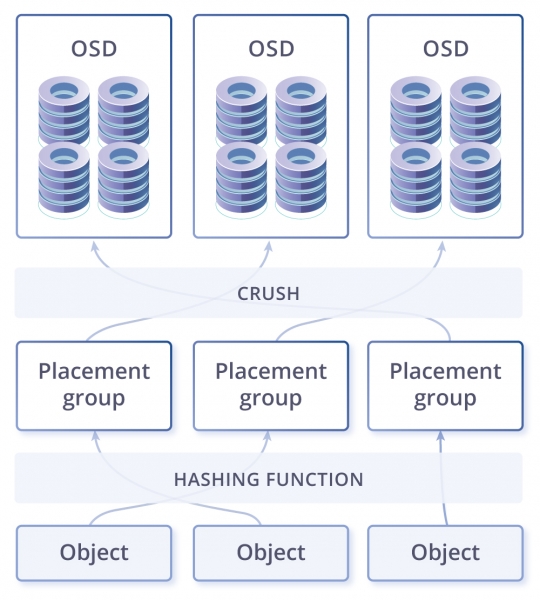
Klaster může mít jeden nebo více datových poolů různých určení a s různými nastaveními. Pooly se dělí na placement groupy. V placement groupách jsou uchovávány objekty, ke kterým se obracejí klienti. Na této logické úrovni končí a začíná fyzická úroveň, protože za každou placement groupou je zafixován jeden hlavní disk a několik replikových disků (kolik přesně závisí na faktoru replikace poolu). Jinými slovy, na logické úrovni je objekt uchováván v konkrétní placement groupě, a na fyzické úrovni — na discích, které jsou k ní přiřazeny. Přičemž disky mohou fyzicky být umístěny na různých uzlech nebo dokonce v různých datových centrech.
V tomto schématu se skupiny umístění jeví jako nezbytná úroveň pro flexibilitu celého řešení, ale zároveň jako nadbytečný článek v tomto řetězci, což vyvolává úvahy o ztrátě výkonu. Například při zápisu dat musí systém tyto údaje rozdělovat do těchto skupin a poté na fyzické úrovni na hlavní disk a na disky pro repliky. To znamená, že hash funkce funguje při vyhledávání a vkládání objektu, ale má vedlejší účinek – to jsou velmi vysoké náklady a omezení na přestavbu hash (při přidání nebo odebrání disku). Další problém hashe – to je jasně určené umístění dat, které nelze měnit. To znamená, že pokud nějaký disk zažívá zvýšenou zátěž, systém nemá možnost nepsat na něj (vybrat jiný disk), hash funkce nutí umístit data podle pravidla, bez ohledu na to, jak špatně se disku daří, takže Ceph spotřebovává mnoho paměti při přestavbě PG v případě samouzdravování nebo zvětšení úložiště. Závěr je, že Ceph funguje dobře (i když pomalu), ale jen když neprobíhá škálování, havarijní situace a aktualizace.
Existují samozřejmě možnosti zlepšení výkonu pomocí cachování a cache-tieringu, ale přitom je nutné mít kvalitní hardware a stejně dojde ke ztrátám. Obecně však Ceph vypadá lákavěji než Gluster pro produktivní využití. Také při používání těchto produktů je nutné zohlednit důležitý faktor – to je vysoká úroveň kompetencí, zkušeností a profesionality s velkým důrazem na Linux, protože je velmi důležité vše správně nasadit, nakonfigurovat a podporovat, což klade ještě větší odpovědnost a zátěž na administrátora.
Vstorage
Ještě zajímavější vypadá architektura u , kterou lze použít společně s hypervizorem na stejných uzlech, na stejném , ale je velmi důležité vše správně nakonfigurovat, aby se dosáhlo dobrého výkonu. To znamená, že nasazení takového produktu z krabice na jakoukoli konfiguraci bez ohledu na doporučení podle architektury bude velmi jednoduché, ale ne výkonné.
Co může koexistovat pro ukládání vedle služeb hypervizoru kvm-qemu, to je jen několik služeb, kde byla nalezena kompaktní optimální hierarchie komponent: služba klienta připojená přes FUSE (modifikovaná, ne open source), služba metadat MDS (Metadata service), služba bloků dat Chunk service, která na fyzické úrovni odpovídá jednomu disku, a tím to končí. Z pohledu rychlosti je samozřejmě optimální používat redundantní schéma ve dvou replikách, ale pokud zapojíme ukládání do mezipaměti a logy na disky SSD, tak chybnou odolnost kódování (erase coding nebo raid6) lze slušně zrychlit na hybridním schématu nebo dokonce ještě lépe na all flash. S EC (erase coding) je určitý nedostatek: při změně jednoho bloku dat je nutné přepočítat paritní součty. Aby se předešlo ztrátám u této operace, Ceph zapisuje do EC odloženě a problémy s výkonností mohou nastat při určitých požadavcích, kdy je potřeba přečíst všechny bloky, a v případě Virtuozzo Storage se zápis změněných bloků provádí pomocí přístupu „log-structured file system“, což minimalizuje náklady na výpočty parity. Abychom přibližně odhadli možnosti zrychlení práce s EC a bez, existuje – čísla lze získat přibližná v závislosti na koeficientu přesnosti výrobce hardwaru, ale výsledek výpočtů dobře napomáhá naplánovat konfiguraci.
Jednoduché schéma komponentů ukládání neznamená, že tyto komponenty nezabírají ale pokud se všechny náklady spočítají předem, lze očekávat spolupráci vedle hypervizoru.
Existuje schéma porovnání spotřeby zdrojů hardwaru službami Ceph a Virtuozzo storage.
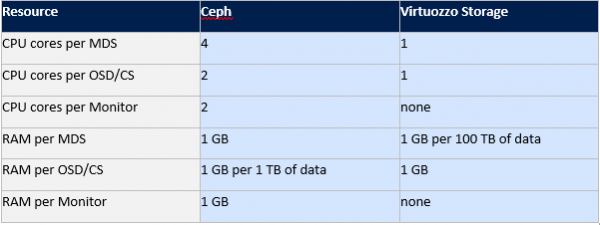
Pokud bylo dříve možné porovnat Gluster a Ceph podle starých článků, používající nejdůležitější řádky z nich, s Virtuozzo je to složitější. Článků o tomto produktu není tolik a informace lze čerpat pouze z dokumentace na nebo v ruštině, pokud zvažujeme Vstorage jako úložiště používané v některých hyperkonvergovaných řešeních v takových společnostech jako a Acronis.
Pokud jde o popis této architektury, pokusím se pomoci; proto bude text o něco delší. Abych se vyznal v dokumentaci, je třeba hodně času, a dostupnou dokumentaci lze využít pouze jako příručku pomocí přehledu obsahu nebo vyhledávání podle klíčového slova.
Pojďme se podívat na proces zápisu v hybridní konfiguraci hardwaru s výše popsanými komponentami: zápis začíná na tom uzlu, ze kterého jej inicioval klient (služba montážního bodu FUSE), ale komponenta master metadata service (MDS) samozřejmě nasměruje klienta přímo k potřebné chunk service (službě blokového úložiště CS), tedy MDS se na procesu zápisu nepodílí, pouze nasměruje na potřebnou chunk service. Můžeme použít analogii zápisu s rozléváním vody do sudů. Každý sud představuje blok dat o velikosti 256 MB.
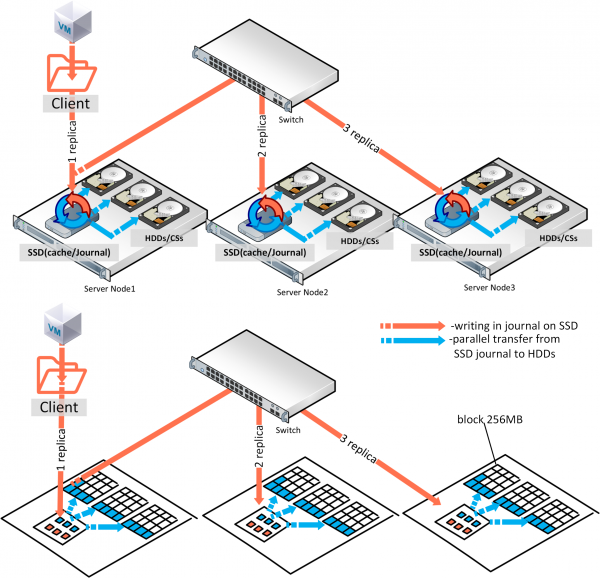
Jeden disk tedy představuje určité množství takových sudů, tedy objem disku dělený 256 MB. Každá kopie se rozlévá na jeden uzel, druhá téměř paralelně na jiný uzel atd. Pokud máme tři repliky a SSD disky pro cache (na čtení a zápisy), potvrzení zápisu proběhne po zapsání do deníku na SSD, zatímco paralelní způsob zápisu z SSD bude pokračovat na HDD, jakoby na pozadí. V případě tří replik bude zápis potvrzen po potvrzení od SSD třetího uzlu. Může se zdát, že součet rychlosti zápisu tří SSD je možné rozdělit na tři a dostaneme rychlost zápisu jedné repliky, ale zápis kopií probíhá paralelně a latence sítě je obvykle vyšší než u SSD, a vlastně výkon zápisu bude záviset na síti. Proto, abychom viděli skutečné IOPS, je třeba správně zatížit celý Vstorage podle , tzn. testovat skutečné zatížení, a ne paměť a cache, kde je třeba vzít v úvahu správnou velikost bloku dat, počet vláken atd.
Výše uvedený zápisový protokol na SSD funguje tak, že jakmile se do něj dostanou data, ihned se přečtou službou a zapíší na HDD. V klastru je několik služeb metadat (MDS) a jejich počet je určen kvorem, které funguje na základě algoritmu Paxos. Z pohledu klienta je bod připojení FUSE složka klastrového úložiště, která je současně viditelná pro všechny uzly klastru, každý uzel má připojeného klienta tímto způsobem, a proto je toto úložiště přístupné každému uzlu.
Pro výkon jakéhokoli z výše popsaných přístupů je velmi důležité při plánování a nasazení správně nastavit síť, kde bude vyvažování zatížení díky agregaci a správně zvolená propustnost síťového kanálu. Při agregaci je důležité správně zvolit režim hashování a velikosti rámců. Existuje také velmi silný rozdíl oproti výše uvedeným SDS, což je fuse s technologií fast path ve Virtuozzo Storage. Který, na rozdíl od ostatních open source řešení, výrazně zvyšuje IOPS a neomezuje se na horizontální nebo vertikální škálování. Ve srovnání s výše popsanými architekturami vypadá tato jako mnohem výkonnější, ale za tuto službu je samozřejmě nutné zakoupit licence, na rozdíl od Ceph a Gluster.
Na závěr lze zdůraznit, že na prvním místě v výkonu a spolehlivosti architektury se umístil Virtuozzo Storage, druhý Ceph a třetí Gluster.
Kritéria, podle kterých byl vybrán Virtuozzo Storage: optimální soubor komponent architektury, modernizovaný FUSE s fast path, flexibilní konfigurace hardwaru, nižší spotřeba zdrojů a možnost společného využívání s výpočty (virtualizací), což plně odpovídá hyperkonvergentnímu řešení, jehož součástí je. Druhé místo zaujímá Ceph, protože se jedná o výkonější architekturu než Gluster, díky manipulaci s bloky, stejně jako flexibilnějším scénářům a možnosti fungovat ve větších klastrech.
V pláne je napsat srovnání mezi vSAN, Space Direct Storage, Vstorage a Nutanix Storage, testování Vstorage na hardwaru HPE, Huawei, a také scénáře integrace Vstorage s externími hardwarovými úložišti, proto pokud se vám článek líbil, bylo by dobré získat od vás zpětnou vazbu, která by mohla posílit motivaci k novým článkům s ohledem na vaše připomínky a přání.
Zdroj: habr.com
