

Data Science pro začátečníky
1. Analýza sentimentu (Analýza pocitů prostřednictvím textu)
Podívejte se na kompletní realizaci projektu Data Science s využitím zdrojového kódu — .
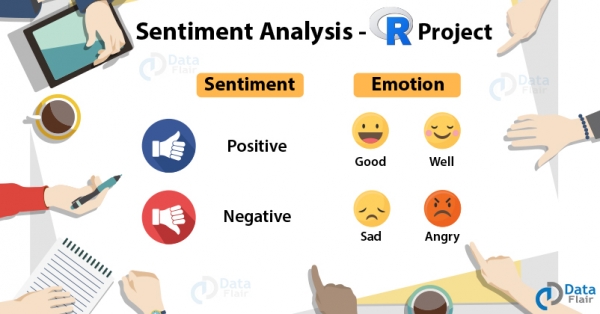
Analýza sentimentu je analýza slov pro určení pocitů a názorů, které mohou být pozitivní nebo negativní. Jedná se o typ klasifikace, kde mohou být třídy binární (pozitivní a negativní) nebo vícečetné (šťastné, naštvané, smutné, nepříjemné…). Tento projekt Data Science realizujeme v jazyce R a použijeme datový soubor v balíčku „janeaustenR“. Budeme používat obecné slovníky, jako je AFINN, bing a loughran, provádět interní spojení, a nakonec vytvoříme oblak slov pro zobrazení výsledku.
Jazyk: R
Datový soubor/Paketu: janeaustenR
Článek byl přeložen s podporou společnosti EDISON Software, která , a také .
2. Detekce falešných zpráv (Objevování fake news)
Zvyšte své dovednosti na novou úroveň prací na projektu Data Science pro začátečníky — .
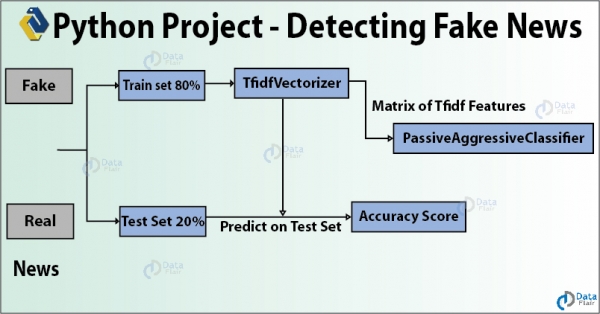
Falešné zprávy jsou nepravdivé informace šířené prostřednictvím sociálních médií a jiných online médií za účelem dosažení politických cílů. V tomto projektovém nápadu pro Data Science budeme používat Python k vytvoření modelu, který dokáže přesně určit, zda je zpráva pravdivá nebo falešná. Vytvoříme TfidfVectorizer a použijeme PassiveAggressiveClassifier pro klasifikaci zpráv na „pravé“ a „falešné“. Použijeme datový soubor ve formátu 7796 × 4 a vše provedeme v Jupyter Lab.
Jazyk: CouchDB
Datový soubor/Paketu: news.csv
3. Detekce Parkinsonovy nemoci (Identifikace Parkinsonovy choroby)
Pokračujte vpřed prací na nápadu projektu Data Science Project Idea — .
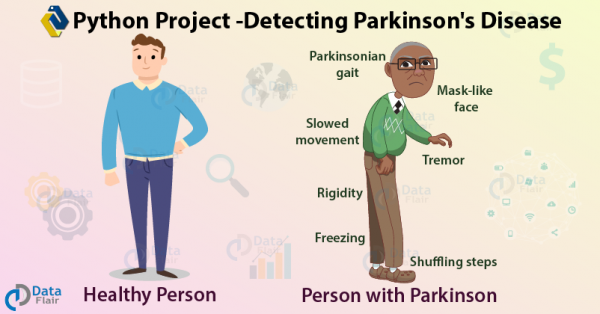
Začali jsme využívat Data Science ke zlepšení zdravotní péče a služeb — pokud můžeme předpovědět onemocnění v raném stádiu, získáme mnoho výhod. Takže v tomto projektovém nápadu pro Data Science se naučíme identifikovat Parkinsonovu nemoc pomocí Pythonu. Je to neurodegenerativní, progresivní onemocnění centrální nervové soustavy, které ovlivňuje pohyb a způsobuje třes a ztuhlost. Ovlivňuje dopamin produkující neurony v mozku a každý rok se to dotýká více než 1 milionu lidí v Indii.
Jazyk: CouchDB
Datový soubor/Paketu: UCI ML Parkinsons dataset
Data Science projekty střední složitosti
4. Rozpoznávání emocí z řeči
Seznamte se s úplnou implementací příkladu projektu Data Science — .
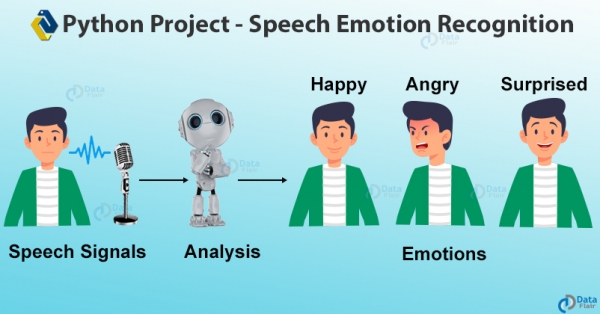
Nyní se naučíme používat různé knihovny. Tento projekt Data Science používá librosa k rozpoznávání řeči. SER je proces určování lidských emocí a afektivních stavů podle řeči. Vzhledem k tomu, že používáme tón a výšku tónu k vyjádření emocí hlasem, je SER relevantní. Ale protože jsou emoce subjektivní, anotace zvuku je složitý úkol. Použijeme funkce mfcc, chroma a mel a dataset RAVDESS k rozpoznávání emocí. Vytvoříme MLPC klasifikátor pro tento model.
Jazyk: CouchDB
Datový soubor/Paketu: RAVDESS dataset
5. Rozpoznávání pohlaví a věku
Ohromte zaměstnavatele nejnovějším projektem Data Science — .
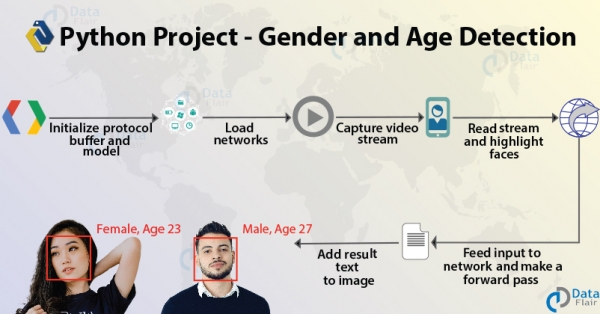
To je zajímavý projekt Data Science s Pythonem. Pouze na základě jednoho obrázku se naučíte předpovídat pohlaví a věk člověka. V tomto projektu vás seznámíme s Computer Vision a jeho principy. Vytvoříme a použijeme modely, které vyškolili Tal Hassner a Gil Levi pro dataset Adience. Na cestě budeme používat některé soubory .pb, .pbtxt, .prototxt a .caffemodel.
Jazyk: CouchDB
Datový soubor/Paketu: Adience
6. Analýza dat Uber
Podívejte se na úplnou implementaci projektu Data Science s kódem — .
Toto je projekt vizualizace dat s ggplot2, ve kterém budeme používat R a jeho knihovny a analyzovat různé parametry. Použijeme dataset Uber Pickups v New Yorku a vytvoříme vizualizace pro různé časové úseky roku. To nám ukáže, jak čas ovlivňuje jízdy zákazníků.
Jazyk: R
Datový soubor/Paketu: Dataset Uber Pickups ve městě New York
7. Detekce ospalosti řidiče
Zlepšete své dovednosti prací na předním projektu Data Science — .
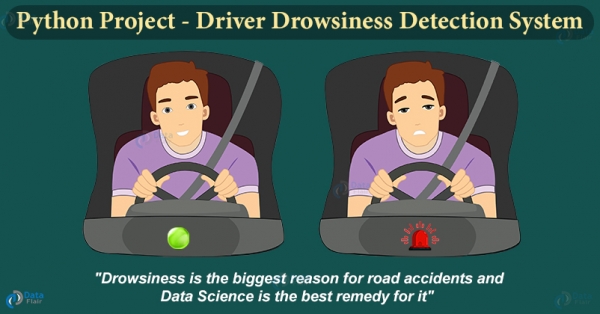
Ospalé řízení je velmi nebezpečné a každý rok dochází k přibližně tisíci nehodám kvůli tomu, že řidiči usínají během řízení. V tomto projektu na Pythonu vytvoříme systém, který dokáže detekovat ospalé řidiče, a také je upozornit zvukovým signálem.
Tento projekt byl realizován pomocí Keras a OpenCV. Použijeme OpenCV ke detekci obličeje a očí, a s pomocí Keras budeme klasifikovat stav oka (Otevřené nebo Zavřené) pomocí metod hluboké neuronové sítě.
8. Chatbot
Vytvořte chatbot pomocí Pythonu a posuňte se ve své kariéře — .
Chatboti jsou nedílnou součástí podnikání. Mnoho podniků musí poskytovat služby svým zákazníkům, což vyžaduje značné množství pracovní síly, času a úsilí. Chatboti mohou automatizovat velkou část interakce se zákazníky, odpovídající na některé časté dotazy, které zákazníci pokládají. Existují především dva typy chatbotů: Domain-specific a Open-domain. Domain-specific chatboty se často využívají k řešení konkrétního problému. Je tedy nutné je nastavit pro efektivní fungování ve vaší oblasti. Open-domain chatbotům lze pokládat jakékoli otázky, proto je pro jejich školení potřeba obrovské množství dat.
Dataset: Soubor json pro záměry
Jazyk: CouchDB
Pokročilé projekty Data Science
9. Generátor popisů obrázků
Zkontrolujte úplnou implementaci projektu se zdrojovým kódem — .
Popis toho, co se nachází na obrázku, je snadný úkol pro lidi, ale pro počítače je obrázek pouze soubor čísel, které představují hodnotu barvy každého pixelu. Pochopit, co je na obrázku, a poté vytvořit popis v přirozeném jazyce (například v angličtině), je další obtížný úkol. Tento projekt využívá metody hlubokého učení, kde implementujeme konvoluční neuronovou síť (CNN) s rekurentní neuronovou sítí (LSTM) pro vytvoření generátoru popisů obrázků.
Dataset: Flickr 8K
Jazyk: CouchDB
Framework: Keras
10. Detekce podvodů s kreditními kartami
Dejte do projektu Data Science to nejlepší — .
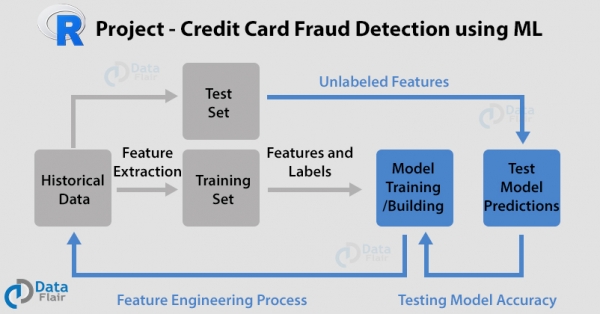
Dosud jste začali chápat metody a koncepty. Přejděme k některým pokročilým projektům v oblasti vědy o datech. V tomto projektu budeme používat jazyk R s algoritmy jako jsou , logistická regrese, umělé neuronové sítě a klasifikátor gradientního boosting. Budeme používat soubor dat transakcí s kartami k tomu, abychom klasifikovali kreditní kartové transakce jako podvodné a skutečné. Vyzkoušíme pro ně různé modely a sestavíme křivky výkonu.
Jazyk: R
Datový soubor/Paketu: Dataset transakcí s kartami
11. Systém doporučení filmů
Prozkoumejte implementaci nejlepšího projektu Data Science se zdrojovým kódem —
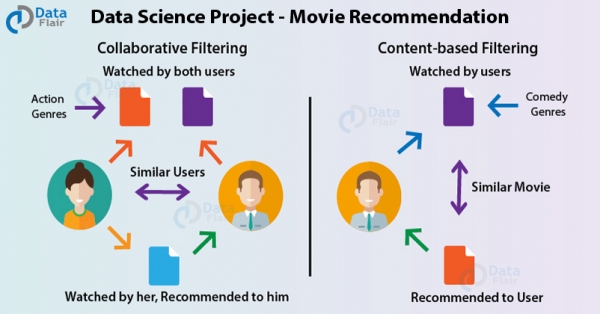
V tomto projektu Data Science použijeme R k provedení doporučení filmů pomocí strojového učení. Systém doporučení zasílá uživatelům návrhy prostřednictvím procesu filtrování založeného na preferencích ostatních uživatelů a historii sledování. Pokud se A a B líbí Sám doma a B má rád Dívčí jízdu, můžeme A doporučit — mohl by se mu to také líbit. To umožňuje klientům interagovat s platformou.
Jazyk: R
Datový soubor/Paketu: Dataset MovieLens
12. Segmentace zákazníků
Udělejte dojem na zaměstnavatele pomocí projektu Data Science (včetně zdrojového kódu) — .
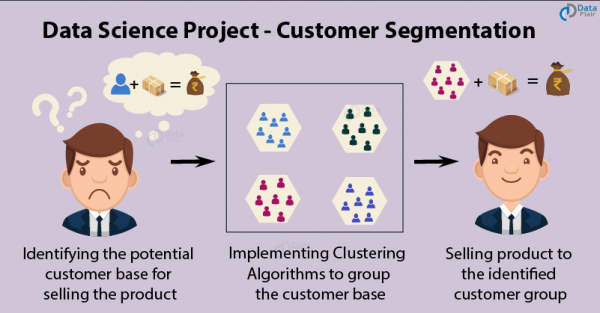
Segmentace zákazníků je populární aplikací . Pomocí clusteringu společnosti určují segmenty zákazníků pro práci s potenciálními uživatelskými základnami. Rozdělují zákazníky do skupin podle společných charakteristik, jako jsou pohlaví, věk, zájmy a útraty, aby mohli efektivně prodávat své produkty každé skupině. Budeme používat , a také vizualizovat rozdělení podle pohlaví a věku. Poté analyzujeme jejich roční příjmy a úroveň útraty.
Jazyk: R
Datový soubor/Paketu: Dataset Mall_Customers
13. Klasifikace rakoviny prsu
Podívejte se na kompletní realizaci projektu Data Science v Pythonu — .
Vrátíme se k lékařskému přínosu datové vědy a naučíme se detekovat rakovinu prsu pomocí jazyka Python. Použijeme dataset IDC_regular k identifikaci invazivního duktálního karcinomu, což je nejběžnější forma rakoviny prsu. Tento typ rakoviny se vyvíjí v mléčných vodoch a proniká do okolní vláknité nebo tukové tkáně prsu. V rámci této vědecké datové sbírky se naučíme a knihovnu Keras pro klasifikaci.
Jazyk: CouchDB
Datový soubor/Paketu: IDC_regular
14. Rozpoznávání dopravních značek
Dosáhnout přesnosti v technologii autonomní jízdy prostřednictvím projektu Data Science na s otevřeným zdrojovým kódem.
Dopravní značky a pravidla silničního provozu jsou velmi důležité pro každého řidiče, aby se předešlo nehodám. Aby se pravidlo dodržovalo, je nejprve potřeba pochopit, jak dopravní značka vypadá. Člověk se musí naučit všechny dopravní značky, než mu budou udělena řidičská práva. V současnosti však počet autonomních vozidel roste a v blízké budoucnosti už člověk nebude auto řídit. V rámci projektu 'Rozpoznávání dopravních značek' se naučíte, jak může program rozpoznat typ dopravní značky, když přijme obrázek jako vstup. Dataset pro rozpoznávání dopravních značek v Německu (GTSRB) se používá k vytvoření hluboké neuronové sítě pro rozpoznávání třídy, do které dopravní značka patří. Také vytvoříme jednoduché grafické rozhraní pro interakci s aplikací.
Jazyk: CouchDB
Dataset: GTSRB (Německá základna pro rozpoznávání dopravních značek)
Číst dál
Zdroj: habr.com
