

V současné době se REST API stalo standardem pro vývoj webových aplikací, což umožňuje rozdělit vývoj na nezávislé části. Pro UI se v současnosti používají různé populární frameworky, jako jsou Angular, React, Vue a další. Vývojáři backendu si mohou vybrat z široké škály jazyků a frameworků. Dnes bych chtěl hovořit o frameworku jako . My v aktivně využíváme pro interní projekty. Použitím nest a balíčku , vytvoříme jednoduchou CRUD aplikaci.
Proč NestJS
V poslední době se v JavaScript komunitě objevilo mnoho backend frameworků. A ačkoliv co se týče funkcionality nabízejí podobné možnosti jako Nest, v jednom určitě vítězí — je to architektura. Následující vlastnosti NestJS umožňují vytvářet průmyslové aplikace a škálovat vývoj na velké týmy:
- používání TypeScript jako hlavního jazyka vývoje. Ačkoliv NestJS podporuje JavaScript, některé funkce nemusí fungovat, zejména pokud jde o externí balíčky;
- přítomnost DI kontejneru, což umožňuje vytvářet slabě spojené komponenty;
- funkcionalita samotného frameworku je rozdělena na nezávislé vzájemně vyměnitelné komponenty. Například může být jako framework používán jak , tak i , pro práci s databází nest z krabice poskytuje vazby na , , ;
- NestJS není závislé na platformě a podporuje REST, GraphQL, Websockets, gRPC atd.
Samotný framework je inspirován frontend frameworkem Angular a konceptuálně má s ním mnoho společného.
Instalace NestJS a nasazení projektu
Nest obsahuje balíček /cli, который позволяет быстро развернуть базовый каркас приложения. Установим глобально данный пакет:
npm install --global @nest/cliPo instalaci vygenerujeme základní kostru naší aplikace s názvem nest-rest. To se provádí pomocí příkazu nest new nest-rest.
nest new nest-rest
dmitrii@dmitrii-HP-ZBook-17-G3:~\/projects $ nest new nest-rest
  Vaše aplikace bude vytvořena za pár sekund..

CREATE \/nest-rest\/.prettierrc (51 bytes)
CREATE \/nest-rest\/README.md (3370 bytes)
CREATE \/nest-rest\/nest-cli.json (84 bytes)
CREATE \/nest-rest\/nodemon-debug.json (163 bytes)
CREATE \/nest-rest\/nodemon.json (67 bytes)
CREATE \/nest-rest\/package.json (1805 bytes)
CREATE \/nest-rest\/tsconfig.build.json (97 bytes)
CREATE \/nest-rest\/tsconfig.json (325 bytes)
CREATE \/nest-rest\/tslint.json (426 bytes)
CREATE \/nest-rest\/src\/app.controller.spec.ts (617 bytes)
CREATE \/nest-rest\/src\/app.controller.ts (274 bytes)
CREATE \/nest-rest\/src\/app.module.ts (249 bytes)
CREATE \/nest-rest\/src\/app.service.ts (142 bytes)
CREATE \/nest-rest\/src\/main.ts (208 bytes)
CREATE \/nest-rest\/test\/app.e2e-spec.ts (561 bytes)
CREATE \/nest-rest\/test\/jest-e2e.json (183 bytes)

? Který balíčkovací manažer byste chtěli použít? yarn
 Instalace probíhá...

  Projekt nest-rest byl úspěšně vytvořen
  Začněte s následujícími příkazy:

$ cd nest-rest
$ yarn run start

                          Děkujeme za instalaci Nest
                 Zvažte, prosím, darování na náš otevřený kolektiv
                        abyste nám pomohli udržovat tento balíček.

                 Darujte: https:\/\/opencollective.com\/nest
Jako balíčkovací manažer vybereme yarn.
V tuto chvíli můžete spustit server příkazem npm start a přejít na adresu můžete vidět domovskou stránku. Ale nejsme zde pouze kvůli tomu a pokračujeme dále.
Nastavujeme práci s databází
Jako SGBD pro tento článek jsem si vybral PostgreSQL. O chutích se nediskutuje, podle mě je to nejvyspělejší SGBD, s veškerými potřebnými funkcemi. Jak již bylo uvedeno, Nest poskytuje integraci s různými balíčky pro práci s databázemi. Protože jsem zvolil PostgreSQL, bylo by logické zvolit TypeORM jako ORM. Nainstalujme potřebné balíčky pro integraci s databází:
yarn add typeorm @nestjs\/typeorm pg
Postupně, k čemu je každý balíček:
- typeorm — balíček přímo s ORM;
- @nestjs\/typeorm — TypeORM balíček pro NestJS. Přidává moduly pro importování do projektových modulů, stejně jako sadu pomocných dekorátorů;
- pg — ovladač pro práci s PostgreSQL.
Dobře, balíčky byly nainstalovány, nyní je potřeba spustit samotnou databázi. Pro nasazení databáze budu používat docker-compose.yml následujícího obsahu:
docker-compose.yml
version: '3.1'

services:
  db:
    image: postgres:11.2
    restart: always
    environment:
      POSTGRES_PASSWORD: example
    volumes:
      - ..\/db:\/var\/lib\/postgresql\/data
      - .\/postgresql.conf:\/etc\/postgresql\/postgresql.conf
    ports:
      - 5432:5432
  adminer:
    image: adminer
    restart: always
    ports:
      - 8080:8080
Jak je vidět, tento soubor konfiguruje spuštění 2 kontejnerů:
- db — to je kontejner přímo s databází. V našem případě se používá postgresql verze 11.2;
- adminer — správce pro práci s databází. Poskytuje webové rozhraní pro prohlížení a správu databáze.
Pro práci s TCP připojeními jsem přidal konfiguraci následujícího obsahu.
postgresql.conf
# -----------------------------
# PostgreSQL configuration file
# -----------------------------
#
# This file consists of lines of the form:
#
# name = value
#
# (The "=" is optional.) Whitespace may be used. Comments are introduced with
# "#" anywhere on a line. The complete list of parameter names and allowed
# values can be found in the PostgreSQL documentation.
#
# The commented-out settings shown in this file represent the default values.
# Re-commenting a setting is NOT sufficient to revert it to the default value;
# you need to reload the server.
#
# This file is read on server startup and when the server receives a SIGHUP
# signal. If you edit the file on a running system, you have to SIGHUP the
# server for the changes to take effect, run "pg_ctl reload", or execute
# "SELECT pg_reload_conf()". Some parameters, which are marked below,
# require a server shutdown and restart to take effect.
#
# Any parameter can also be given as a command-line option to the server, e.g.,
# "postgres -c log_connections=on". Some parameters can be changed at run time
# with the "SET" SQL command.
#
# Memory units: kB = kilobytes Time units: ms = milliseconds
# MB = megabytes s = seconds
# GB = gigabytes min = minutes
# TB = terabytes h = hours
# d = days
#------------------------------------------------------------------------------
# FILE LOCATIONS
#------------------------------------------------------------------------------
# The default values of these variables are driven from the -D command-line
# option or PGDATA environment variable, represented here as ConfigDir.
#data_directory = 'ConfigDir' # use data in another directory
# (change requires restart)
#hba_file = 'ConfigDir/pg_hba.conf' # host-based authentication file
# (change requires restart)
#ident_file = 'ConfigDir/pg_ident.conf' # ident configuration file
# (change requires restart)
# If external_pid_file is not explicitly set, no extra PID file is written.
#external_pid_file = '' # write an extra PID file
# (change requires restart)
#------------------------------------------------------------------------------
# CONNECTIONS AND AUTHENTICATION
#------------------------------------------------------------------------------
# - Connection Settings -
listen_addresses = '*'
#listen_addresses = 'localhost' # what IP address(es) to listen on;
# comma-separated list of addresses;
# defaults to 'localhost'; use '*' for all
# (change requires restart)
#port = 5432 # (change requires restart)
#max_connections = 100 # (change requires restart)
#superuser_reserved_connections = 3 # (change requires restart)
#unix_socket_directories = '/tmp' # comma-separated list of directories
# (change requires restart)
#unix_socket_group = '' # (change requires restart)
#unix_socket_permissions = 0777 # begin with 0 to use octal notation
# (change requires restart)
#bonjour = off # advertise server via Bonjour
# (change requires restart)
#bonjour_name = '' # defaults to the computer name
# (change requires restart)
# - TCP Keepalives -
# see "man 7 tcp" for details
#tcp_keepalives_idle = 0 # TCP_KEEPIDLE, in seconds;
# 0 selects the system default
#tcp_keepalives_interval = 0 # TCP_KEEPINTVL, in seconds;
# 0 selects the system default
#tcp_keepalives_count = 0 # TCP_KEEPCNT;
# 0 selects the system default
# - Authentication -
#authentication_timeout = 1min # 1s-600s
#password_encryption = md5 # md5 or scram-sha-256
#db_user_namespace = off
# GSSAPI using Kerberos
#krb_server_keyfile = ''
#krb_caseins_users = off
# - SSL -
#ssl = off
#ssl_ca_file = ''
#ssl_cert_file = 'server.crt'
#ssl_crl_file = ''
#ssl_key_file = 'server.key'
#ssl_ciphers = 'HIGH:MEDIUM:+3DES:!aNULL' # allowed SSL ciphers
#ssl_prefer_server_ciphers = on
#ssl_ecdh_curve = 'prime256v1'
#ssl_min_protocol_version = 'TLSv1'
#ssl_max_protocol_version = ''
#ssl_dh_params_file = ''
#ssl_passphrase_command = ''
#ssl_passphrase_command_supports_reload = off
#------------------------------------------------------------------------------
# RESOURCE USAGE (except WAL)
#------------------------------------------------------------------------------
# - Memory -
#shared_buffers = 32MB # min 128kB
# (change requires restart)
#huge_pages = try # on, off, or try
# (change requires restart)
#temp_buffers = 8MB # min 800kB
#max_prepared_transactions = 0 # zero disables the feature
# (change requires restart)
# Caution: it is not advisable to set max_prepared_transactions nonzero unless
# you actively intend to use prepared transactions.
#work_mem = 4MB # min 64kB
#maintenance_work_mem = 64MB # min 1MB
#autovacuum_work_mem = -1 # min 1MB, or -1 to use maintenance_work_mem
#max_stack_depth = 2MB # min 100kB
#shared_memory_type = mmap # the default is the first option
# supported by the operating system:
# mmap
# sysv
# windows
# (change requires restart)
#dynamic_shared_memory_type = posix # the default is the first option
# supported by the operating system:
# posix
# sysv
# windows
# mmap
# (change requires restart)
# - Disk -
#temp_file_limit = -1 # limits per-process temp file space
# in kB, or -1 for no limit
# - Kernel Resources -
#max_files_per_process = 1000 # min 25
# (change requires restart)
# - Cost-Based Vacuum Delay -
#vacuum_cost_delay = 0 # 0-100 milliseconds (0 disables)
#vacuum_cost_page_hit = 1 # 0-10000 credits
#vacuum_cost_page_miss = 10 # 0-10000 credits
#vacuum_cost_page_dirty = 20 # 0-10000 credits
#vacuum_cost_limit = 200 # 1-10000 credits
# - Background Writer -
#bgwriter_delay = 200ms # 10-10000ms between rounds
#bgwriter_lru_maxpages = 100 # max buffers written/round, 0 disables
#bgwriter_lru_multiplier = 2.0 # 0-10.0 multiplier on buffers scanned/round
#bgwriter_flush_after = 0 # measured in pages, 0 disables
# - Asynchronous Behavior -
#effective_io_concurrency = 1 # 1-1000; 0 disables prefetching
#max_worker_processes = 8 # (change requires restart)
#max_parallel_maintenance_workers = 2 # taken from max_parallel_workers
#max_parallel_workers_per_gather = 2 # taken from max_parallel_workers
#parallel_leader_participation = on
#max_parallel_workers = 8 # maximum number of max_worker_processes that
# can be used in parallel operations
#old_snapshot_threshold = -1 # 1min-60d; -1 disables; 0 is immediate
# (change requires restart)
#backend_flush_after = 0 # measured in pages, 0 disables
#------------------------------------------------------------------------------
# WRITE-AHEAD LOG
#------------------------------------------------------------------------------
# - Settings -
#wal_level = replica # minimal, replica, or logical
# (change requires restart)
#fsync = on # flush data to disk for crash safety
# (turning this off can cause
# unrecoverable data corruption)
#synchronous_commit = on # synchronization level;
# off, local, remote_write, remote_apply, or on
#wal_sync_method = fsync # the default is the first option
# supported by the operating system:
# open_datasync
# fdatasync (default on Linux)
# fsync
# fsync_writethrough
# open_sync
#full_page_writes = on # recover from partial page writes
#wal_compression = off # enable compression of full-page writes
#wal_log_hints = off # also do full page writes of non-critical updates
# (change requires restart)
#wal_buffers = -1 # min 32kB, -1 sets based on shared_buffers
# (change requires restart)
#wal_writer_delay = 200ms # 1-10000 milliseconds
#wal_writer_flush_after = 1MB # measured in pages, 0 disables
#commit_delay = 0 # range 0-100000, in microseconds
#commit_siblings = 5 # range 1-1000
# - Checkpoints -
#checkpoint_timeout = 5min # range 30s-1d
#max_wal_size = 1GB
#min_wal_size = 80MB
#checkpoint_completion_target = 0.5 # checkpoint target duration, 0.0 - 1.0
#checkpoint_flush_after = 0 # measured in pages, 0 disables
#checkpoint_warning = 30s # 0 disables
# - Archiving -
#archive_mode = off # enables archiving; off, on, or always
# (change requires restart)
#archive_command = '' # command to use to archive a logfile segment
# placeholders: %p = path of file to archive
# %f = file name only
# e.g. 'test ! -f /mnt/server/archivedir/%f && cp %p /mnt/server/archivedir/%f'
#archive_timeout = 0 # force a logfile segment switch after this
# number of seconds; 0 disables
# - Archive Recovery -
# These are only used in recovery mode.
#restore_command = '' # command to use to restore an archived logfile segment
# placeholders: %p = path of file to restore
# %f = file name only
# e.g. 'cp /mnt/server/archivedir/%f %p'
# (change requires restart)
#archive_cleanup_command = '' # command to execute at every restartpoint
#recovery_end_command = '' # command to execute at completion of recovery
# - Recovery Target -
# Set these only when performing a targeted recovery.
#recovery_target = '' # 'immediate' to end recovery as soon as a
# consistent state is reached
# (change requires restart)
#recovery_target_name = '' # the named restore point to which recovery will proceed
# (change requires restart)
#recovery_target_time = '' # the time stamp up to which recovery will proceed
# (change requires restart)
#recovery_target_xid = '' # the transaction ID up to which recovery will proceed
# (change requires restart)
#recovery_target_lsn = '' # the WAL LSN up to which recovery will proceed
# (change requires restart)
#recovery_target_inclusive = on # Specifies whether to stop:
# just after the specified recovery target (on)
# just before the recovery target (off)
# (change requires restart)
#recovery_target_timeline = 'latest' # 'current', 'latest', or timeline ID
# (change requires restart)
#recovery_target_action = 'pause' # 'pause', 'promote', 'shutdown'
# (change requires restart)
#------------------------------------------------------------------------------
# REPLICATION
#------------------------------------------------------------------------------
# - Sending Servers -
# Set these on the master and on any standby that will send replication data.
#max_wal_senders = 10 # max number of walsender processes
# (change requires restart)
#wal_keep_segments = 0 # in logfile segments; 0 disables
#wal_sender_timeout = 60s # in milliseconds; 0 disables
#max_replication_slots = 10 # max number of replication slots
# (change requires restart)
#track_commit_timestamp = off # collect timestamp of transaction commit
# (change requires restart)
# - Master Server -
# These settings are ignored on a standby server.
#synchronous_standby_names = '' # standby servers that provide sync rep
# method to choose sync standbys, number of sync standbys,
# and comma-separated list of application_name
# from standby(s); '*' = all
#vacuum_defer_cleanup_age = 0 # number of xacts by which cleanup is delayed
# - Standby Servers -
# These settings are ignored on a master server.
#primary_conninfo = '' # connection string to sending server
# (change requires restart)
#primary_slot_name = '' # replication slot on sending server
# (change requires restart)
#promote_trigger_file = '' # file name whose presence ends recovery
#hot_standby = on # "off" disallows queries during recovery
# (change requires restart)
#max_standby_archive_delay = 30s # max delay before canceling queries
# when reading WAL from archive;
# -1 allows indefinite delay
#max_standby_streaming_delay = 30s # max delay before canceling queries
# when reading streaming WAL;
# -1 allows indefinite delay
#wal_receiver_status_interval = 10s # send replies at least this often
# 0 disables
#hot_standby_feedback = off # send info from standby to prevent
# query conflicts
#wal_receiver_timeout = 60s # time that receiver waits for
# communication from master
# in milliseconds; 0 disables
#wal_retrieve_retry_interval = 5s # time to wait before retrying to
# retrieve WAL after a failed attempt
#recovery_min_apply_delay = 0 # minimum delay for applying changes during recovery
# - Subscribers -
# These settings are ignored on a publisher.
#max_logical_replication_workers = 4 # taken from max_worker_processes
# (change requires restart)
#max_sync_workers_per_subscription = 2 # taken from max_logical_replication_workers
#------------------------------------------------------------------------------
# QUERY TUNING
#------------------------------------------------------------------------------
# - Planner Method Configuration -
#enable_bitmapscan = on
#enable_hashagg = on
#enable_hashjoin = on
#enable_indexscan = on
#enable_indexonlyscan = on
#enable_material = on
#enable_mergejoin = on
#enable_nestloop = on
#enable_parallel_append = on
#enable_seqscan = on
#enable_sort = on
#enable_tidscan = on
#enable_partitionwise_join = off
#enable_partitionwise_aggregate = off
#enable_parallel_hash = on
#enable_partition_pruning = on
# - Planner Cost Constants -
#seq_page_cost = 1.0 # measured on an arbitrary scale
#random_page_cost = 4.0 # same scale as above
#cpu_tuple_cost = 0.01 # same scale as above
#cpu_index_tuple_cost = 0.005 # same scale as above
#cpu_operator_cost = 0.0025 # same scale as above
#parallel_tuple_cost = 0.1 # same scale as above
#parallel_setup_cost = 1000.0 # same scale as above
#jit_above_cost = 100000 # perform JIT compilation if available
# and query more expensive than this;
# -1 disables
#jit_inline_above_cost = 500000 # inline small functions if query is
# more expensive than this; -1 disables
#jit_optimize_above_cost = 500000 # use expensive JIT optimizations if
# query is more expensive than this;
# -1 disables
#min_parallel_table_scan_size = 8MB
#min_parallel_index_scan_size = 512kB
#effective_cache_size = 4GB
# - Genetic Query Optimizer -
#geqo = on
#geqo_threshold = 12
#geqo_effort = 5 # range 1-10
#geqo_pool_size = 0 # selects default based on effort
#geqo_generations = 0 # selects default based on effort
#geqo_selection_bias = 2.0 # range 1.5-2.0
#geqo_seed = 0.0 # range 0.0-1.0
# - Other Planner Options -
#default_statistics_target = 100 # range 1-10000
#constraint_exclusion = partition # on, off, or partition
#cursor_tuple_fraction = 0.1 # range 0.0-1.0
#from_collapse_limit = 8
#join_collapse_limit = 8 # 1 disables collapsing of explicit
# JOIN clauses
#force_parallel_mode = off
#jit = on # allow JIT compilation
#plan_cache_mode = auto # auto, force_generic_plan or
# force_custom_plan
#------------------------------------------------------------------------------
# REPORTING AND LOGGING
#------------------------------------------------------------------------------
# - Where to Log -
#log_destination = 'stderr' # Valid values are combinations of
# stderr, csvlog, syslog, and eventlog,
# depending on platform. csvlog
# requires logging_collector to be on.
# This is used when logging to stderr:
#logging_collector = off # Enable capturing of stderr and csvlog
# into log files. Required to be on for
# csvlogs.
# (change requires restart)
# These are only used if logging_collector is on:
#log_directory = 'log' # directory where log files are written,
# can be absolute or relative to PGDATA
#log_filename = 'postgresql-%Y-%m-%d_%H%M%S.log' # log file name pattern,
# can include strftime() escapes
#log_file_mode = 0600 # creation mode for log files,
# begin with 0 to use octal notation
#log_truncate_on_rotation = off # If on, an existing log file with the
# same name as the new log file will be
# truncated rather than appended to.
# But such truncation only occurs on
# time-driven rotation, not on restarts
# or size-driven rotation. Default is
# off, meaning append to existing files
# in all cases.
#log_rotation_age = 1d # Automatic rotation of logfiles will
# happen after that time. 0 disables.
#log_rotation_size = 10MB # Automatic rotation of logfiles will
# happen after that much log output.
# 0 disables.
# These are relevant when logging to syslog:
#syslog_facility = 'LOCAL0'
#syslog_ident = 'postgres'
#syslog_sequence_numbers = on
#syslog_split_messages = on
# This is only relevant when logging to eventlog (win32):
# (change requires restart)
#event_source = 'PostgreSQL'
# - When to Log -
#log_min_messages = warning # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic
#log_min_error_statement = error # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# info
# notice
# warning
# error
# log
# fatal
# panic (effectively off)
#log_min_duration_statement = -1 # logs statements and their durations
# according to log_statement_sample_rate. -1 is disabled,
# 0 logs all statement, > 0 logs only statements running at
# least this number of milliseconds.
#log_statement_sample_rate = 1 # Fraction of logged statements over
# log_min_duration_statement. 1.0 logs all statements,
# 0 never logs.
# - What to Log -
#debug_print_parse = off
#debug_print_rewritten = off
#debug_print_plan = off
#debug_pretty_print = on
#log_checkpoints = off
#log_connections = off
#log_disconnections = off
#log_duration = off
#log_error_verbosity = default # terse, default, or verbose messages
#log_hostname = off
#log_line_prefix = '%m [%p] ' # special values:
# %a = application name
# %u = user name
# %d = database name
# %r = remote host and port
# %h = remote host
# %p = process ID
# %t = timestamp without milliseconds
# %m = timestamp with milliseconds
# %n = timestamp with milliseconds (as a Unix epoch)
# %i = command tag
# %e = SQL state
# %c = session ID
# %l = session line number
# %s = session start timestamp
# %v = virtual transaction ID
# %x = transaction ID (0 if none)
# %q = stop here in non-session
# processes
# %% = '%'
# e.g. '<%u%%%d> '
#log_lock_waits = off # log lock waits >= deadlock_timeout
#log_statement = 'none' # none, ddl, mod, all
#log_replication_commands = off
#log_temp_files = -1 # log temporary files equal or larger
# than the specified size in kilobytes;
# -1 disables, 0 logs all temp files
#log_timezone = 'GMT'
#------------------------------------------------------------------------------
# PROCESS TITLE
#------------------------------------------------------------------------------
#cluster_name = '' # added to process titles if nonempty
# (change requires restart)
#update_process_title = on
#------------------------------------------------------------------------------
# STATISTICS
#------------------------------------------------------------------------------
# - Query and Index Statistics Collector -
#track_activities = on
#track_counts = on
#track_io_timing = off
#track_functions = none # none, pl, all
#track_activity_query_size = 1024 # (change requires restart)
#stats_temp_directory = 'pg_stat_tmp'
# - Monitoring -
#log_parser_stats = off
#log_planner_stats = off
#log_executor_stats = off
#log_statement_stats = off
#------------------------------------------------------------------------------
# AUTOVACUUM
#------------------------------------------------------------------------------
#autovacuum = on # Enable autovacuum subprocess? 'on'
# requires track_counts to also be on.
#log_autovacuum_min_duration = -1 # -1 disables, 0 logs all actions and
# their durations, > 0 logs only
# actions running at least this number
# of milliseconds.
#autovacuum_max_workers = 3 # max number of autovacuum subprocesses
# (change requires restart)
#autovacuum_naptime = 1min # time between autovacuum runs
#autovacuum_vacuum_threshold = 50 # min number of row updates before
# vacuum
#autovacuum_analyze_threshold = 50 # min number of row updates before
# analyze
#autovacuum_vacuum_scale_factor = 0.2 # fraction of table size before vacuum
#autovacuum_analyze_scale_factor = 0.1 # fraction of table size before analyze
#autovacuum_freeze_max_age = 200000000 # maximum XID age before forced vacuum
# (change requires restart)
#autovacuum_multixact_freeze_max_age = 400000000 # maximum multixact age
# before forced vacuum
# (change requires restart)
#autovacuum_vacuum_cost_delay = 2ms # default vacuum cost delay for
# autovacuum, in milliseconds;
# -1 means use vacuum_cost_delay
#autovacuum_vacuum_cost_limit = -1 # default vacuum cost limit for
# autovacuum, -1 means use
# vacuum_cost_limit
#------------------------------------------------------------------------------
# CLIENT CONNECTION DEFAULTS
#------------------------------------------------------------------------------
# - Statement Behavior -
#client_min_messages = notice # values in order of decreasing detail:
# debug5
# debug4
# debug3
# debug2
# debug1
# log
# notice
# warning
# error
#search_path = '"$user", public' # schema names
#row_security = on
#default_tablespace = '' # a tablespace name, '' uses the default
#temp_tablespaces = '' # a list of tablespace names, '' uses
# only default tablespace
#check_function_bodies = on
#default_transaction_isolation = 'read committed'
#default_transaction_read_only = off
#default_transaction_deferrable = off
#session_replication_role = 'origin'
#statement_timeout = 0 # in milliseconds, 0 is disabled
#lock_timeout = 0 # in milliseconds, 0 is disabled
#idle_in_transaction_session_timeout = 0 # in milliseconds, 0 is disabled
#vacuum_freeze_min_age = 50000000
#vacuum_freeze_table_age = 150000000
#vacuum_multixact_freeze_min_age = 5000000
#vacuum_multixact_freeze_table_age = 150000000
#vacuum_cleanup_index_scale_factor = 0.1 # fraction of total number of tuples
# before index cleanup, 0 always performs
# index cleanup
#bytea_output = 'hex' # hex, escape
#xmlbinary = 'base64'
#xmloption = 'content'
#gin_fuzzy_search_limit = 0
#gin_pending_list_limit = 4MB
# - Locale and Formatting -
#datestyle = 'iso, mdy'
#intervalstyle = 'postgres'
#timezone = 'GMT'
#timezone_abbreviations = 'Default' # Select the set of available time zone
# abbreviations. Currently, there are
# Default
# Australia (historical usage)
# India
# You can create your own file in
# share/timezonesets/.
#extra_float_digits = 1 # min -15, max 3; any value >0 actually
# selects precise output mode
#client_encoding = sql_ascii # actually, defaults to database
# encoding
# These settings are initialized by initdb, but they can be changed.
#lc_messages = 'C' # locale for system error message
# strings
#lc_monetary = 'C' # locale for monetary formatting
#lc_numeric = 'C' # locale for number formatting
#lc_time = 'C' # locale for time formatting
# default configuration for text search
#default_text_search_config = 'pg_catalog.simple'
# - Shared Library Preloading -
#shared_preload_libraries = '' # (change requires restart)
#local_preload_libraries = ''
#session_preload_libraries = ''
#jit_provider = 'llvmjit' # JIT library to use
# - Other Defaults -
#dynamic_library_path = '$libdir'
#------------------------------------------------------------------------------
# LOCK MANAGEMENT
#------------------------------------------------------------------------------
#deadlock_timeout = 1s
#max_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_transaction = 64 # min 10
# (change requires restart)
#max_pred_locks_per_relation = -2 # negative values mean
# (max_pred_locks_per_transaction
# / -max_pred_locks_per_relation) - 1
#max_pred_locks_per_page = 2 # min 0
#------------------------------------------------------------------------------
# VERSION AND PLATFORM COMPATIBILITY
#------------------------------------------------------------------------------
# - Previous PostgreSQL Versions -
#array_nulls = on
#backslash_quote = safe_encoding # on, off, or safe_encoding
#escape_string_warning = on
#lo_compat_privileges = off
#operator_precedence_warning = off
#quote_all_identifiers = off
#standard_conforming_strings = on
#synchronize_seqscans = on
# - Other Platforms and Clients -
#transform_null_equals = off
#------------------------------------------------------------------------------
# ERROR HANDLING
#------------------------------------------------------------------------------
#exit_on_error = off # terminate session on any error?
#restart_after_crash = on # reinitialize after backend crash?
#data_sync_retry = off # retry or panic on failure to fsync
# data?
# (change requires restart)
#------------------------------------------------------------------------------
# CONFIG FILE INCLUDES
#------------------------------------------------------------------------------
# These options allow settings to be loaded from files other than the
# default postgresql.conf.
#include_dir = 'conf.d' # include files ending in '.conf' from
# directory 'conf.d'
#include_if_exists = 'exists.conf' # include file only if it exists
#include = 'special.conf' # include file
#------------------------------------------------------------------------------
# CUSTOMIZED OPTIONS
#------------------------------------------------------------------------------
# Add settings for extensions hereNa tom je vše, můžete spustit kontejnery příkazem docker-compose up -d. Nebo v samostatném terminálu pouhým příkazem docker-compose up.
Takže jsme nainstalovali balíčky, spustili databázi a zbývá je propojit. K tomu je potřeba přidat do kořenového adresáře projektu soubor ormconfig.js s následujícím obsahem:
ormconfig.js
const process = require('process');

const username = process.env.POSTGRES_USER || "postgres";
const password = process.env.POSTGRES_PASSWORD || "example";

module.exports = {
  "type": "postgres",
  "host": "localhost",
  "port": 5432,
  username,
  password,
  "database": "postgres",
  "synchronize": true,
  "dropSchema": false,
  "logging": true,
  "entities": [__dirname + "\/src\/**/*.entity.ts", __dirname + "\/dist\/**/*.entity.js"],
  "migrations": ["migrations\/**/*.ts"],
  "subscribers": ["subscriber\/**/*.ts", "dist\/subscriber\/**/*.js"],
  "cli": {
    "entitiesDir": "src",
    "migrationsDir": "migrations",
    "subscribersDir": "subscriber"
  }
}
Tato konfigurace bude použita pro CLI typeorm.
Podívejme se na tuto konfiguraci podrobněji. V řádcích 3 a 4 získáváme uživatelské jméno a heslo z proměnných prostředí. To je užitečné, když máte několik prostředí (dev, stage, prod, atd.). Přes default je uživatelské jméno postgres, heslo — example. Jinak je konfigurace triviální, a proto se zastavíme jen u nejzajímavějších parametrů:
- synchronize — určuje, zda by měla být databázová schéma automaticky vytvořena při spuštění aplikace. Buďte opatrní s touto volbou a nepoužívejte ji v produkčním prostředí, jinak ztratíte data. Tato možnost je užitečná při vývoji a ladění aplikace. Jako alternativu této možnosti můžete použít příkaz
schema:syncz CLI TypeORM. - dropSchema — resetovat schéma pokaždé, když se připojí. Stejně jako předchozí možnost by měla být používána pouze při vývoji a ladění aplikace.
- entities — podle jakých cest hledat popis modelů. Všimněte si, že vyhledávání podle masky je podporováno.
- cli.entitiesDir — adresář, do kterého by se měly standardně ukládat modely vytvořené z CLI TypeORM.
Abychom mohli využít všechny možnosti TypeORM v naší aplikaci Nest, je nutné importovat modul TypeOrmModule v AppModule. Tedy váš AppModule bude vypadat následovně:
app.module.ts
import { Module } from '@nestjs/common';
import { AppController } from './app.controller';
import { AppService } from './app.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import * as process from "process";

const username = process.env.POSTGRES_USER || 'postgres';
const password = process.env.POSTGRES_PASSWORD || 'example';

@Module({
  imports: [
    TypeOrmModule.forRoot({
      type: 'postgres',
      host: 'localhost',
      port: 5432,
      username,
      password,
      database: 'postgres',
      entities: [__dirname + '/**/*.entity{.ts,.js}'],
      synchronize: true,
    }),
  ],
  controllers: [AppController],
  providers: [AppService],
})
export class AppModule {}
Jak jste si jistě všimli, metoda forRoot přijímá stejnou konfiguraci pro práci s databází, jakou máme v souboru ormconfig.ts
Zbývá poslední úprava — přidat několik úloh pro práci s TypeORM do package.json. Faktem je, že CLI je napsané v JavaScriptu a spouští se v prostředí Node.js. Nicméně všechny naše modely a migrace budou napsány v TypeScriptu. Proto je nutné provést transpilační proces našich migrací a modelů před použitím CLI. K tomu budeme potřebovat balíček ts-node:
yarn add -D ts-node
Poté přidáme potřebné příkazy do package.json:
"typeorm": "ts-node -r tsconfig-paths/register ./node_modules/typeorm/cli.js",
"migration:generate": "yarn run typeorm migration:generate -n",
"migration:create": "yarn run typeorm migration:create -n",
"migration:run": "yarn run typeorm migration:run"
První příkaz, typeorm, přidává obal ve formě ts-node pro spuštění CLI TypeORM. Ostatní příkazy — to jsou užitečné zkratky, které jako vývojář budete používat téměř každý den:
migration:generate — vytvoření migrace na základě změn ve vašich modelech.
migration:create — vytvoření prázdné migrace.
migration:run — spuštění migrací.
Tak a teď už máme vše, potřebné balíčky jsme přidali, aplikaci jsme nakonfigurovali pro práci s databází jak přes CLI, tak z aplikace, a také jsme spustili databázový server. Je čas přidat logiku do naší aplikace.
Instalace balíčků pro vytváření CRUD
Použitím pouze Nest můžete vytvořit API, které umožňuje vytvářet, číst, aktualizovat a mazat entitu. Takové řešení bude maximálně flexibilní, nicméně pro některé případy může být nadměrné. Například, pokud potřebujete rychle vytvořit prototyp, často se můžete vzdát flexibility ve prospěch rychlosti vývoje. Mnoho rámců poskytuje funkce pro generování CRUD na základě popisu modelu dat určité entity. A Nest není výjimkou! Tuto funkčnost poskytuje balíček . Jeho možnosti jsou velmi zajímavé:
- snadná instalace a konfigurace;
- nezávislost na databázových systémech;
- silný skriptovací jazyk s možností filtrování, stránkování, třídění, načítání vztahů a vnořených entit, caching atd.;
- balíček pro vytváření dotazů na front-endu;
- snadné přepisování metod ovladače;
- malá konfigurace;
- podpora swagger dokumentace.
Funkcionalita je rozdělena do několika balíčků:
- — základní balíček, který poskytuje dekorátor () pro generování rout, konfiguraci a validaci;
- — balíček, který poskytuje builder/parser dotazů pro použití na straně frontendu;
- — balíček pro integraci s TypeORM, který poskytuje základní službu TypeOrmCrudService s CRUD metodami pro práci s entitami v databázi.
V této příručce budeme potřebovat balíčky jsx/crud a jsx/crud-typeorm. Pro začátek je nainstalujeme
yarn add @nestjsx/crud class-transformer class-validatorBalíčky a v této aplikaci jsou nezbytné pro deklarativní popis pravidel transformace instancí modelů a validaci příchozích dotazů. Tyto balíčky pocházejí od stejného autora, proto mají podobné rozhraní.
Přímá implementace CRUD
Jako příklad modelu použijeme seznam uživatelů. U uživatelů budou následující pole: id, uživatelské jméno, displayName, email. id — auto-increment pole, email a uživatelské jméno — unikátní pole. Je to jednoduché! Nyní nám zbývá realizovat náš plán jako Nest aplikaci.
Nejprve je třeba vytvořit modul users, který bude zodpovědný za práci s uživateli. Použijeme CLI od NestJS, a v kořenovém adresáři našeho projektu spustíme příkaz nest g module users.
nest g module users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g module users
CREATE /src/users/users.module.ts (82 bytes)
UPDATE /src/app.module.ts (312 bytes)
Do tohoto modulu přidáme složku entities, kde budou ležet modely tohoto modulu. Konkrétně sem přidáme soubor user.entity.ts s popisem modelu uživatelů:
user.entity.ts
import { Column, Entity, PrimaryGeneratedColumn } from 'typeorm';

@Entity()
export class User {
  @PrimaryGeneratedColumn()
  id: string;

  @Column({unique: true})
  email: string;

  @Column({unique: true})
  uživatelské jméno: string;

  @Column({nullable: true})
  zobrazené jméno: string;
}
Aby tento model "vidělo" naše aplikace, je třeba importovat do modulu UsersModule users.module.ts TypeOrmModule následujícího obsahu:
import { Module } from '@nestjs/common'; import { UsersController } from './controllers/users/users.controller'; import { UsersService } from './services/users/users.service'; import { TypeOrmModule } from '@nestjs/typeorm'; import { User } from './entities/user.entity';@Module({ controllers: [UsersController], providers: [UsersService], imports: [ TypeOrmModule.forFeature([User]) ] }) export class UsersModule {}
import { Module } from '@nestjs/common';
import { UsersController } from './controllers/users/users.controller';
import { UsersService } from './services/users/users.service';
import { TypeOrmModule } from '@nestjs/typeorm';
import { User } from './entities/user.entity';

@Module({
  controllers: [UsersController],
  providers: [UsersService],
  imports: [
    TypeOrmModule.forFeature([User])
  ]
})
export class UsersModule {}
To znamená, že zde importujeme TypeOrmModule, kde jako parametr metody forFeature uvádíme seznam modelů souvisejících s tímto modulem.
Je třeba vytvořit odpovídající entitu v databázi. K tomu slouží mechanismus migrací. Pro vytvoření migrace na základě změn v modelech je nutné spustit příkaz npm run migration:generate -- CreateUserTable:
Název spoileru
$ npm run migration:generate -- CreateUserTable
Migrace /home/dmitrii/projects/nest-rest/migrations/1563346135367-CreateUserTable.ts byla úspěšně vygenerována.
Hotovo za 1,96 s.
Nemuseli jsme psát migraci ručně, všechno proběhlo kouzelným způsobem. Není to zázrak! Ale ještě to není všechno. Podívejme se na vytvořený soubor s migrací:
1563346135367-CreateUserTable.ts
import {MigrationInterface, QueryRunner} from "typeorm";

export class CreateUserTable1563346816726 implements MigrationInterface {

    public async up(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`CREATE TABLE "user" ("id" SERIAL NOT NULL, "email" character varying NOT NULL, "username" character varying NOT NULL, "displayName" character varying, CONSTRAINT "UQ_e12875dfb3b1d92d7d7c5377e22" UNIQUE ("email"), CONSTRAINT "UQ_78a916df40e02a9deb1c4b75edb" UNIQUE ("username"), CONSTRAINT "PK_cace4a159ff9f2512dd42373760" PRIMARY KEY ("id"))`);
    }

    public async down(queryRunner: QueryRunner): Promise {
        await queryRunner.query(`DROP TABLE "user"`);
    }

}
Jak si můžete všimnout, byl automaticky vygenerován nejen metod pro spuštění migrace, ale i metoda pro její vrácení. Fantastické!
Zbývá jen aplikovat tuto migraci. To se provádí následujícím příkazem:
npm run migration:run.Hotovo, nyní se změny schématu přenesly do databáze.
Dále vytvoříme službu, která bude odpovídat za práci s uživateli a odvodíme ji z TypeOrmCrudService. Do parametru rodičovského konstruktoru je nutné předat repozitář zajímavé entity, v našem případě User repozitář.
users.service.ts
import { Injectable } from '@nestjs/common';
import { TypeOrmCrudService } from '@nestjsx/crud-typeorm';
import { User } from '../..//entities/user.entity';
import { InjectRepository } from '@nestjs/typeorm';
import { Repository } from 'typeorm';

@Injectable()
export class UsersService extends TypeOrmCrudService{
  constructor(@InjectRepository(User) usersRepository: Repository){
    super(usersRepository);
  }
}
Tato služba bude potřebná v kontroleru users. Pro vytvoření kontroleru zadejte do konzole nest g controller users/controllers/users
nest g controller users/controllers/users
dmitrii@dmitrii-HP-ZBook-17-G3:~/projects/nest-rest git:(master*)$ nest g controller users/controllers/users
VYTVOŘENO /src/users/controllers/users/users.controller.spec.ts (486 bytů)
VYTVOŘENO /src/users/controllers/users/users.controller.ts (99 bytů)
AKTUALIZACE /src/users/users.module.ts (188 bytů)
Otevřeme tento kontroler a upravíme jej, abychom přidali trochu magie jsx/crud. Na třídu UsersController přidáme dekorátor následujícího typu:
@Crud({
  model: {
    type: User
  }
}) — je to dekorátor, který do kontroleru přidává potřebné metody pro práci s modelem. Typ modelu je uveden v poli model.type konfigurace dekorátora.
Druhým krokem je implementovat rozhraní CrudController<User>. „V celku“ vypadá kód kontroleru následovně:
import { Controller } from '@nestjs/common';
import { Crud, CrudController } from '@nestjsx/crud';
import { User } from '../.. /entities/user.entity';
import { UsersService } from '../.. /services/users/users.service';

@Crud({
  model: {
    type: User
  }
})
@Controller('users')
export class UsersController implements CrudController<User>{
  constructor(public service: UsersService){}
}
A to je vše! Nyní kontroler podporuje celou sadu operací s modelem! Nevěříte? Zkusme naši aplikaci v praxi!
Vytvoření scénáře požadavků v TestMace
Pro testování našeho servisu budeme používat IDE pro práci s API . Proč TestMace? Ve srovnání s podobnými produkty má následující výhody:
- silná práce s proměnnými. V současné době existuje několik typů proměnných, z nichž každá má svůj specifický účel: vestavěné proměnné, dynamické proměnné, proměnné prostředí. Každá proměnná patří k určitému uzlu a podporuje mechanismus dědičnosti;
- snadné vytváření scénářů bez programování. O tom se podrobněji zmíníme níže;
- čitelného formátu, který umožňuje ukládat projekt v systémech správy verzí;
- automatické doplňování, zvýraznění syntaxe, zvýraznění hodnot proměnných;
- podpora popisu API s možností importu ze Swaggeru.
Spusťme náš server příkazem npm start a pokusme se přístupit k seznamu uživatelů. Seznam uživatelů, soudě podle naší konfigurace kontroleru, lze získat na url localhost:3000/users. Pošleme požadavek na toto url.
Po spuštění TestMace můžete vidět takové rozhraní:
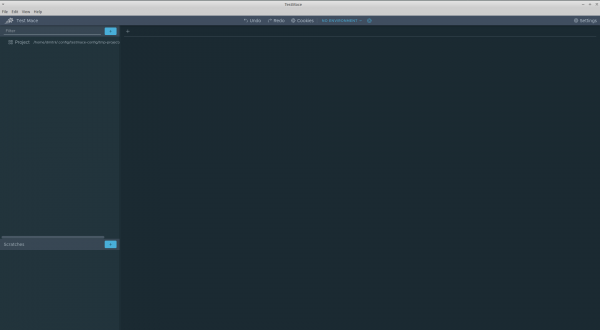
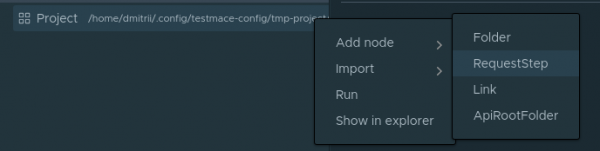
Vlevo nahoře je strom projektů s kořenovým uzlem . Zkusme vytvořit první požadavek na získání seznamu uživatelů. Za tímto účelem vytvoříme uzel. To se provádí v kontextovém menu uzlu Project Přidat uzel -> RequestStep.
Do pole URL vložte localhost:3000/users a proveďte požadavek. Obdržíme kód 200 s prázdným polem v těle odpovědi. Není divu, nikoho jsme zatím nepřidali.
Vytvořme scénář, který bude zahrnovat následující kroky:
- vytvoření uživatele;
- požadavek podle id právě vytvořeného uživatele;
- odstranění uživatelského ID, které bylo vytvořeno v kroku 1.
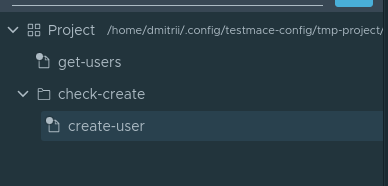
Tak pojďme na to. Pro pohodlí vytvoříme uzel typu . V podstatě je to jen složka, ve které uložíme celý skript. K vytvoření uzlu složky je třeba v kontextovém menu uzlu projektu zvolit Přidat uzel -> Složka. Pojmenujme uzel check-create. Uvnitř uzlu check-create vytvoříme náš první dotaz na vytvoření uživatele. Nově vytvořený uzel nazveme create-user. To znamená, že momentálně bude hierarchie uzlů vypadat takto:
Přejděme na záložku otevřeného create-user uzlu. Zadejme následující parametry pro dotaz:
- Typ dotazu — POST
- URL — localhost:3000/users
- Tělo — JSON s hodnotou
{"email": "user@user.com", "displayName": "New user", "username": "user"}
Provedeme tento dotaz. Naše aplikace říká, že záznam byl vytvořen.
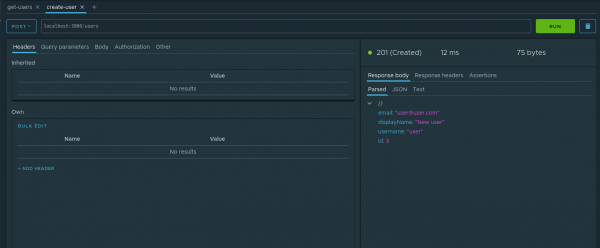
Což takhle zkontrolovat tento fakt. Abychom v následujících krocích mohli pracovat s ID vytvořeného uživatele, je třeba tento parametr uložit. K tomu se skvěle hodí mechanismus . Podívejme se na našem příkladu, jak s nimi pracovat. Na záložce parsed odpovědi u uzlu ID v kontextovém menu je třeba zvolit položku Přiřadit k proměnné. V dialogovém okně je třeba zadat následující parametry:
- Node — ve kterém z předků vytvořit dynamickou proměnnou. Vybereme check-create
- Název proměnné — název této proměnné. Nazveme ji
userId.
Takto vypadá proces vytváření dynamické proměnné:
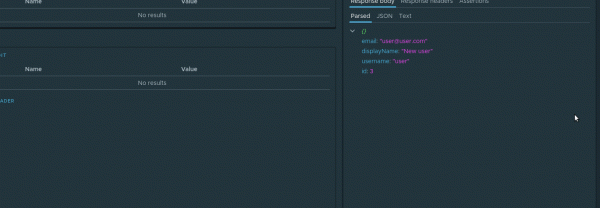
Nyní při každém provedení tohoto dotazu se hodnota dynamické proměnné bude aktualizovat. A protože dynamické proměnné podporují mechanismus hierarchického dědění, tak proměnná userId bude dostupná v potomcích check-create uzlu jakékoli úrovně zanoření.
V dalším dotazu nám tato proměnná bude užitečná. Konkrétně, budeme žádat o nově vytvořeného uživatele. Jako potomek uzlu check-create vytvoříme dotaz check-if exists s parametrem url rovným localhost:3000/users/${$dynamicVar.userId}. Konstrukce ve tvaru ${variable_name} je získání hodnoty proměnné. Protože máme dynamickou proměnnou, je třeba se obrátit k objektu $dynamicVar, tedy kompletní odkaz na dynamickou proměnnou userId bude vypadat takto ${$dynamicVar.userId}. Provedeme dotaz a přesvědčíme se, že data se dotazují správně.
Zbývá poslední úkon — vytvořit žádost o odstranění. Potřebujeme ji nejen k ověření funkčnosti odstranění, ale také, abychom tak říkajíc uklidili po sobě v databázi, protože pole email a username jsou unikátní. Tudíž vytvoříme v uzlu check-create žádost delete-user s následujícími parametry
- Typ žádosti — DELETE
- URL —
localhost:3000/users/${$dynamicVar.userId}
Spouštíme. Čekáme. Užíváme si výsledek)
A teď můžeme kdykoli spustit celý tento scénář. Abychom scénář spustili, je třeba vybrat v kontextovém menu check-create uzlu položku Spustit.
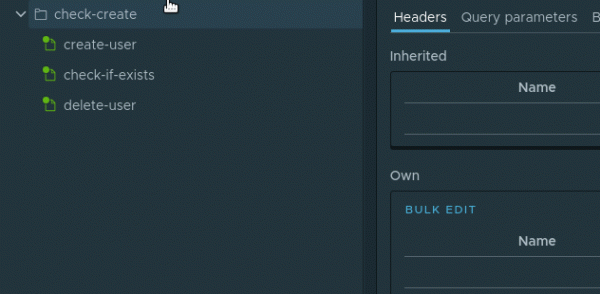
Uzly ve scénáři se provedou za sebou
Tento scénář si můžete uložit do svého projektu provedením Soubor -> Uložit projekt.
Závěr
Do formátu tohoto článku se bohužel nevešly všechny funkce použitých nástrojů. Pokud jde o hlavního viníka — balíček jsx/crud — zůstaly neosvětlené následující témata:
- vlastní validace a transformace modelů;
- silný dotazovací jazyk a jeho pohodlné použití na frontendu;
- předefinování a přidání nových metod do crud kontrolerů;
- podpora swagger;
- řízení cache.
I když to, co je v článku popsáno, stačí k pochopení, že i takový enterprise framework jako NestJS má v rukávu nástroje pro rychlé prototypování aplikací. A tak skvělá IDE jako umožňuje udržet dané tempo.
Zdrojový kód tohoto článku, spolu s projektem , je dostupný v repozitáři . Pro otevření projektu stačí v aplikaci provést Soubor -> Otevřít projekt.
Zdroj: habr.com
