

V tomto článku se podělíme o to, jak jsme řešili problém nedostatku volných buněk ve skladu a o vývoji algoritmu diskrétní optimalizace pro tuto úlohu. Popsáme, jak jsme „stavěli“ matematický model úlohy optimalizace, a jaké potíže nás překvapivě potkaly při zpracování vstupních dat pro algoritmus.
Pokud vás zajímají aplikace matematiky v podnikání a nebojíte se jednoduchých algebraických transformací na úrovni 5. třídy, vítejte pod kat!
Článek bude užitečný těm, kdo implementují WMS-systémy, pracují v oblasti skladové nebo výrobní logistiky, stejně jako programátorům, kteří se zajímají o aplikace matematiky v podnikání a optimalizaci procesů ve firmě.
Úvodní část
Tato publikace pokračuje v cyklu článků, ve kterých se dělíme o své úspěšné zkušenosti s implementací optimalizačních algoritmů do skladových procesů.
V se zde popisuje specifika skladu, do kterého jsme implementovali WMS-systém, a také se rozebírá, proč bylo nutné řešit úlohu klasifikace zbytkových partii zboží při implementaci WMS-systému, a jak jsme to udělali.
Když jsme dokončili psaní článku o optimalizačních algoritmech, vyšlo to na velmi velký text, takže nasbíraný materiál jsme se rozhodli rozdělit na 2 části:
- V první části (tento článek) se podělíme o to, jak jsme „stavěli“ matematický model úlohy a jaké velké problémy nás překvapivě potkaly při zpracování a transformaci vstupních dat pro algoritmus.
- Ve druhé části podrobně probereme realizaci algoritmu v jazyce C++, provedeme výpočetní experiment a shrneme zkušenosti, které jsme získali při implementaci těchto „inteligentních technologií“ do obchodních procesů zákazníka.
Jak číst článek. Pokud jste četli předchozí článek, můžete přečíst přímo kapitolu „Přehled stávajících řešení“, pokud ne, pak je popis řešeného problému ve spoileru níže.
Popis řešeného problému ve skladu zákazníka
Úzké místo v procesech
V roce 2018 jsme realizovali projekt implementace WMS-systémy na skladě „Obchodní dům „LD“ v Čeljabinsku. Implementovali produkt „1C-Logistika: Řízení skladu 3“ na 20 pracovních míst: operátoři, skladníci, řidiči vysokozdvižných vozíků. WMS, sklad má průměrně přibližně 4 tisíce m2, počet regálů 5000 a počet SKU 4500. Na skladě se uchovávají kulové kohouty vlastní výroby různých velikostí od 1 kg do 400 kg. Zásoby na skladu se uchovávají v rozpisu podle šarží, protože existuje potřeba výběru zboží podle FIFO.
Během projektování schémat automatizace skladových procesů jsme se setkali se stávajícím problémem neoptimálního skladování zásob. Specifika skladování a ukládání kohoutů je taková, že v jedné skříňce pro kusové skladování může být pouze sortiment jedné šarže (viz obr. 1). Produkce přichází na sklad denně a každý příjem je samostatná šarže. Celkem, v důsledku jednoho měsíce práce skladu, vzniká 30 samostatných šarží, přičemž každá musí být uložena v samostatné skříňce. Zboží se často vybírá nikoli celými paletami, ale kusy, a jako výsledek, v oblasti kusového výběru je v mnoha skříňkách takový obraz: ve skříňce o objemu přes 1m3 leží několik kusů kohoutů, které zabírají méně než 5-10% objemu skříňky.
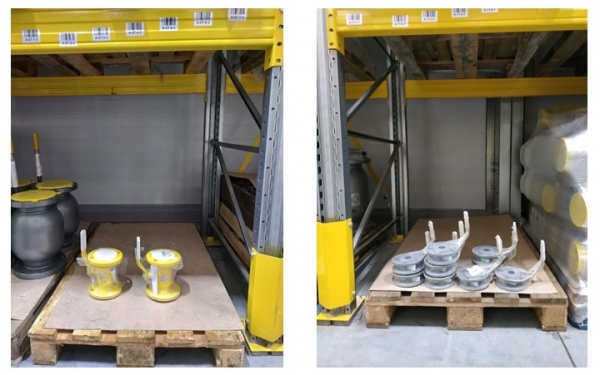
Obr 1. Foto několika kusů ve skříňce.
Je evidentní neoptimální využití skladových kapacit. Abych mohl ilustrovat rozsah problému, mohu uvést čísla: průměrně takových skříňků o objemu přes 1m3 s „minimálními“ zbytky v různých obdobích provozu skladu je od 100 do 300 skříňěk. Vzhledem k tomu, že sklad je relativně malý, v sezónách zatížení skladu se tento faktor stává „úzkým hrdlem“, které výrazně zpomaluje procesy příjmu a expedice.
Nápad na řešení problému.
Objevila se myšlenka: šarže zbytků s nejblíže datovanými zbytky sloučit do jedné společné šarže a tyto zbytky s unifikovanou šarží umístit kompaktně dohromady v jedné skříňce, nebo ve více, pokud místo v jedné nebude stačit pro umístění všech zbývajících. Příklad takové „komprese“ je znázorněn na obrázku 2.
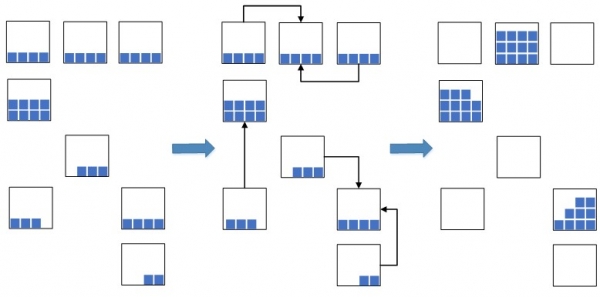
Obr.2. Schéma komprese zbytků ve skříňkách.
To značně zkracuje prostor, který bude využíván pro nové zboží. V situaci, kdy jsou skladovací kapacity přetížené, je takový krok mimořádně nutný, jinak může volného místa pro nové zboží jednoduše nedostávat, což povede k zablokování skladových procesů umístění a zásobování a tím i k zablokování příjmu a expedice. Dříve, před zavedením systému WMS, se tento úkol vykonával ručně, což bylo neefektivní, protože proces vyhledávání vhodných zásob v regálech byl dost zdlouhavý. Nyní, s implementací systému WMS, jsme se rozhodli proces automatizovat, urychlit a učinit ho inteligentním.
Proces řešení tohoto úkolu je rozdělen do 2 etap:
- v první etapě hledáme blízké skupiny šarží podle data pro zhuštění (tomu se věnujeme v článku) );
- ve druhé etapě pro každou skupinu šarží vypočítáme co nejkompaktnější umístění zbytků zboží v regálech.
V tomto článku se zaměříme na druhou etapu algoritmu.
Přehled stávajících řešení
Než přejdeme k popisu algoritmů, které jsme vyvinuli, stojí za to udělat krátký přehled již existujících systémů na trhu WMS, které realizují podobné funkce optimálního zhuštění.
V první řadě je třeba zmínit produkt „1C: Podnik 8. WMS Logistika. Řízení skladu 4“, který patří a je šířen firmou 1C a spadá do čtvrté generace WMS-systémů, vyvinutých firmou AXELOT. V tomto systému je deklarována funkce komprese, jejímž cílem je sloučit jednotlivé zbytky zboží do jedné společné regálové jednotky. Je třeba podotknout, že funkce komprese v takovém systému zahrnuje také další možnosti, například, opravu umístění zboží v regálech podle jejich ABC tříd, ale na ty se nezaměříme.
Pokud analyzujeme kód systému „1C: Enterprise 8. WMS Logistika. Řízení skladu 4“ (který je v této části funkčnosti otevřený), můžeme dospět k následujícímu závěru. Algoritmus komprese zbytků realizuje poměrně primitivní liniovou logiku a o jakékoli „optimální“ kompresi nemůže být řeč. Samozřejmě, klasterizaci šarží nepředpokládá. Několik klientů, u nichž byl tento systém implementován, si stěžovalo na výsledky plánování komprese. Například, často se v praxi při kompresi vyskytlo následující: 100 ks zbytků z jedné buňky je plánováno přesunout do jiné buňky, kde je 1 ks zboží, přičemž optimálně z hlediska časových nákladů by bylo lepší udělat to naopak.
Funkce komprese zbytků zboží v buňkách je také deklarována v mnoha zahraničních WMS-systémech, ale bohužel nemáme žádné skutečné recenze o účinnosti práce algoritmů (to je obchodní tajemství), ani tím méně představu o hloubce jejich logiky (proprietární software se zavřeným kódem), takže nemůžeme soudit.
Hledání matematického modelu úlohy
Abychom navrhli kvalitní algoritmy pro řešení úlohy, je nejprve nutné tuto úlohu jasně matematicky formulovat, což uděláme.
Existuje mnoho buněk  , ve kterých se nacházejí zbytky nějakého zboží. Dále budou tyto buňky nazývány buňkami-dárci. Označíme
 objem zboží nacházejícího se v buňce
 $.
Je důležité říci, že v procesu komprese může účastnit pouze jedno zboží jedné šarže, nebo několika šarží, které byly předtím sloučeny do klastru (čti ), což je dáno specifikou skladování a uložení zboží. Pro různé zboží nebo různé klastery šarží by měla být spuštěna vlastní oddělená procedura komprese.
Existuje mnoho buněk  , do kterých mohou být potenciálně umístěny zbytky z buněk-dárců. Tyto buňky budeme dále nazývat buňkami-kontejnery. Mohou to být jak volné buňky ve skladu, tak buňky-dárci z množství
 . Vždy je množina
 podmnožinou
 .
Pro každou buňku  z množiny
 jsou stanovena omezení na kapacitu
 , měřené v dm3. Jeden dm3 představuje krychli se stranami 10 cm. Produkty uložené ve skladu jsou dostatečně velké, takže v tomto případě taková diskrétnost zcela stačí.
Je dána matice nejkratších vzdáleností  v metrech mezi každou dvojicí buněk
 , kde
 a
 patří do množin
 a
 odpovídajícím způsobem.
Označme  náklady na přesun zboží z buňky
 do buňky
 . Označme
 náklady na výběr kontejneru
 pro přesun zbytků z jiných buněk. Jakým způsobem a v jakých jednotkách budou hodnoty vypočítávány
 a
 probereme dále (viz část příprava vstupních dat), nyní stačí říci, že takové veličiny budou přímo úměrné velikostem
 a
 odpovídajícím způsobem.
Označme pomocí  proměnnou, která nabývá hodnoty 1, pokud se zbytky z buňky
 přesunují do kontejneru
 , a 0 v opačném případě. Označme pomocí
 proměnnou, která nabývá hodnoty 1, pokud kontejner
 obsahuje zbytky zboží, a 0 v opačném případě.
Úkol je formulován takto: je třeba nalézt takové množství kontejnerů  a tímto způsobem "připojit" buňky-dárce ke kontejnerovým buňkám tak, aby se minimalizovala funkce

při omezeních

Celkově se během výpočtu řešení úkolu snažíme:
- za prvé, šetřit skladové kapacity;
- za druhé, šetřit čas skladníků.
Poslední omezení znamená, že nemůžeme přesouvat zboží do kontejneru, který nebyl vybrán, a proto jsme na jeho výběr "neponesli náklady". Také toto omezení znamená, že objem přesouvaného zboží z buněk do kontejneru nesmí překročit kapacitu kontejneru. Řešením úkolu budeme rozumět množství kontejnerů  a způsoby připojení buněk-dárce k kontejnerům.
Taková formulace úkolu optimalizace není nová a byla zkoumána mnoha matematiky již od počátku 80. let minulého století. V zahraniční literatuře existují 2 úkoly optimalizace s vhodným matematickým modelem: a (o rozdílech úloh budeme hovořit dále). Je třeba říci, že v matematické literatuře jsou formulace těchto dvou optimalizačních úloh definovány v termínech umístění zařízení v terénu, odtud také název „Facility Location“. V zásadě se jedná o tradici, neboť poprvé vznikla potřeba řešit takové kombinatorické úlohy v oblasti logistiky, převážně v obranném průmyslu v 50. letech minulého století. V termínech umístění zařízení se tyto úlohy formulují takto:
- Existuje konečná množina měst, kde je potenciálně možné umístit výrobní závody (dále města-výrobci). Pro každé město-výrobce jsou stanovena náklady na jeho otevření, stejně jako omezení na výrobní kapacity otevřeného závodu.
- Existuje konečná množina měst, kde se skutečně nachází zákazníci (dále města-zákazníci). Pro každé takové město-zákazníka je stanovena potřeba po produkci. Pro zjednodušení budeme předpokládat, že produkt, který vyrábějí závody a spotřebovávají zákazníci, je stejný.
- Pro každý pár město-výrobce a město-zákazník je stanovena výše přepravních nákladů na dodání požadovaného objemu produkce od výrobce k zákazníkovi.
Je třeba zjistit, v jakých městech otevřít závody a jak připojit zákazníky k těmto závodům, aby:
- Celkové náklady na otevření závodů a přepravní náklady byly minimální;
- Objem poptávky zákazníků, připojených k nějakému otevřenému závodu, nepřekračoval výrobní kapacity tohoto závodu.
Nyní je vhodné zmínit jediné rozdíly mezi těmito dvěma klasickými úlohami:
- Single-Source Capacitated Facility Location Problem – zákazník je zásobován pouze z jednoho otevřeného závodu;
- Multi-Source Capacitated Facility Location Problem – zákazník může být zásobován z několika otevřených závodů současně.
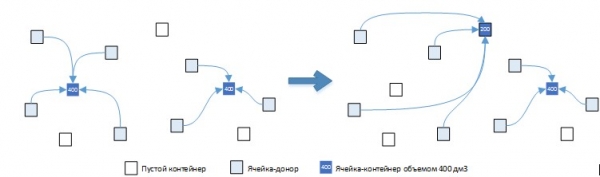
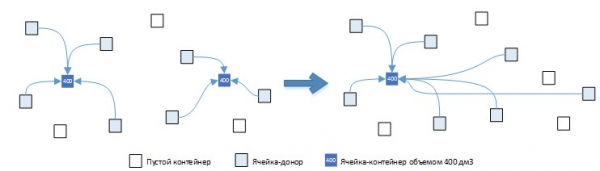
Toto rozdílení dvou úloh se na první pohled může zdát nevýznamným, ale ve skutečnosti vede k naprosto odlišné kombinatorické struktuře těchto úloh a v důsledku toho k naprosto odlišným algoritmům jejich řešení. Rozdíl mezi úlohami je uveden na obrázku níže.
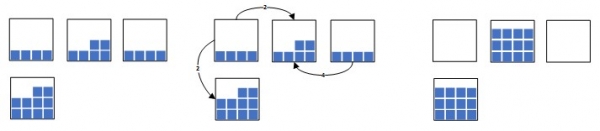
Obr. 3. a) Multi-Source Capacitated Facility Location Problem
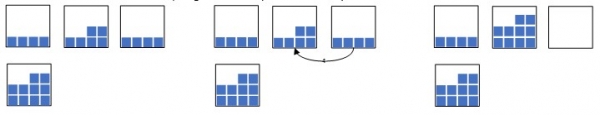
Obr. 3. b) Single-Source Capacitated Facility Location Problem
Obě úlohy  -je těžký, to znamená, že neexistuje přesný algoritmus, který by v polynomiálním čase podle velikosti vstupních dat vyřešil tento úkol. Jednodušeji řečeno, všechny přesné algoritmy pro řešení úkolu budou pracovat exponenciální čas, i když možná rychleji než čisté prohledávání variant. Vzhledem k tomu, že úkol
 -je těžký, budeme se zabývat pouze přibližnými heuristikami, tedy algoritmy, které budou stabilně počítat řešení velmi blízká optimálním a budou pracovat dostatečně rychle. Pokud máte zájem o takové úkoly, zde lze najít dobrý přehled v ruštině.
Pokud aplikujeme terminologii našeho úkolu optimálního ukládání zboží do buněk, pak:
- města-klienti – to jsou buňky-dárci
 s zbytkem zboží,
- města-výrobci – buňky-kontejnery , do kterých se předpokládá uložení zbytků z jiných buněk,
- náklady na dopravu – náklady času skladníka na přesun objemu zboží z buňky-dárce do buňky-kontejner ;
- náklady na otevření podniku – náklady na výběr kontejneru , rovné objemu buňky-kontejneru , vynásobené určitým koeficientem úspory volných objemů (hodnota koeficientu je vždy > 1) (viz sekce příprava vstupních dat).
 s zbytkem zboží,
 , do kterých se předpokládá uložení zbytků z jiných buněk,
 skladníka na přesun objemu zboží z buňky-dárce
 do buňky-kontejner
 ;
 , rovné objemu buňky-kontejneru
 , vynásobené určitým koeficientem úspory volných objemů (hodnota koeficientu je vždy > 1) (viz sekce příprava vstupních dat).
Poté, co byla analogie s klasickými problémy dodávek zavedená, je nutné odpovědět na důležitou otázku, od které závisí výběr architektury algoritmu řešení: je možné přesunutí zbytků z buňky-dárce pouze do jednoho a pouze jednoho kontejneru (Single-Source), či je možné přesunutí zbytků do několika buněk-kontejnerů (Multi-Source)?
Je třeba poznamenat, že v praxi obě formulace úkolu existují. Uvedeme níže všechny "pro" a "proti" pro každou takovou formulaci:
| Varianta úkolu | Klady varianty | Zápory varianty |
|---|---|---|
| Single-Source | Operace přesunu zboží, vypočítané podle této varianty úkolu:
| |
| Multi-Source | Komprese vypočtené pro tuto variantu úkolu jsou obvykle o 10-15 % kompaktnější než komprese vypočtené pro variantu „Single-Source“. Je však také třeba poznamenat, že čím menší je počet zbytků v buňkách-dárci, tím menší je toto rozdílení v kompaktnosti | Operace přesunu zboží, vypočítané podle této varianty úkolu:
|
Tabulka 1. Klady a zápory variant Single-Source a Multi-Source.
Vzhledem k tomu, že počet kladů u varianty Single-Source je vyšší, a také s ohledem na fakt, že čím menší je počet zbytků v buňkách-dárci, tím menší je rozdílnost v míře kompaktnosti komprese vypočtené pro obě varianty úlohy, jsme se rozhodli pro variantu Single-Source.
Je třeba říci, že řešení varianty Multi-Source má také své místo. Existuje velké množství efektivních algoritmů pro její řešení, z nichž většina spočívá v řešení řady transportních úloh. Existují také nejen efektivní algoritmy, ale i elegantní, například,
Příprava vstupních dat
Předtím, než se pustíme do analýzy a vývoje algoritmu pro řešení úlohy, je nutné určit, jaká data a v jaké podobě mu budeme podávat jako vstup. S objemy zbytků zboží v buňkách-dárci a kapacitou buněk-kontejnerů nejsou problémy, protože to je triviální – takové veličiny se budou měřit v m3, ale s náklady na využití buňky-kontejneru a maticí nákladů na přesun to není tak jednoduché!
Nejprve se podíváme na výpočet nákladech na přesun zboží z buňky-donora do buňky-kontejneru. Nejprve je třeba se rozhodnout, v jakých jednotkách budeme počítat náklady na přesun. Dvě nejzřejmější možnosti jsou metry a sekundy. V 'čistých' metrech je počítání nákladů na přesun nesmyslné. Ukážeme to na příkladu. Předpokládejme, že buňka  se nachází na prvním patře, buňka
 je vzdálena 30 metrů a nachází se na druhém patře:
- Přesun z v je nákladnější než přesun z v , protože je snadnější spouštět dolů z druhého patra (1,5-2 metry od podlahy) než zvedat na druhé, ačkoli vzdálenost bude kryta stejná;
- Přesunout 1 ks zboží z buňky v bude jednodušší než přesunout 10 ks téhož zboží, ačkoli vzdálenost bude kryta stejná.
 v
 je nákladnější než přesun z
 v
 , protože je snadnější spouštět dolů z druhého patra (1,5-2 metry od podlahy) než zvedat na druhé, ačkoli vzdálenost bude kryta stejná;
 v
 bude jednodušší než přesunout 10 ks téhož zboží, ačkoli vzdálenost bude kryta stejná.
Náklady na přesun je lepší počítat v sekundách, protože to umožňuje zohlednit rozdíly v patrech a rozdíly v množství přesouvaného zboží. Pro zajištění nákladů na přesun v sekundách musíme rozložit operaci přesunu na elementární složky a provést měření času na vykonání každé elementární složky.
Předpokládejme, že z buňky  se přesouvá
 ks zboží do kontejneru.
 Předpokládejme, že
 je průměrná rychlost pohybu pracovníka po skladu, měřená v m/s. Předpokládejme, že
 a
 jsou průměrné rychlosti jednorázového provádění operací vzít a položit odpovídající pro objem zboží rovný 4 dm3 (průměrný objem, který bere pracovník na skladu při provádění operací). Předpokládejme, že
 a
 je výška buněk, ze kterých jsou vykonávány operace vzít a položit odpovídající. Například průměrná výška prvního patra (podlaha) je 1 m, druhého patra 2 m atd. Pak vzorec pro výpočet celkového času na vykonání operace přesunu
 je následující:

V tabulce 2 jsou uvedeny statistiky doby vykonání každé elementární operace, které shromáždili pracovníci skladu s ohledem na specifiku skladovaného zboží.
| Název operace | Označení | Průměrná hodnota |
|---|---|---|
| Průměrná rychlost pohybu pracovníka po skladu |  | 1,5 m/s |
| Průměrná rychlost vykonání jedné operace položit (pro objem zboží 4 dm3) |  | 2,4 s |
Tabulka 2. Průměrný čas vykonání skladových operací
S metodou výpočtu nákladů na přesun jsme se již dohodli. Nyní je třeba zjistit, jak vypočítat náklady na výběr buňky-kontejneruZde je vše mnohem, mnohem složitější než náklady na přesun, protože:
- za prvé, náklady by měly být ve přímé závislosti na objemu buňky – stejný objem zbytků, který se přesouvá z donorových buněk, je lepší vložit do menšího kontejneru než do většího kontejneru, pokud daný objem plně pojme oba kontejnery. Tímto způsobem, minimalizující celkové náklady na výběr kontejnerů, se snažíme ušetřit 'nedostatečné' volné skladové kapacity v oblasti sběrného místa pro provedení následných operací umístění zboží do buněk. Na obrázku 4 jsou demonstrovány varianty přesouvání zbytků do velkých a malých kontejnerů a důsledky těchto variant přesunu při provádění následných skladových operací.
- za druhé, protože v řešení původního úkolu musíme minimalizovat právě celkové náklady, což je součet jak nákladů na přesun, tak nákladů na výběr kontejnerů, bylo by nutné nějakým způsobem propojit objemy buněk v metrech krychlových se sekundami, což rozhodně není triviální.
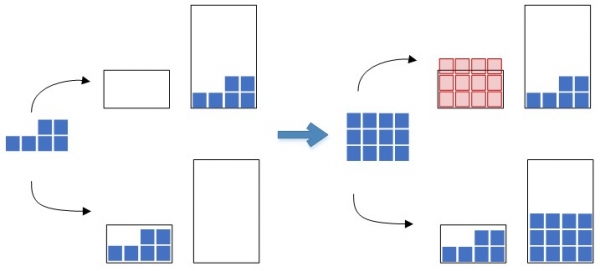
Obr. 4. Varianty přesouvání zbytků do kontejnerů různé kapacity.
Na obrázku 4 je červeně znázorněn objem zbytků, který se již nevejde do kontejneru ve druhé fázi umístění následného zboží.
Následující požadavky na vypočítaná řešení úkolu pomohou propojit metry krychlové nákladů na výběr kontejneru se sekundami nákladů na přesun:
- Je nutné, aby zbytky z donorové buňky byly přesunuty do buňky-kontejneru za každou cenu, pokud to snižuje celkový počet buněk-kontejnerů, ve kterých se nachází zboží.
- Je třeba dodržovat rovnováhu mezi objemy kontejnerů a náklady na přesun: například, pokud je ve novém variantu řešení úkolu ve srovnání s předchozím řešením výhoda v objemu veliká, ale ztráta na čase malá, je nutné zvolit nový variant.
Začněme posledním požadavkem. Abychom konkretizovali mnohoznačné slovo 'rovnováha', provedli jsme anketu mezi zaměstnanci skladu s cílem zjistit následující. Mějme buňku-kontejner objemu  , do které je určeno přesunout zbytky zboží z donorových buněk a celkový čas tohoto přesunu je roven
 . Nechť je zde několik alternativních možností umístění stejného množství zboží z těchto donorových buněk do jiných kontejnerů, přičemž každé umístění má své hodnocení.
 , kde
 <
 a
 , kde
 >
 .
Otázka zní: jaké minimum objemu výhry  je přijatelné, při stanovené hodnotě ztráty na čase.
 ? Поясним на примере. Изначально остатки полагалось размещать в контейнер объема 1000 дм3 (1 м3) и время на перемещение составило 70 секунд. Есть вариант размещения остатков в другой контейнер объема 500 дм3 и временем 130 секунд. Вопрос: готовы ли мы тратить еще дополнительные 60 секунд времени кладовщика на выполнение перемещения для того, чтобы сэкономить 500 дм3 свободного объема? По результатам опроса сотрудников склада была составлена следующая диаграмма.
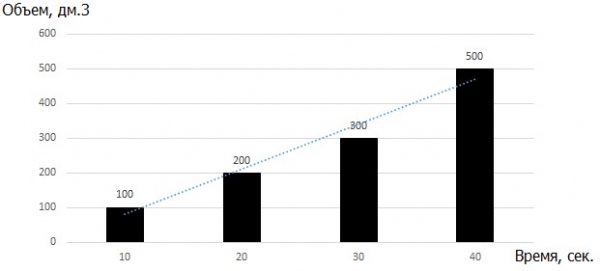
Obr. 5. Diagram závislosti minimální přípustné úspory objemu na zvýšení rozdílu v době provádění operace.
To znamená, že pokud dodatečné náklady na čas činí 40 sekund, jsme připraveni je utratit pouze tehdy, když zisk v objemu bude minimálně 500 dm3. I když v závislosti existuje mírná nelinearita, pro zjednodušení dalších výpočtů budeme považovat závislost mezi veličinami za lineární a popsanou nerovností.

Na obrázku níže zvážíme následující způsoby umístění zboží do kontejnerů.
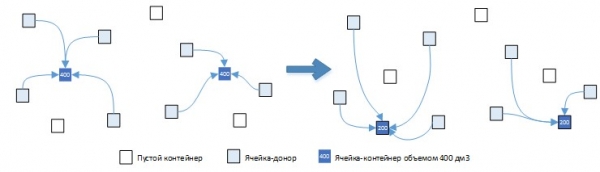
Obr. 6. Varianta (a): 2 kontejnery, celkový objem 400 dm3, celkový čas 150 s.
Obr. 6. Varianta (b): 2 kontejnery, celkový objem 600 dm3, celkový čas 190 s.
Obr. 6. Varianta (c): 1 kontejner, celkový objem 400 dm3, celkový čas 200 s.
Varianta (a) výběru kontejnerů je preferovanější než původní varianta, protože platí nerovnost: (800-400)/10 >= 150-120, z čehož vyplývá 40 >= 30. Varianta (b) je méně preferovaná než původní varianta, protože nerovnost není splněna: (800-600)/10 >= 190-150, z čehož vyplývá 20 >= 40. Varianta (c) však do této logiky nezapadá! Zvažme tuto variantu podrobněji. Na jedné straně platí nerovnost (800-400)/10 >= 200-120, což znamená, že nerovnost 40 >= 80 není splněna, což naznačuje, že přínos v objemu nestojí za tak velkou ztrátu na čase.
Na druhé straně v takové variantě (c) nejenže snižujeme celkový obsazený objem, ale také snižujeme počet obsazených bunkrů, což je první z dvou důležitých požadavků na vypočítaná řešení uvedených výše. Je zřejmé, že pro splnění tohoto požadavku je nutné do levé strany nerovnosti přidat nějakou kladnou konstantu.  , a přičemž tuto konstantu je třeba přidávat pouze tehdy, když se počet kontejnerů snižuje. Připomeňme, že
 — je proměnná, která je rovna 1, když je kontejner
 vybrán, a 0 když kontejner.
 není vybráno. Označíme,
 – množství kontejnerů v původním řešení a
 – množství kontejnerů v novém řešení. V obecné podobě nové nerovnost bude vypadat takto:

Zpracováním výše uvedené nerovnosti získáváme

Na základě toho máme vzorec pro výpočet celkových nákladů  nějaké varianty řešení úlohy:

Ale nyní vyvstává otázka: jakou hodnotu by měla mít taková konstanta  ? Очевидно, что ее значение должно быть достаточно большим, для того, чтобы всегда выполнялось первое требование к решениям задачи. Можно конечно взять значение константы равное 103 или 106, но хотелось бы избежать таких «magic numbers». Если будем рассматривать специфику выполнения складских операций, мы можем вычислить несколько вполне обоснованных числовых оценок величины такой константы.
Ať  – maximální vzdálenost mezi buněk skladu jedné zóny ABC, která je v našem případě 100 m. Ať
 – maximální objem buňky-kontejneru ve skladu, který je v našem případě 1000 dm3.
První způsob výpočtu velikosti  . Zvažme situaci, kdy jsou 2 kontejnery na první úrovni, v nichž se již fyzicky nachází zboží, tedy samy fungují jako buňky-dárci, a náklady na přesun zboží do těchto buněk jsou samozřejmě rovny 0. Je třeba nalézt takovou hodnotu konstanty
 , při které by bylo výhodné vždy přesunout zbytky z kontejneru 1 do kontejneru 2. Dosazením hodnot
 a
 do nerovnosti uvedené výše získáváme:

z čehož vyplývá

Dosazením hodnot průměrného času provádění elementárních operací do výše uvedeného vzorce dostáváme

Druhý způsob výpočtu velikosti  . Zvažme situaci, kdy existují
 buňky-dárci, ze kterých se plánuje přesunout zboží do kontejneru 1. Označme
 – vzdálenost od buňky-dárce
 do kontejneru 1. Rovněž existuje kontejner 2, ve kterém již jsou výrobky, a jehož objem dovoluje pojmout zbytky ze všech
 buňky. Pro jednoduchost budeme předpokládat, že objem zboží, které je přesouváno z buněk-dárců do kontejnerů, je stejný a rovný
 . Je třeba nalézt takovou hodnotu konstanty
 , při které by umístění všech zbytků z
 buněk do kontejneru 2 bylo vždy výhodnější než jejich umístění do různých kontejnerů:

Zpracováním nerovnosti získáváme

Abychom "posílili" hodnotu velikosti  , předpokládejme, že
 = 0. Průměrný počet buněk obvykle zapojených do procedury zhuštění zbytků ve skladu je 10. Dosazením známých hodnot velikostí dostáváme následující hodnotu konstanty

Bereme nejvyšší hodnotu vypočtenou pro každou variantu, to bude hodnota velikosti  pro zadané parametry skladu. Nyní pro úplnost zapíšeme vzorec pro výpočet celkových nákladů
 pro nějaké přípustné řešení
 :

Nyní, po všech titanických úsilích při transformaci vstupních dat, můžeme říci, že všechna vstupní data byla převedena do požadovaného formátu a jsou připravena k použití v optimalizačním algoritmu.
Závěr
Jak ukazuje praxe, náročnost a důležitost fáze přípravy a transformace vstupních dat pro algoritmus jsou často podceňovány. V tomto článku jsme věnovali velkou pozornost této fázi, abychom ukázali, že pouze kvalitně a rozumně připravená vstupní data mohou učinit řešení, která algoritmus provádí, skutečně cennými pro klienta. Ano, bylo vypracováno mnoho vzorců, ale varovali jsme vás ještě před tímto chaosem 🙂
V příštím článku se konečně dostaneme k tomu, kvůli čemu byly zamýšleny dvě předchozí publikace – k algoritmu diskrétní optimalizace.
Článek připravil
Roman Shangin, programátor projektového oddělení,
společnost První Bit, Čeljabinsk
Zdroj: habr.com
