

Před vámi je opět úkol detekce objektů. Prioritou je rychlost práce při přijatelně přesné detekci. Berete architekturu YOLOv3 a dále ji trénujete. Přesnost (mAp75) je vyšší než 0,95. Ale rychlost zpracování je stále nízká. Sakra.
Dnes se vyhneme kvantizaci. A pod článkem si probereme Ořezávání modelu — odstranění nadbytečných částí sítě pro urychlení inference bez ztráty přesnosti. Přehledně — odkud, kolik a jak lze vyříznout. Probereme, jak to udělat ručně a kde je možné to automatizovat. Na závěr — repozitář na keras.
Úvod
Na předchozím místě práce, v Permu v Macroscopu, jsem si vytvořil jednu zvyk — vždy sledovat dobu provádění algoritmů. A dobu zpracování sítí vždy kontrolovat prostřednictvím filtru adekvátnosti. Obvykle state-of-the-art v produkci tento filtr neprocházejí, což mě přivedlo k ořezávání.
Ořezávání — téma staré, o které se mluvilo na v roce 2017. Hlavní myšlenkou je snížení velikosti naučené sítě bez ztráty přesnosti odstraněním různých uzlů. Zní to skvěle, ale zřídka slyším o jeho aplikaci. Pravděpodobně chybí implementace, není dostatek článků v ruštině nebo si všichni myslí, že ořezávání je know-how a mlčí.
Ale pojďme to prozkoumat
Pohled do biologie
Miluji, když se do Deep Learning dostávají myšlenky přicházející z biologie. Na ně se dá spolehnout, stejně jako na evoluci (věděl jsi, že ReLU je velmi podobná ?)
Proces ořezávání modelu je také blízký biologii. Reakci sítě zde lze srovnat s plastickostí mozku. Pár zajímavých příkladů je v knize :
- Mozek ženy, která od narození měla pouze jednu polovinu, se sám přeprogramoval na vykonávání funkcí chybějící poloviny.
- Chlapec si vystřelil část mozku, která odpovídala za zrak. Postupem času převzaly jiné části mozku tyto funkce. (zkoušet neopakujeme)
Tak i z vašeho modelu lze vyříznout část slabých konvolucí. V nouzovém případě zbylé konvoluce pomohou nahradit vyříznuté.
Máš rád Transfer Learning nebo se učíš od nuly?
Varianta číslo jedna. Používáš Transfer Learning na Yolov3, Retina, Mask-RCNN nebo U-Net. Ale většinou nemusíme rozpoznávat 80 tříd objektů, jako v COCO. V mé praxi je to většinou omezeno na 1-2 třídy. Lze předpokládat, že architektura pro 80 tříd je zde nadbytečná. Napadá mě, že architekturu je třeba zmenšit. Rád bych to udělal bez ztráty existujících předtrénovaných vah.
Varianta číslo dva. Možná máš hodně dat a výpočetních zdrojů, nebo jen potřebuješ vysoce přizpůsobenou architekturu. Je to jedno. Ale trénuješ síť od nuly. Obvyklý postup — podíváme se na strukturu dat, vybereme nadbytečnou architekturu a snižujeme dropouty na přetrénování. Viděl jsem dropouty 0.6, Karle.
V obou případech lze síť zmenšovat. Motivovali jsme se. Teď se jdeme podívat, co to je pruning.
Obecný algoritmus
Rozhodli jsme se, že můžeme odstraňovat konvoluce. Vypadá to velmi jednoduchě:
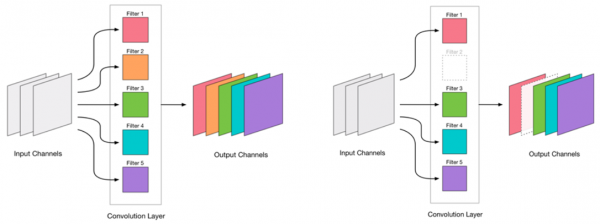
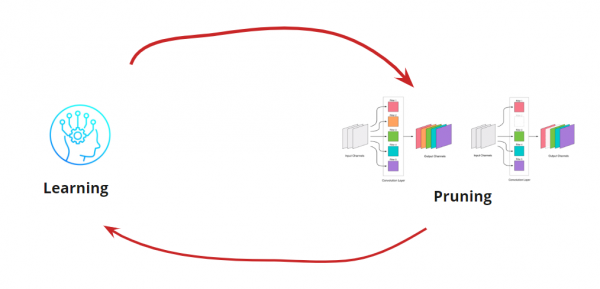
Odstranění jakékoli konvoluce je stres pro síť, který obvykle vede k určitému nárůstu chyby. Na jedné straně tento nárůst chyby ukazuje, jak správně odstraňujeme konvoluce (například velký nárůst naznačuje, že děláme něco špatně). Ale malý nárůst je docela přijatelný a často se odstraní následným lehkým doladěním s malým LR. Přidáváme krok doladění:
Teď potřebujeme pochopit, kdy chceme zastavit náš cyklus Learning<->Pruning. Existují exotické možnosti, kdy musíme zmenšit síť na určitou velikost a rychlost běhu (například pro mobilní zařízení). Nicméně, nejčastější možností je pokračovat v cyklu, dokud chyba nepřekročí přijatelnou úroveň. Přidáváme podmínku:
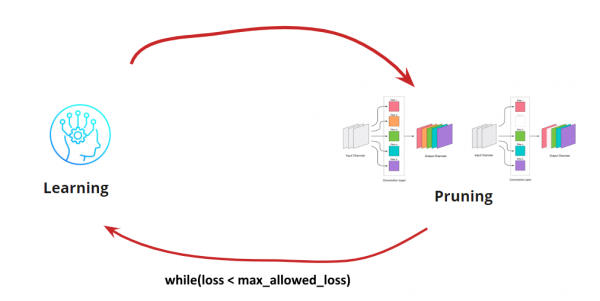
Takže algoritmus se stává jasným. Zbývá rozebrat, jak určit odstraňované konvoluce.
Hledání odstraňovaných konvolucí
Musíme odstranit nějaké konvoluce. Jít přímo a "odstřelovat" jakékoli — špatný nápad, i když to bude fungovat. Ale když máme hlavu, můžeme přemýšlet a pokusit se vybrat pro odstranění "slabé" konvoluce. Varianty jsou několik:
- . Myšlenka, že konvoluce s malými hodnotami vah přispívají jen málo k výslednému rozhodnutí.
- Nejmenší L1 metrika zohledňující průměr a směrodatnou odchylku. Doplňuje hodnocení charakteru rozdělení.
- . Přesnější určení nevýznamných konvolucí, ale značně časově a zdrojově náročné.
- Další
Každá z variant má právo na existenci a své specifické provedení. Zde se zaměříme na variantu s nejmenší L1 metrikou.
Ruční proces pro YOLOv3.
V původní architektuře se nacházejí zbytkové bloky. Ale ať jsou jakékoli komplikované pro hluboké sítě, poněkud nám překážejí. Problém je v tom, že nelze odstraňovat konvoluce s různými indexy v těchto vrstvách:
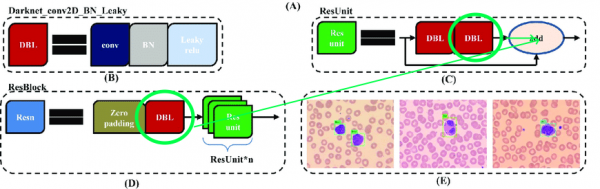
Proto vyprofilujeme vrstvy, ze kterých můžeme konvoluce svobodně odstraňovat:

Nyní postavíme pracovní cyklus:
- Extrahujeme aktivace.
- Odhadneme, kolik vyříznout.
- Vyřezáváme.
- Učíme 10 epoch s LR=1e-4.
- Testujeme.
Extrahování konvolucí je užitečné pro vyhodnocení, jakou část můžeme určitým krokem odstranit. Příklady extrakce:
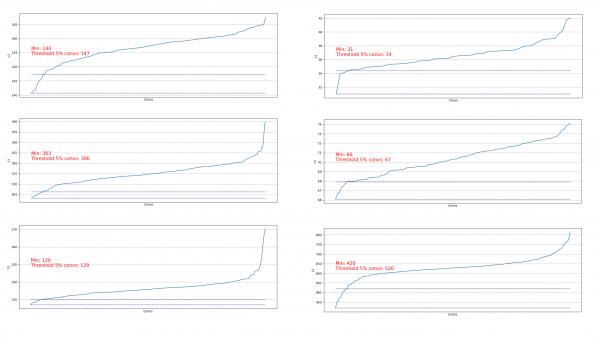
Vidíme, že téměř všude 5% konvolucí má velmi nízkou L1 normu a můžeme je odstranit. Při každém kroku byla tato extrakce opakována a prováděno hodnocení, z jakých vrstev a kolik můžeme vyříznout.
Celý proces se vešel do 4 kroků (tady a všude jsou čísla pro RTX 2060 Super):
| Krok | mAp75 | Počet parametrů, mil. | Velikost sítě, mb. | Od původní, % | Doba běhu, ms. | Podmínka ořezání. |
|---|---|---|---|---|---|---|
| 0 | 0.9656 | 60 | 241 | 100 | 180 | — |
| 1 | 0.9622 | 55 | 218 | 91 | 175 | 5% ze všech. |
| 2 | 0.9625 | 50 | 197 | 83 | 168 | 5% ze všech. |
| 3 | 0.9633 | 39 | 155 | 64 | 155 | 15% pro vrstvy s 400+ konvolucemi. |
| 4 | 0.9555 | 31 | 124 | 51 | 146 | 10% pro vrstvy s 100+ konvolucemi. |
K 2. kroku přibyl jeden pozitivní efekt — do paměti se vešel batch-size 4, což značně urychlilo proces dodatečného učení.
Ve 4. kroku byl proces zastaven, protože ani dlouhé dodatečné učení nezvýšilo mAp75 na staré hodnoty.
Nakonec se podařilo urychlit inference o 15%, zmenšit velikost o 35% a neztratit na přesnosti.
Automatizace pro jednodušší architektury.
Pro jednodušší architektury sítí (bez podmíněných add, concatenate a residual bloků) je možné orientovat se na zpracování všech konvolučních vrstev a automatizovat proces ořezávání konvolucí.
Tento variant jsem implementoval. .
Všechno je jednoduché: pouze potřebujete funkci ztráty, optimalizátor a batch generátory:
import pruning
from keras.optimizers import Adam
from keras.utils import Sequence

train_batch_generator = BatchGenerator...
score_batch_generator = BatchGenerator...

opt = Adam(lr=1e-4)
pruner = pruning.Pruner("config.json", "categorical_crossentropy", opt)

pruner.prune(train_batch, valid_batch)
Pokud je to nutné, lze změnit parametry konfigurace:
{
    "input_model_path": "model.h5",
    "output_model_path": "model_pruned.h5",
    "finetuning_epochs": 10, # počet epoch pro trénink mezi kroky ořezávání
    "stop_loss": 0.1, # ztráta pro zastavení procesu
    "pruning_percent_step": 0.05, # část konvolucí k odstranění v každém kroku ořezávání
    "pruning_standart_deviation_part": 0.2 # posun pro limitaci části ořezávání
}
Dodatečně bylo implementováno omezení na základě standardní odchylky. Cílem je omezit část odstraňovaných, s výjimkou konvolucí s již "dostatečnými" mírami L1:
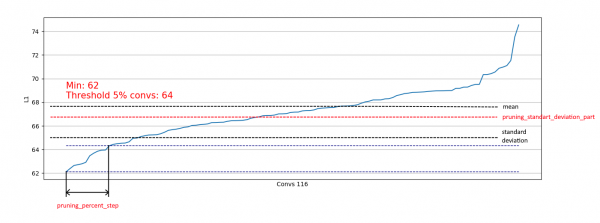
Tímto umožňujeme odstranit pouze slabé konvoluce z distribucí podobných pravému a neovlivňovat odstraňování z distribucí podobných levému:
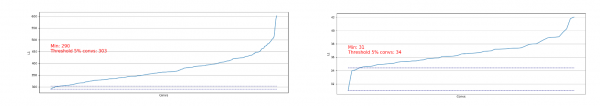
Při přibližování distribuce k normální lze koeficient pruning_standart_deviation_part nastavit z:
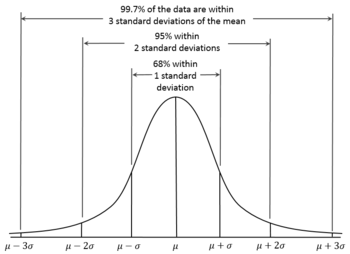
Doporučuji toleranci 2 sigma. Nebo se na tuto vlastnost nemusíte orientovat a nechat hodnotu < 1.0.
Na výstupu vzniká graf velikosti sítě, ztráty a doby běhu sítě po celém testu, normalizované na 1.0. Například, zde byla velikost sítě snížena téměř 2x bez ztráty kvality (malá konvoluční síť na 100k vah):
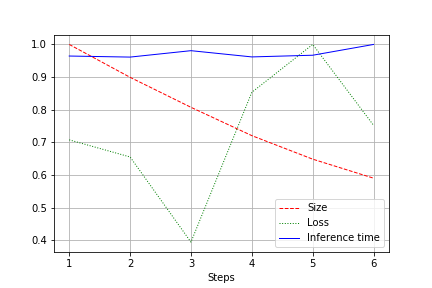
Rychlost běhu je ovlivněna normálními fluktuacemi a prakticky se nezměnila. K tomu existuje vysvětlení:
- Počet konvolucí se mění z pohodlného (32, 64, 128) na méně pohodlné pro grafické karty — 27, 51 atd. Tady se mohu mýlit, ale pravděpodobně to má vliv.
- Architektura není široká, ale sekvenční. Snižováním šířky nezasahujeme do hloubky. Tímto snižujeme zátěž, ale neměníme rychlost.
Proto se zlepšení projevilo ve snížení zátěže CUDA při běhu o 20-30%, ale ne ve snížení doby běhu.
Závěry
Pojďme se zamyslet. Zvážili jsme 2 varianty ořezávání — pro YOLOv3 (kdy je nutné pracovat ručně) a pro sítě s jednoduššími architekturami. Je vidět, že v obou případech lze dosáhnout snížení velikosti sítě a urychlení bez ztráty přesnosti. Výsledky:
- Snížení velikosti
- Zrychlení běhu
- Snížení zátěže CUDA
- Jako důsledek, ekologičnost (Optimalizujeme budoucí využívání výpočetních zdrojů. Někde se raduje jedna )
Příloha
- Po kroku ořezávání lze doladit i kvantizaci (například s TensorRT)
- Tensorflow nabízí možnosti pro . Funguje.
- chci se rozvíjet a budu rád za pomoc
Zdroj: habr.com
