

Druhá část:
Jakýkoli rastrový obraz můžeme představit jako dvourozměrnou matici. Když se mluví o barvách, myšlenku lze rozvinout, pokud se na obrázek podíváme jako na třírozměrnou matici, ve které se další rozměry používají k ukládání dat pro každou z barev.
Pokud považujeme konečnou barvu za kombinaci tzv. základních barev (červené, zelené a modré), určujeme v naší třírozměrné matici tři roviny: první pro červenou barvu, druhou pro zelenou a poslední pro modrou.
Každý bod v této matici budeme nazývat pixelem (elementem obrázku). Každý pixel obsahuje informace o intenzitě (obvykle ve formě číselné hodnoty) každé barvy. Například, červený pixel znamená, že v něm je 0 zelené, 0 modré a maximum červené. Pixel růžové barvy může být vytvořen pomocí kombinace třech barev. Použitím číselného rozsahu od 0 do 255 je růžový pixel definován jako Červená = 255, Zelená = 192 a Modrá = 203.
Článek byl publikován za podpory společnosti EDISON.Vyvíjíme , stejně jako se zabýváme .
Alternativní způsoby kódování barevného obrazu
Pro zobrazení barev, z nichž se obraz skládá, existuje mnoho dalších modelů. Například lze použít indexovanou paletu, která vyžaduje pouze jeden bajt pro reprezentaci každého pixelu, místo tří, které jsou potřebné při použití modelu RGB. V takovém modelu lze použít 2D matici místo 3D matice pro zobrazení každé barvy. To šetří paměť, ale poskytuje menší barevný rozsah.
RGB
Například se podívejte na tento obrázek níže. První tvář je zcela vybarvena. Ostatní jsou červené, zelené a modré roviny (intenzita odpovídajících barev je zobrazena na stupnici šedé).
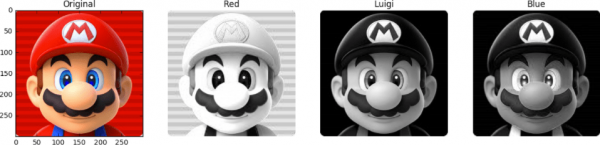
Vidíme, že odstíny červené v originále budou na stejných místech, kde se nacházejí nejjasnější části druhé osoby. Zatímco přínos modré barvy je většinou vidět pouze v očích Maria (poslední osoba) a prvcích jeho oblečení. Všimněte si, kde všechny tři barevné plochy přispívají nejméně (nejtmavší části obrázků) — to jsou kníry Maria.
Pro uchování intenzity každé barvy je potřeba určité množství bitů — toto množství se nazývá bitová hloubka. Řekněme, že se používá 8 bitů (na základě hodnoty od 0 do 255) na jednu barevnou plochu. Pak máme hloubku barvy 24 bitů (8 bitů * 3 plochy R/G/B).
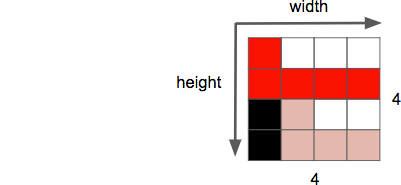
Další vlastností obrázku je rozlišení, které představuje množství pixelů v jednom rozměru. Často se označuje jako šířka × výška, jak je níže na obrázku s příkladem 4 na 4.
Ještě jedna vlastnost, se kterou se setkáváme při práci s obrázky/videem — to je poměr stran, popisující obvyklý proporcionální vztah mezi šířkou a výškou obrázku nebo pixelu.
Když se říká, že nějaký film nebo obrázek má rozměr 16 na 9, obvykle se tím myslí poměr stran displeje (DAR — ze Display Aspect Ratio). Ale někdy mohou mít různé tvary jednotlivé pixely — v tomto případě mluvíme o poměru pixelů (PAR — ze Pixel Aspect Ratio).
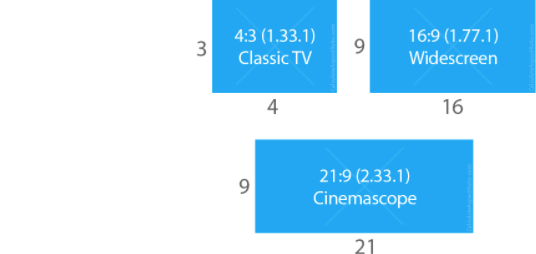
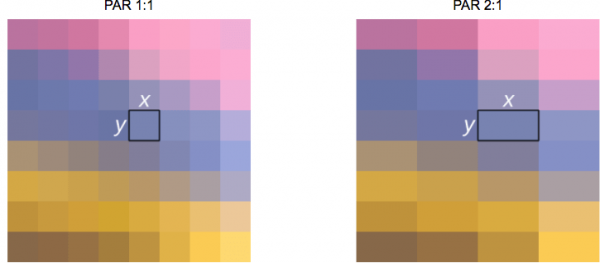
Domácí hospodyňce na paměti: DVD odpovídá DAR 4 na 3
I když skutečné rozlišení DVD je 704×480, přesto udržuje poměr stran 4:3, protože PAR má hodnotu 10:11 (704×10 / 480×11).
A nakonec můžeme definovat video jako sekvenci n snímků v průběhu času, kterou lze považovat za další rozměr. A n potom — to je snímková frekvence nebo počet snímků za sekundu (FPS — ze Frames per Second).
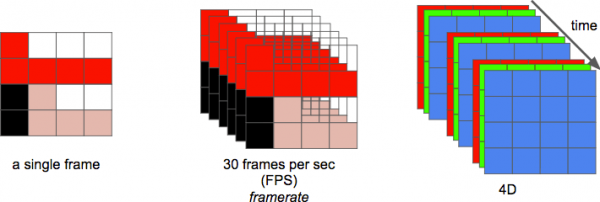
Počet bytů za sekundu potřebných pro zobrazení videa je jeho přenosová rychlost — bitrate.
bitrate = šířka * výška * bitová hloubka * snímky za sekundu
Například pro video s 30 snímky za sekundu, 24 bity na pixel, rozlišením 480×240 bude potřeba 82,944,000 bitů za sekundu nebo 82,944 Mbit/s (30x480x240x24) — ale to je pokud není použit žádný z kompresních metod.
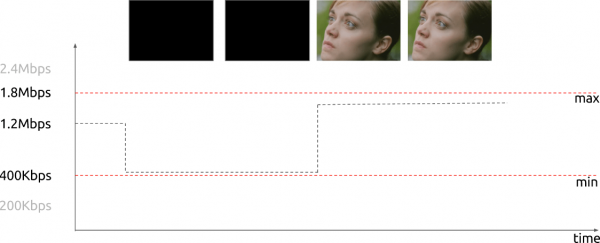
Pokud je přenosová rychlost téměř konstantní, pak se nazývá konstantní přenosová rychlost (CBR — ze constant bit rate). Může se však také lišit, v takovém případě se nazývá proměnná rychlost přenosu (VBR — ze proměnná bitová rychlost).
Graf ukazuje omezené VBR, kdy se netráví příliš mnoho bitů v případě zcela tmavého snímku.
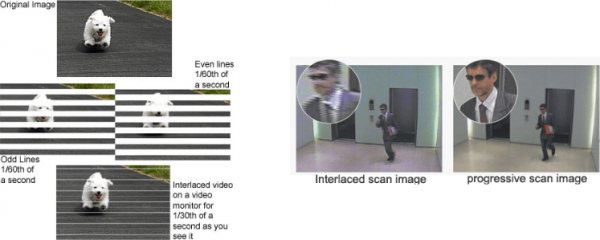
Inženýři původně vyvinuli metodu zdvojení vnímané snímkové frekvence video displeje bez použití další šířky pásma. Tato metoda je známa jako prokládané video; převážně odesílá polovinu obrazovky v první "snímkě" a druhou polovinu v dalším "snímkě".
V současnosti vizualizace scén převážně probíhá za použití technologie progresivního skenování. Je to způsob zobrazení, uchovávání nebo přenosu pohyblivých obrázků, kde se všechny řádky každého snímku kreslí za sebou.
Takže! Nyní víme, jak je obraz prezentován v digitální podobě, jak jsou uspořádány jeho barvy, kolik bitů za sekundu utrácíme na zobrazení videa, pokud je přenosová rychlost konstantní (CBR) nebo variabilní (VBR). Víme o určeném rozlišení s použitím určené snímkové frekvence, seznámili jsme se s mnoha dalšími termíny, jako je prokládané video, PAR a některé další.
Odstranění redundancy
Je známo, že video bez komprese se obvykle používat nedá. Hodinové video o rozlišení 720p a snímkové frekvenci 30 snímků za sekundu by zabíralo 278 GB. K tomuto číslu dospějeme, pokud vynásobíme 1280 x 720 x 24 x 30 x 3600 (šířka, výška, bity na pixel, FPS a čas v sekundách).
Použití algoritmů bezztrátové komprese, jako je DEFLATE (používaný v PKZIP, Gzip a PNG), nepřinese dostatečné zmenšení potřebné šířky pásma. Musíme hledat jiné způsoby komprese videa.
K tomu lze využít zvláštnosti našeho zraku. Lépe rozlišujeme jasnost než barvy. Video je soubor sekvenčních obrázků opakujících se v čase. Mezi sousedními snímky jedné scény jsou rozdíly malé. Kromě toho každý snímek obsahuje mnoho oblastí, které používají stejnou (nebo podobnou) barvu.
Barva, jasnost a naše oči
Naše oči jsou citlivější na jasnost než na barvu. Můžete se o tom sami přesvědčit, když se podíváte na tento obrázek.
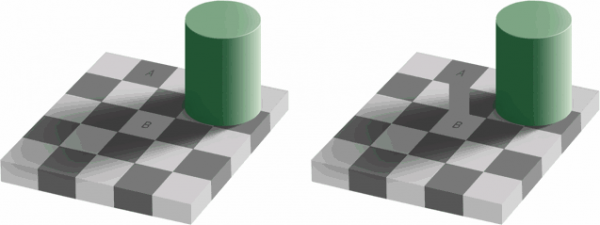
Pokud nevidíte, co je na levé polovině obrázku barevných čtverců A a B Pokud jsou ve skutečnosti stejné, je to normální. Náš mozek nás nutí věnovat více pozornosti světlu a stínu než barvám. Na pravé straně mezi označenými čtverci je přepážka stejné barvy — proto snadno rozpoznáváme, že ve skutečnosti mají stejnou barvu.
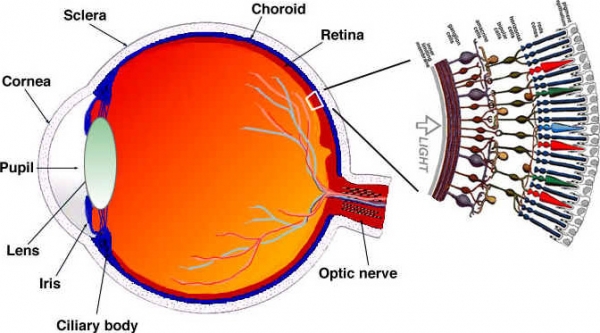
Podívejme se na to, jak naše oči fungují (zjednodušeně). Oko je složitý orgán složený z mnoha částí. Nejvíce nás však zajímají čípky a tyčinky. Oko obsahuje přibližně 120 milionů tyčinek a 6 milionů čípků.
Zvažme vnímání barev a jasu jako oddělené funkce určitých částí oka (ve skutečnosti je to trochu složitější, ale zjednodušíme to). Tyčinkové buňky hlavně odpovídají za jas, zatímco čípkové buňky odpovídají za barvu. Čípky se dělí do tří typů, podle obsaženého pigmentu: S-čípky (modrá barva), M-čípky (zelená barva) a L-čípky (červená barva).
Protože máme mnohem více tyčinek (jas) než čípků (barva), lze usuzovat, že jsme schopni lépe rozlišovat přechody mezi tmou a světlem než barvami.
Funkce kontrastní citlivosti
Výzkumníci experimentální psychologie a mnoha dalších oborů vyvinuli mnoho teorií lidského vidění. A jedna z nich se nazývá funkcemi kontrastní citlivosti. Ty souvisí s prostorovým a časovým osvětlením. Zjednodušeně řečeno, jde o to, kolik změn je potřeba, než je pozorovatel zaznamená. Všimněte si množného čísla slova „funkce“. To souvisí s tím, že můžeme měřit funkce citlivosti na kontrast nejen na černobílém, ale i barevném obraze. Výsledky těchto experimentů ukazují, že v mnoha případech jsou naše oči citlivější na jas než na barvu.
Jelikož víme, že jsme citlivější na jas obrazu, můžeme se pokusit tento fakt využít.
Barevný model
Trochu jsme se seznámili s tím, jak pracovat s barevnými obrázky pomocí RGB schématu. Existují i jiné modely. Existuje model, který odděluje jas od barevnosti a je znám jako YCbCr. Mimochodem, existují i další modely, které dělají podobné oddělení, ale zaměříme se pouze na tento.
V tomto barevném modelu Y — to je znázornění jasu, a také se používají dva barevné kanály: Cb (sytě modrá) a Cr (sytě červená). YCbCr může být získán z RGB, stejně jako může být provedena inverzní transformace. Použitím tohoto modelu můžeme vytvářet obrázky v plných barvách, jak vidíme níže:
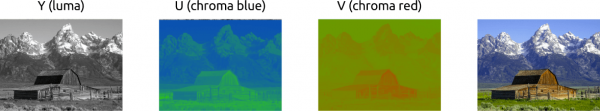
Transformace mezi YCbCr a RGB
Někdo by mohl namítnout: jak je možné získat všechny barvy, pokud se zelená nepoužívá?
Abychom odpověděli na tuto otázku, převedeme RGB na YCbCr. Využijeme koeficienty stanovené ve standardu BT.601, který byl doporučen orgánem ITU-R. Tento orgán stanovuje standardy pro digitální video. Například: Co je 4K? Jaké by měly být snímkové frekvence, rozlišení, barevný model?
Nejprve vypočítáme jas. Využijeme konstanty navržené ITU a nahradíme hodnoty RGB.
Y = 0.299R + 0.587G + 0.114B
Jakmile máme jas, oddělíme modrou a červenou barvu:
Cb = 0.564(B — Y)
Cr = 0.713(R — Y)
A také můžeme provést inverzi a dokonce získat zelenou pomocí YCbCr:
R = Y + 1.402Cr
B = Y + 1.772Cb
G = Y — 0.344Cb — 0.714Cr
Obecně platí, že displeje (monitory, televizory, obrazovky atd.) používají pouze model RGB. Ale tento model může být organizován různými způsoby:
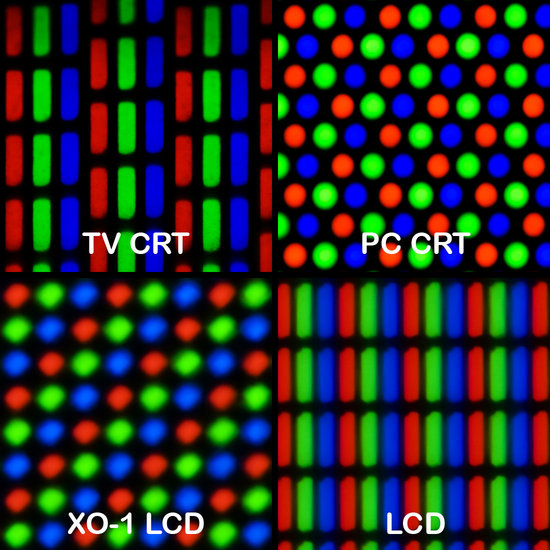
Barevná subsamplování
S obrazem představujícím kombinaci jasu a barevnosti, můžeme využít větší citlivost lidského zrakového systému na jas než na barevnost, pokud selectively eliminujeme informace. Barevná subsamplování je metoda kódování obrazů, při které se používá nižší rozlišení pro barevnost než pro jas.
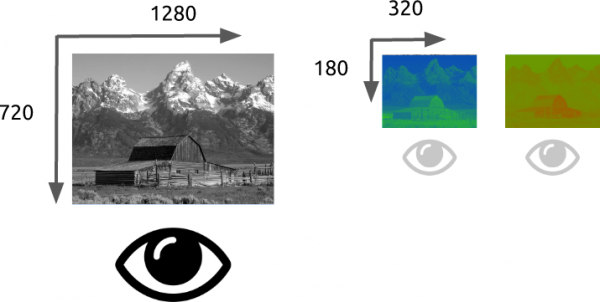
Jak moc je povoleno snižovat rozlišení barevnosti?! Ukazuje se, že už existují určité schémata, která popisují, jak zpracovávat rozlišení a sloučení (Konečná barva = Y + Cb + Cr).
Tato schémata jsou známá jako systémy subsamplování a jsou vyjádřena jako poměr 3:1 — a:x:y, který určuje počet vzorků jasových a barevnostních signálů.
a — standardní horizontální vzorek (obvykle roven 4)
x — počet vzorků barevnosti v prvním řádku pixelů (horizontální rozlišení vzhledem k a)
y — počet změn vzorků barevnosti mezi prvním a druhým řádkem pixelů.
Výjimku tvoří 4:1:0, zajišťující jeden vzorek barevnosti v každém bloku jasového rozlišení 4 na 4.
Obecné schéma používaná v moderních kodecích:
- 4:4:4 (bez subdiskretizace)
- 4:2:2
- 4:1:1
- 4:2:0
- 4:1:0
- 3:1:1
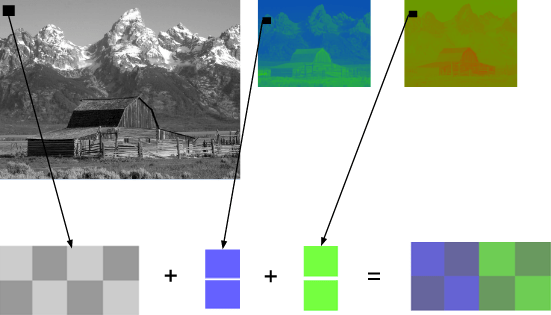
YCbCr 4:2:0 — příklad sloučení
Toto je sloučený fragment obrázku použitím YCbCr 4:2:0. Všimněte si, že využíváme pouze 12 bitů na pixel.
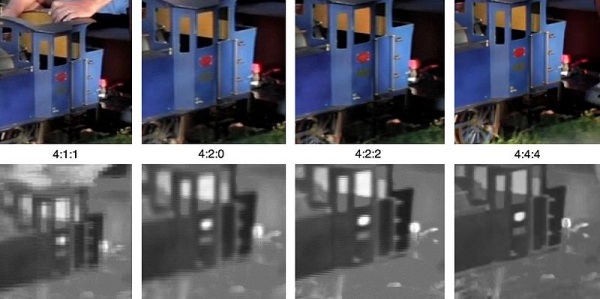
Takto vypadá stejný obrázek zakódovaný základními typy barevné subdiskretizace. První řada je konečný YCbCr, dolní řada ukazuje rozlišení barevnosti. Výsledky jsou velmi slušné, vzhledem k malým ztrátám na kvalitě.
Pamatujete, že jsme spočítali 278 GB diskového prostoru pro uchování hodinového video souboru s rozlišením 720p a 30 snímky za sekundu? Pokud použijeme YCbCr 4:2:0, velikost se sníží na polovinu — 139 GB. Přesto jsme stále daleko od přijatelného výsledku.
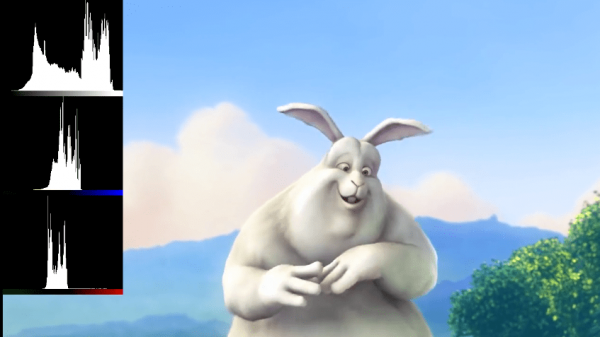
Můžete si sami získat histogram YCbCr pomocí FFmpeg. V tomto obrázku převládá modrá nad červenou, což je dobře vidět na samotném histogramu.
Barevnost, jas, barevná škála — video přehled
Doporučuje se shlédnout tohle úžasné video. Vysvětluje, co je to jas, a celkově dává věci do pořádku. o jasu a barvě. Typy snímků
Pokračujeme dál. Pokusíme se eliminovat časovou redundantnost. Ale nejprve definujme nějakou základní terminologii. Předpokládejme, že máme film s 30 snímky za sekundu, tady jsou jeho první 4 snímky:
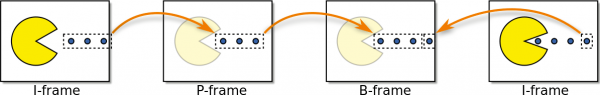
Můžeme vidět mnoho opakování ve snímcích: například modré pozadí, které se od snímku ke snímku nemění. Abychom tento problém vyřešili, můžeme je abstraktně klasifikovat jako tři typy snímků.


I-snímek (
ntro Frame)II-snímek (snímek-odkaz, klíčový snímek, vnitřní snímek) je autonomní. Bez ohledu na to, co je potřeba vizualizovat, I-snímek je v podstatě statický obrázek. První snímek je obvykle I-snímek, nicméně i mezi snímky, které nejsou na začátku, budeme pravidelně pozorovat I-snímky.
P-snímek (

Predicted Frame)P-snímek (předpovězený snímek) využívá výhodu toho, že téměř vždy může být aktuální obrázek reprodukován pomocí předchozího snímku. Například ve druhém snímku je jedinou změnou pohybující se míč vpřed. Můžeme získat snímek 2 pouhým drobným přetvořením snímku 1, přičemž využíváme rozdíl mezi těmito snímky. Pro sestavení snímku 2 se odkazujeme na předcházející snímek 1.
P-snímek (predikovaný snímek) využívá výhodu toho, že aktuální obrázek obvykle může být reprodukován s použitím předchozího snímku. Například ve druhém snímku je jedinou změnou míč, který se pohybuje vpřed. Můžeme získat snímek 2 jednoduchým mírným upravením snímku 1, pouze pomocí rozdílu mezi těmito snímky. Pro ztvárnění snímku 2 se odvoláváme na předchozí snímek 1.
 ←

B-snímek (Bi-predictive Frame)
A co odkazy nejen na minulé, ale i na budoucí snímky, abychom zajistili ještě lepší kompresi?! To je v podstatě B-snímek (obousměrný snímek).
 ←
 →

Mezivýstup
Tyto typy snímků se používají k zajištění nejlepší komprese. V následující části si rozebere, jak to funguje. Prozatím si povšimněte, že nejvíce „nákladným“ podle paměťové zátěže je I-snímek, P-snímek je výrazně levnější, ale nejvýhodnější varianta pro video je B-snímek.
Časová redundantnost (mezi-snímové predikce)
Pojďme se podívat, jaké máme možnosti pro minimalizaci časových opakování. Tento typ redundantnosti vyřešíme pomocí metod vzájemného predikování.
Budeme se snažit vynaložit co nejméně bitů na kódování sekvence snímků 0 a 1.
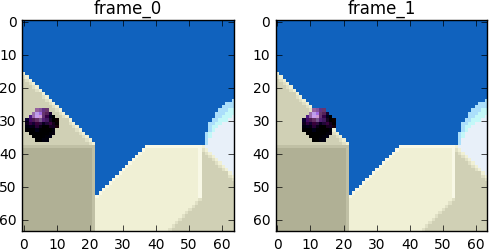
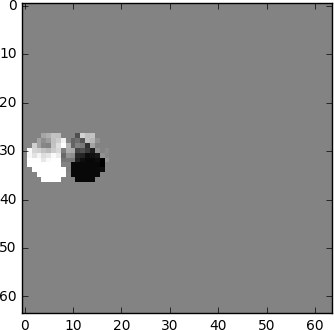
Můžeme provést odčítání, jednoduše odečteme snímek 1 od snímku 0. Získáváme snímek 1, pouze používáme rozdíl mezi ním a předchozím snímkem, v podstatě kódujeme pouze vzniklý zbytek.
Ale co když vám řeknu, že existuje ještě lepší metoda, která používá ještě méně bitů?! Nejdříve rozdělme snímek 0 na jasnou síť složenou z bloků. A poté se pokusíme přiřadit bloky ze snímku 0 k snímku 1. Jinými slovy, zhodnotíme pohyb mezi snímky.
Z Wikipedie — bloková kompenzace pohybu
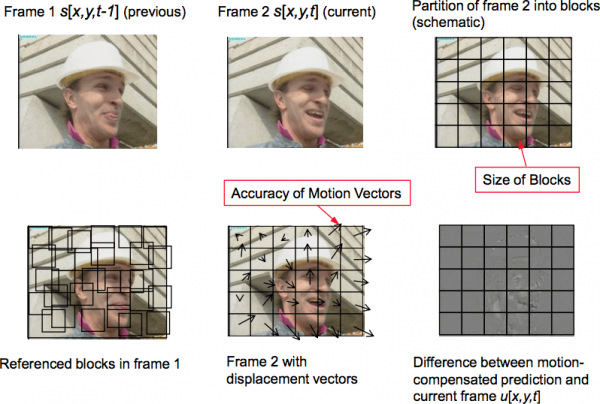
Bloková kompenzace pohybu dělí aktuální snímek na nepřekrývající se bloky a vektor kompenzace pohybu uvádí původ bloků (rozšířená chyba spočívá v tom, že předchozí snímek je dělen na nepřekrývající se bloky, a vektory kompenzace pohybu říkají, kam tyto bloky odcházejí. A ve skutečnosti je to naopak — neanalyzuje se předchozí snímek, ale následující, zjišťuje se ne kam bloky putují, ale odkud se vzaly). Obvykle jsou původní bloky překryty v původním snímku. Některé video kompresní algoritmy shromažďují aktuální snímek z částí nejen z jednoho, ale také z několika předchozích snímků.
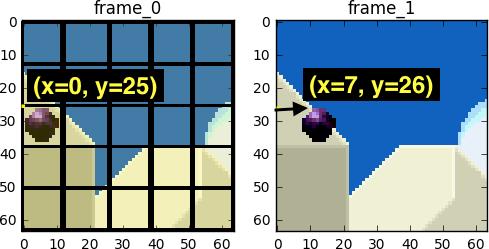
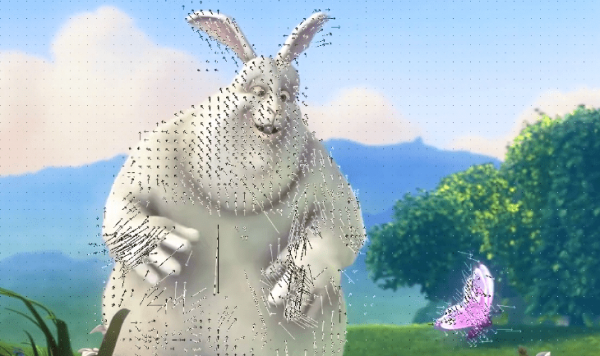
Během hodnocení vidíme, že míč se přesunul z (x=0, y=25) na (x=6, y=26), hodnoty x a y určují směr pohybu. Další krok, který můžeme podniknout, abychom uchovali bity, je kódovat pouze rozdíl vektorů pohybu mezi poslední pozicí bloku a předpokládanou, takže konečný vektor pohybu bude (x=6-0=6, y=26-25=1).
V reálné situaci by tato koule byla rozdělena na n bloky, ale to nijak nemění podstatu věci.
Objekty v záběru se pohybují ve třech dimenzích, takže při pohybu koule se může jevit jako vizuálně menší (nebo větší, pokud se pohybuje směrem k divákovi). Je normální, že mezi bloky nebude dokonalé shodování. Tady je kombinovaný pohled na naši estimaci a skutečný obraz.
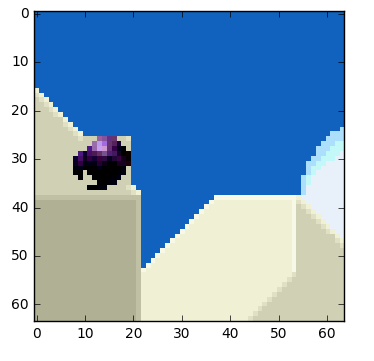
Vidíme však, že když aplikujeme odhad pohybu, dat pro kódování je výrazně méně než při použití jednodušší metody výpočtu delta mezi snímky.
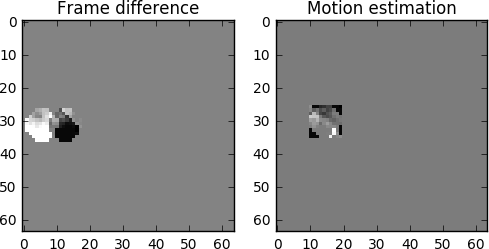
Jak by vypadala skutečná kompenzace pohybu
Tato metoda se aplikuje okamžitě na všechny bloky. Často bude náš hypotetický pohybující se míček rozdělen najednou na několik bloků.
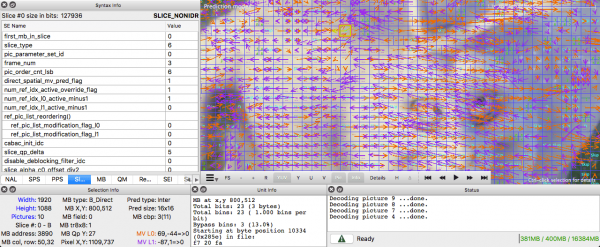
Můžete si tyto koncepty sami vyzkoušet, pomocí .
Abychom viděli vektory pohybu, můžeme vytvořit video s externím předpokladem pomocí .
Můžete také využít (je placený, ale je k dispozici bezplatná zkušební verze, která je omezena pouze na prvních deset snímků).
Prostorová redundance (vnitřní predikce)
Pokud analyzujeme každý snímek ve videu, objevíme mnoho vzájemně propojených oblastí.
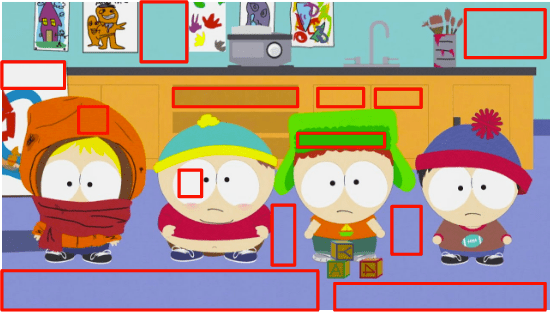
Pojďme se podívat na tento příklad. Tato scéna se převážně skládá z modré a bílé barvy.
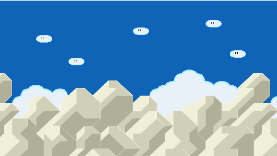
Toto je I-snímek. Předchozí snímky pro predikci nemůžeme použít, ale podaří se nám ho zkomprimovat. Zakódujeme vymezení červeného bloku. Pokud se podíváme na jeho sousedy, všimneme si, že kolem něj jsou nějaké barevné tendence.
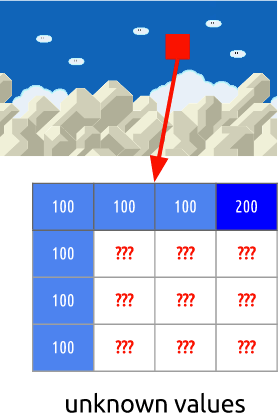
Předpokládáme, že v záběru se barvy šíří svisle. Což znamená, že barvy neznámých pixelů budou obsahovat hodnoty svých sousedů.
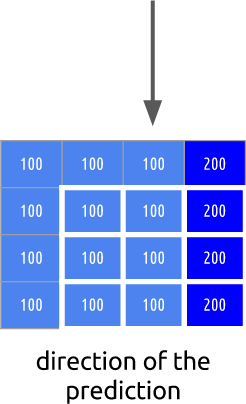
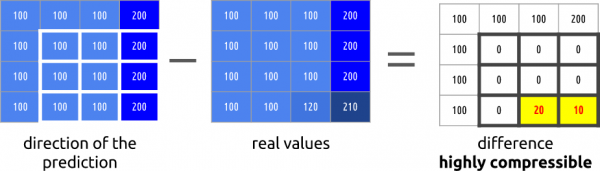
Tato predikce může být také chybná. Právě proto je třeba aplikovat tuto metodu (vnitřní predikce) a poté ještě odečíst skutečné hodnoty. To nám dá zbytkový blok, což povede k mnohem komprimovanější matici ve srovnání s originálem.
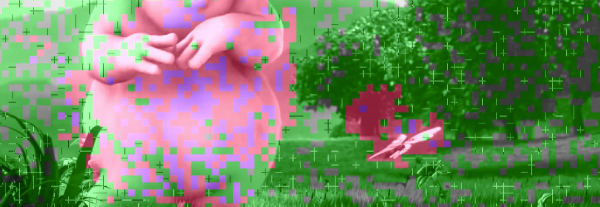
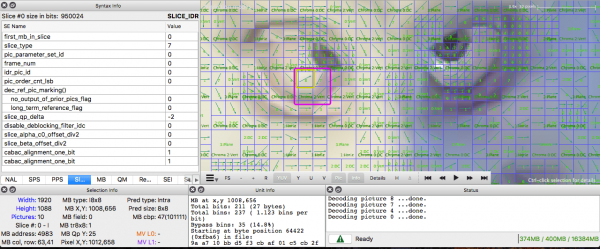
Pokud chcete praktikovat interní predikce, můžete vytvořit video s makrobloky a jejich predikcemi pomocí ffmpeg. Abyste porozuměli významu každé barvy bloku, budete si muset prostudovat dokumentaci ffmpeg.
Nebo můžete použít Intel Video Pro Analyzer (jak jsem již zmínil výše, v zkušební bezplatné verzi je omezení na prvních 10 snímků, ale na začátku vám to stačí).
Druhá část:
Zdroj: habr.com
