

První část:
Co? Video kodek je část softwaru/hardwaru, která komprimuje a/nebo dekomprimuje digitální video.
Proč? Navzdory určitým omezením jak v propustnosti, tak
a v množství místa pro ukládání dat, trh vyžaduje stále kvalitnější video. Pamatujete, jak jsme v minulém příspěvku spočítali minimální požadavky pro 30 snímků za sekundu, 24 bitů na pixel, s rozlišením 480×240? Dosáhli jsme 82,944 Mbit/s bez komprese. Komprese je zatím jediný způsob, jak vůbec přenášet HD/FullHD/4K na televizní obrazovky a na Internet. Jak se to dosahuje? Nyní stručně přehledneme základní metody.
Překlad byl proveden za podpory společnosti EDISON Software.Zabýváme se , a také .
Kodek vs Kontejner
Běžná chyba začátečníků je zaměňovat kodek digitálního videa a kontejner digitálního videa. Kontejner je jakýsi formát. Obal, obsahující metadata videa (a možná i zvuku). Komprimované video lze považovat za užitečné zatížení kontejneru.
Obvykle přípona video souboru naznačuje jeho typ kontejneru. Například, soubor video.mp4 je pravděpodobně kontejner MPEG-4 Part 14, zatímco soubor s názvem video.mkv je spíše . Abychom si byli zcela jisti kodekem a formátem kontejneru, můžeme využít nebo .
Trocha historie
Než se dostaneme k Jak?, pojďme se trochu ponořit do historie, abychom lépe pochopili některé staré kodeky.
Video kodek H.261 se objevil v roce 1990 (technicky v roce 1988) a byl vytvořen pro práci při přenosové rychlosti 64 kbit/s. Již v něm byly použity myšlenky, jako je barevná subdiskretizace, makrobloky atd. V roce 1995 byl zveřejněn standard video kodeku H.263, který se vyvíjel až do roku 2001.
V roce 2003 byla dokončena první verze H.264/AVC. Ve stejném roce společnost "TrueMotion" vydala svůj bezplatný video kodek, který komprimoval video se ztrátami nazvaný VP3. V roce 2008 Google koupil tuto společnost a vydal VP8 ve stejném roce. V prosinci 2012 Google vydal VP9, a ten je podporován přibližně na ¾ trhu prohlížečů (včetně mobilních zařízení).
AV1 je nový bezplatný video kodek s otevřeným zdrojovým kódem, vyvinutý Aliancí za otevřená média (AOMedia), jehož součástí jsou známé společnosti jako Google, Mozilla, Microsoft, Amazon, Netflix, AMD, ARM, NVidia, Intel a Cisco. První verze kodeku 0.1.0 byla zveřejněna 7. dubna 2016.
Zrození AV1
Na začátku roku 2015 Google pracoval na VP10, Xiph (patřící Mozilla) pracoval na Daala, a Cisco vytvořilo svůj bezplatný video kodek pojmenovaný Thor.
Dále MPEG LA nejprve oznámila roční limity pro HEVC (H.265) a poplatky, které byly 8krát vyšší než u H.264, ale brzy poté znovu změnili pravidla:
bez ročního limitu,
poplatek za obsah (0,5 % z příjmů) a
poplatek za jednotku produktu zhruba 10krát vyšší než za H.264.
Aliance za otevřená média byla vytvořena společnostmi z různých oblastí: výrobci hardwaru (Intel, AMD, ARM, Nvidia, Cisco), poskytovateli obsahu (Google, Netflix, Amazon), tvůrci prohlížečů (Google, Mozilla) a dalšími.
Společnosti měly společný cíl - video kodek bez licenčních poplatků. Poté se objevil AV1 s mnohem jednodušší patentovou licencí. Timothy B. Terriberry provedl ohromující prezentaci, která se stala základem pro současnou koncepci AV1 a její licenční model.
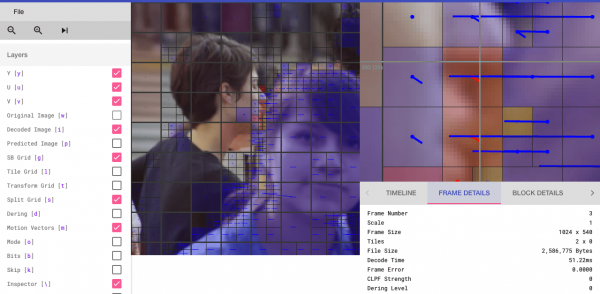
Budete překvapeni, když zjistíte, že kodek AV1 lze analyzovat přímo v prohlížeči (zájemci se mohou podívat na).
Univerzální kodek
Podíváme se na základní mechanismy, které stojí za univerzálním video kodekem. Většina těchto konceptů je užitečná a používá se v moderních kodecích, jako jsou VP9, AV1 a HEVC. Varuji, že mnohé vysvětlované věci budou zjednodušeny. Někdy budou použity reálné příklady (jako v případě H.264) pro demonstraci technologií.
1. krok - rozdělení obrazu
Prvním krokem je rozdělení snímku na několik částí, podčástí a dále.
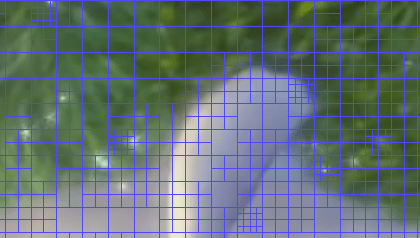
Proč? Existuje mnoho důvodů. Když rozdělujeme obrázek, můžeme přesněji předpovědět vektor pohybu, přičemž používáme malé části pro malé pohybující se části. Zatímco pro statické pozadí lze využít i větší části.
Obvykle kodeky organizují tyto části do sekcí (nebo fragmentů), makrobloků (nebo bloků kódovacího stromu) a mnoha podčástí. Maximální velikost těchto částí se liší, HEVC stanoví 64×64, zatímco AVC používá 16×16, a podčásti mohou být rozděleny na velikosti až 4×4.
Pamatujete si různé typy rámců z minulého článku?! To lze aplikovat i na bloky, takže můžeme mít I-fragment, B-blok, P-makroblok atd.
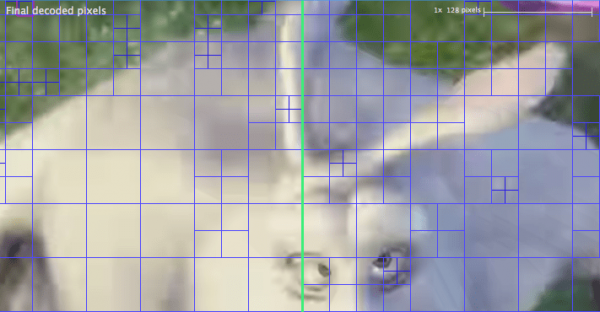
Pro ty, kteří chtějí trénovat — podívejte se, jak se obraz rozbije na sekce a podsekce. K tomu můžete využít již zmiňované způsoby z minulého článku. (ten placený, ale s bezplatnou zkušební verzí, která má omezení na prvních 10 rámců). Zde jsou analyzovány sekce. VP9:
2. krok — prognózování
Jakmile máme sekce, můžeme na jejich základě vytvářet astrologické předpovědi. Pro INTER-prognózování je třeba předat vektory pohybu a zbytek, a pro INTRA-prognózování se předává směr předpovědi a zbytek.
3. krok — transformace
Poté, co získáme zbytkový blok (predikovaná sekce → skutečná sekce), je možné jej transformovat tak, abychom věděli, které pixely můžeme vyřadit, přičemž si zachováme celkovou kvalitu. Existují některé transformace, které zajišťují přesné chování.
Ačkoli existují i další metody, podívejme se podrobněji na diskrétní kosinovou transformaci (DCT — ze discrete cosine transform). Hlavní funkce DCT:
- Převádí bloky pixelů na stejně velké bloky frekvenčních koeficientů.
- Kompaktizuje energii, což pomáhá eliminovat prostorovou nadbytečnost.
- Zajišťuje návratnost.
2. února 2017 publikovali Cintra R.J. a Bayer F.M. článek o DCT-podobné transformaci pro kompresi obrazů, která vyžaduje pouze 14 doplnění.
Nebojte se, pokud jste nepochopili výhody každého bodu. Teď si na konkrétních příkladech ověříme jejich skutečnou hodnotu.
Vezměme si tento blok pixelů 8×8:
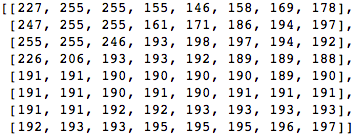
Tento blok se renderuje do následujícího obrázku 8 na 8 pixelů:
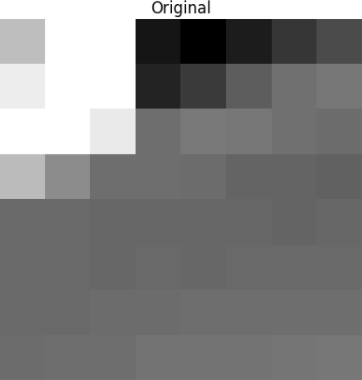
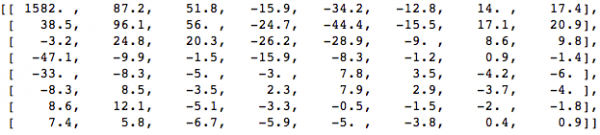
Aplikujeme DCT na tento blok pixelů a získáme blok koeficientů o velikosti 8×8:
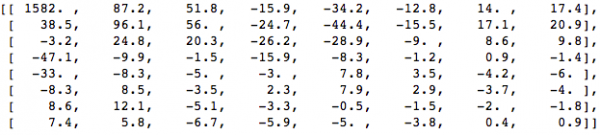
A pokud ten blok koeficientů renderujeme, dostaneme takový obrázek:
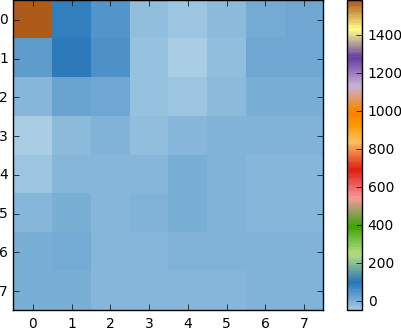
Jak vidíme, to nevypadá jako původní obrázek. Můžeme si všimnout, že první koeficient se výrazně liší od všech ostatních. Tento první koeficient je známý jako DC-koeficient, který reprezentuje všechny vzorky ve vstupním poli, něco podobného průměrné hodnotě.
Tento blok koeficientů má zajímavou vlastnost: odděluje vysokofrekvenční komponenty od nízkofrekvenčních.
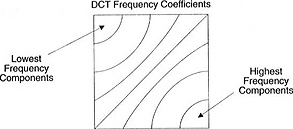
Na obrázku je většina energie soustředěna na nižších frekvencích, proto pokud převedeme obrázek na jeho frekvenční komponenty a eliminujeme vyšší koeficienty, můžeme snížit množství dat potřebných k popisu obrázku, aniž bychom příliš obětovali kvalitu obrazu.
Frekvence znamená, jak rychle se signál mění.
Zkusme aplikovat znalosti získané v testovém příkladu a převést původní obrázek na jeho frekvenci (blok koeficientů) pomocí DCT, a poté eliminovat část méně důležitých koeficientů.
Nejprve ho převedeme do frekvenční oblasti.
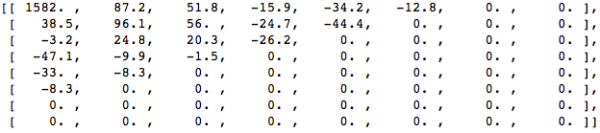
Poté eliminujeme 67 % koeficientů, většinou z pravého dolního rohu.
Nakonec obnovíme obrázek z tohoto eliminovaného bloku koeficientů (pamatujte, mělo by to být vratné) a porovnáme ho s originálem.
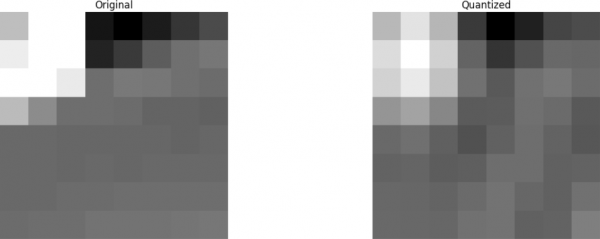
Vidíme, že připomíná původní obrázek, ale existuje mnoho rozdílů od originálu. Eliminovali jsme 67,1875 % a stále jsme získali něco, co připomíná prvotní zdroj. Mohli jsme koeficienty eliminovat promyšleněji, abychom získali obrázek ještě lepší kvality, ale to už je další téma.
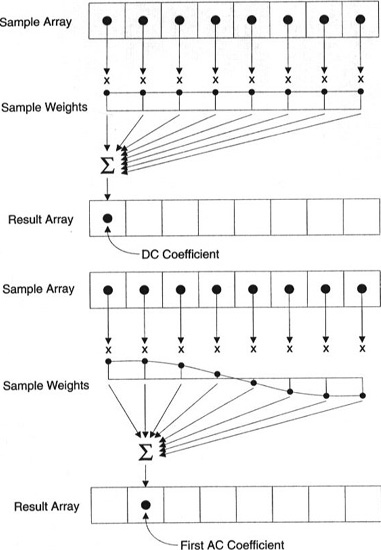
Každý koeficient je vytvořen pomocí všech pixelů.
Je důležité vědět, že každý koeficient přímo neodpovídá jednomu pixelu, ale představuje vážený součet všech pixelů. Tento úžasný graf ukazuje, jak se vypočítávají první a druhý koeficient s použitím vah unikátních pro každý index.
Můžete se také pokusit vizualizovat DCT pohledem na jednoduché vytváření obrázku na jeho základě. Například zde je symbol A, který je tvořen pomocí každé váhy koeficientu:
4. krok — kvantování
Po tom, co v předchozím kroku eliminujeme některé koeficienty, v posledním kroku (transformace) provádíme speciální formu kvantování. V této fázi je přípustné ztrácet informace. Nebo jednoduše řečeno, budeme kvantovat koeficienty pro dosažení komprese.
Jak kvantovat blok koeficientů? Jednou z nejjednodušších metod je rovnoměrné kvantování, kdy vezmeme blok, rozdělíme ho na jednu hodnotu (na 10) a zaokrouhlíme to, co dostaneme.
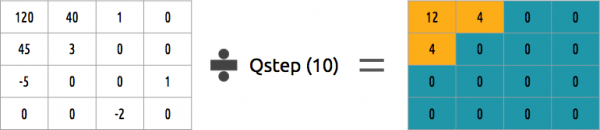
Můžeme tento blok koeficientů převrátit? Ano, můžeme, když jej vynásobíme stejnou hodnotou, kterou jsme dělili.
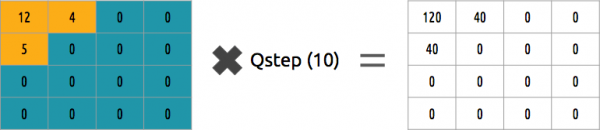
Tento přístup není nejlepší, protože nezohledňuje důležitost každého koeficientu. Můžeme použít matici kvantizátorů namísto jedné hodnoty, a tato matice může využít vlastnost DCT, kvantujíce většinu dolních pravých a menšinu horních levých.
5. krok — entropické kódování
Poté, co jsme kvantovali data (bloky obrazů, fragmenty, snímky), můžeme je stále bez ztrát zkomprimovat. Existuje mnoho algoritmických způsobů komprese dat. Krátce si přiblížíme některé z nich, pro hlubší pochopení si můžete přečíst knihu „Rozumění kompresi: Komprese dat pro moderní vývojáře“ (»).
Kódování videa pomocí VLC
Předpokládejme, že máme proud symbolů: a, e, jsou rovny nule. a t. Pravděpodobnost (v rozsahu od 0 do 1), jak často se každý symbol v proudu objevuje, je uvedena v této tabulce.
| a | e | jsou rovny nule. | t | |
|---|---|---|---|---|
| Pravděpodobnost | 0,3 | 0,3 | 0,2 | 0,2 |
Můžeme přiřadit jedinečné binární kódy (preferovaně malé) nejpravděpodobnějším a větší kódy méně pravděpodobným.
| a | e | jsou rovny nule. | t | |
|---|---|---|---|---|
| Pravděpodobnost | 0,3 | 0,3 | 0,2 | 0,2 |
| Binární kód | 0 | 10 | 110 | 1110 |
Kompresujeme proud s předpokladem, že nakonec vynaložíme 8 bitů na každý symbol. Bez komprese by každý symbol zabral 24 bitů. Pokud každý symbol nahradíme jeho kódem, dojde k úspoře!
První krok spočívá v kódování symbolu e, který je roven 10, a druhý symbol je a, který se přidává (ne matematicky): [10] [0], a nakonec třetí symbol t, což činí náš finální komprimovaný bitový proud rovný [10] [0] [1110] nebo také 1001110, k čemuž je zapotřebí pouze 7 bitů (o 3,4 méně místa než v originále).
Všimněte si, že každý kód musí být jedinečným prefixovým kódem. pomůže najít tato čísla. Ačkoli tento způsob není bez nedostatků, existují video kodeky, které stále nabízejí tuto algoritmickou metodu pro kompresi.
Jak kodér, tak dekodér musí mít přístup k symbolové tabulce se svými binárními kódy. Proto je také nutné odeslat ve vstupních datech i tabulku.
Aritmetické kódování
Předpokládejme, že máme proud symbolů: a, e, jsou rovny nule., s a t, a jejich pravděpodobnost je prezentována touto tabulkou.
| a | e | jsou rovny nule. | s | t | |
|---|---|---|---|---|---|
| Pravděpodobnost | 0,3 | 0,3 | 0,15 | 0,05 | 0,2 |
S touto tabulkou vytvoříme intervaly, které obsahují všechny možné symboly, seřazené podle počtu.
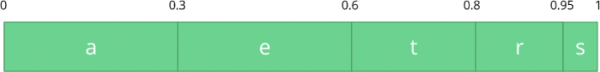
Nyní zakódujme proud ze tří symbolů: eat.
Nejprve vybíráme první symbol e, který se nachází v podintervale od 0,3 do 0,6 (nezahrnuto). Bereme tento podinterval a znovu ho dělíme ve stejných proporcích jako dříve, ale už pro tento nový interval.
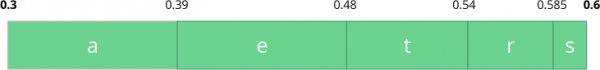
Pokračujme v kódování našeho proudu eat. Nyní bereme druhý symbol a, který se nachází v novém podintervale od 0,3 do 0,39, a poté bereme náš poslední symbol t a, opakujíc stejný proces, získáme poslední podinterval od 0,354 do 0,372.
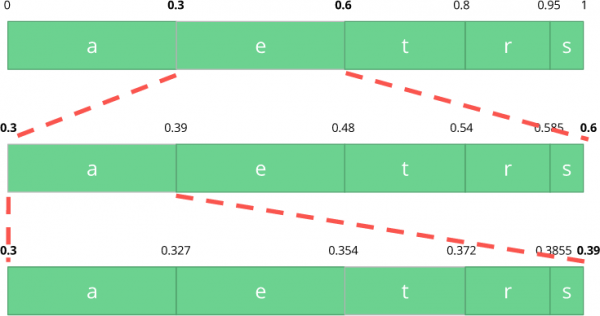
Stačí vybrat číslo v posledním podintervale od 0,354 do 0,372. Zvolme 0,36 (ale můžeme vybrat i jakékoli jiné číslo v tomto podintervalu). Pouze s tímto číslem budeme schopni obnovit náš původní proud. Je to jako kdybychom kreslili čáru v rozmezí pro kódování našeho proudu.
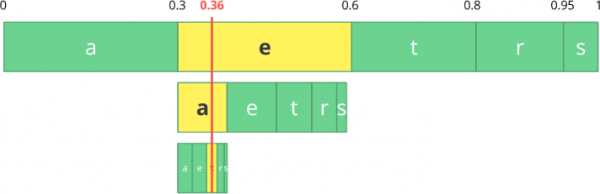
Zpětná operace (tedy dekódování) je také jednoduchá: s naším číslem 0,36 a naším počátečním rozsahem můžeme spustit stejný proces. Ale nyní, s použitím tohoto čísla, odhalujeme proud, zakódovaný tímto číslem.
S prvním rozsahem vidíme, že naše číslo odpovídá úseku, tedy to je náš první symbol. Nyní znovu rozdělujeme tento podinterval a vykonáváme stejný proces jako dříve. Zde můžeme vidět, že 0,36 odpovídá symbolu a, a po opakování procesu jsme došli k poslednímu symbolu t (formující náš původní zakódovaný proud. eat).
Jak pro kodéra, tak pro dekodéra by měla být k dispozici tabulka pravděpodobností symbolů, proto je nutné odeslat také ji ve vstupních datech.
Docela elegantní, že? Někdo, kdo vymyslel toto řešení, byl zatraceně chytrý. Některé video kodeky tuto techniku používají (nebo ji alespoň nabízejí jako možnost).
Myšlenka spočívá v bezztrátovém zhuštění kvantizovaného bitového toku. Určitě v tomto článku chybí spousta detailů, důvodů, kompromisů atd. Ale pokud jste vývojář, měli byste vědět víc. Nové kodeky se pokoušejí používat různé algoritmy entropického kódování, jako jsou ANS.
6 krok — formát bitového toku
Jakmile je vše hotovo, zbývá rozbalit zhuštěné snímky v kontextu provedených kroků. Je nutné jasně informovat dekodér o rozhodnutích přijatých kodérem. Dekodéru musí být poskytnuty všechny potřebné informace: bitová hloubka, barevný prostor, rozlišení, informace o predikcích (vektory pohybu, směrové INTER-predikce), profil, úroveň, snímková frekvence, typ snímku, číslo snímku a mnohem více.
Náš pohled na bitový tok je povrchní. H.264Naším prvním krokem je vytvoření minimálního bitového toku H.264 (FFmpeg standardně přidává všechny parametry kódování, jako jsou SEI NAL — o tom se dozvíme později). Můžeme to udělat pomocí našeho vlastního repozitáře a FFmpeg.
. /s/ffmpeg -i /files/i/minimal.png -pix_fmt yuv420p /files/v/minimal_yuv420.h264
Tento příkaz vygeneruje nekomprimovaný bitový tok H.264 s jedním snímkem, rozlišením 64×64, s barevným prostorem YUV420. Jako snímek se používá následující obrázek.

Bitový tok H.264
Standard AVC (H.264) definuje, že informace budou zasílány ve velkých snímcích (v síťovém smyslu), nazývaných NAL (to je úroveň abstrakce sítě). Hlavním cílem NAL je poskytnout video v „síti přátelském“ formátu. Tento standard by měl fungovat na televizorech (na základě streamů), na internetu (na základě paketů).

Existuje synchronizační marker pro určení hranic prvků NAL. Každý synchronizační marker obsahuje hodnotu 0x00 0x00 0x01, s výjimkou prvního, který je roven 0x00 0x00 0x00 0x01. Pokud spustíme hexdump pro vygenerovaný bitový tok H.264, identifikujeme alespoň tři vzory NAL na začátku souboru.
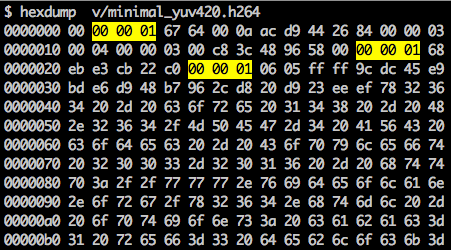
Jak bylo zmíněno, dekodér musí znát nejen data obrazu, ale také detaily videa, snímku, barvy, použité parametry a mnohem více. První bajt každého NAL určuje jeho kategorii a typ.
| Identifikátor typu NAL | Popis |
|---|---|
| 0 | Neznámý typ |
| 1 | Kódovaný fragment obrazu bez IDR |
| 2 | Kódovaná část datového proudu A |
| 3 | Kódovaná část datového proudu B |
| 4 | Kódovaná část datového proudu C |
| 5 | Kódovaný IDR fragment IDR obrázku |
| 6 | Další informace o rozšíření SEI |
| 7 | Sada parametrů sekvence SPS |
| 8 | Sada parametrů PPS obrázku |
| 9 | Separátor přístupu |
| 10 | Konec sekvence |
| 11 | Konec proudu |
| … | … |
Obvykle je prvním NAL bitového proudu SPS. Tento typ NAL zajišťuje informace o obecných proměnných kódování, jako jsou profil, úroveň, rozlišení atd.
Pokud vynecháme první synchronizační marker, můžeme dekódovat první byte a zjistit, jaký typ NAL je prvním.
Například, první byte po synchronizačním markeru je 01100111, kde první bit (0) se nachází v poli forbidden_zero_bit. Další 2 bity (11) nám sdělují pole nal_ref_idc, které ukazuje, jestli je tento NAL referenčním polem nebo ne. A zbývajících 5 bitů (00111) nám sdělují pole nal_unit_type, v tomto případě je to blok SPS (7) NAL.
Druhý byte (binary=01100100, hex=0x64, dec=100) v SPS NAL je pole profile_idc, které ukazuje profil, který použil kodér. V tomto případě byl použit omezený vysoký profil (tj. vysoký profil bez podpory obousměrného B segmentu).
Pokud se podíváme na specifikaci bitového proudu H.264 pro SPS NAL, zjistíme mnoho hodnot pro název parametru, kategorii a popis. Například se podívejme na pole pic_width_in_mbs_minus_1 a pic_height_in_map_units_minus_1.
| Název parametru | Kategorie | Popis |
|---|---|---|
| pic_width_in_mbs_minus_1 | 0 | ue(v) |
| pic_height_in_map_units_minus_1 | 0 | ue(v) |
Pokud provedeme některé matematické operace s hodnotami těchto polí, získáme rozlišení. Můžeme reprezentovat 1920 x 1080, pomocí pic_width_in_mbs_minus_1 s hodnotou 119 ((119 + 1) * macroblock_size = 120 * 16 = 1920). Opět, šetříme místo, místo kódování 1920 jsme udělali to s 119.
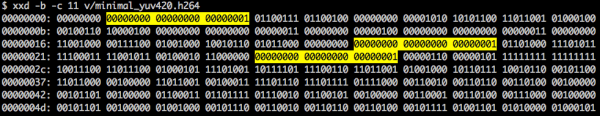
Pokud pokračujeme v ověřování našeho vytvořeného videa v binární podobě (například: xxd -b -c 11 v/minimal_yuv420.h264), přecházíme na poslední NAL, který je samotným snímkem.

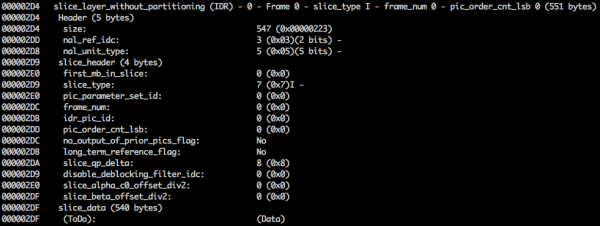
Zde vidíme jeho prvních 6 bytových hodnot: 01100101 10001000 10000100 00000000 00100001 11111111. Vzhledem k tomu, že víme, že první byte ukazuje na typ NAL, v tomto případě (00101) to je IDR fragment (5), a pak můžeme dále zkoumat:
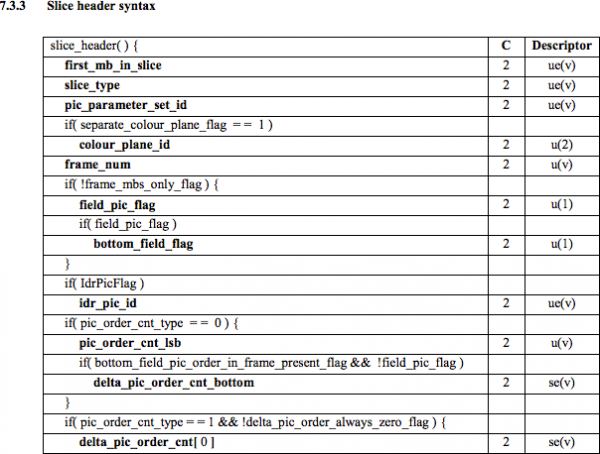
Použitím informací ze specifikace můžeme dekódovat typ fragmentu (slice_type) a číslo snímku (frame_num) mezi dalšími důležitými poli.
Abychom získali hodnoty některých polí (ue(v), já(v), se(v) nebo te(v), musíme dekódovat fragment pomocí speciálního dekodéru založeného na Tato metoda je velmi účinná pro kódování hodnot proměnných, zejména když je k dispozici mnoho výchozích hodnot.
Hodnoty slice_type a frame_num výše uvedeného videa jsou rovny 7 (I-fragment) a 0 (první snímek).
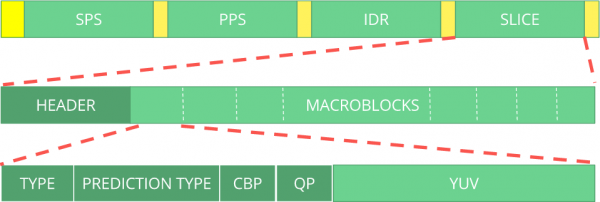
Bitový tok lze považovat za protokol. Pokud chcete vědět více o bitovém toku, měli byste se obrátit na specifikaci ITU H.264. Zde je makroschema, které ukazuje, kde se nacházejí data obrazu (YUV v komprimované podobě).
Můžete prozkoumat i další bitové toky, jako jsou VP9, H.265 (HEVC) nebo dokonce náš nový nejlepší bitový tok AV1. Jsou si všechny podobné? Ne, ale pokud pochopíte alespoň jeden, je mnohem jednodušší porozumět ostatním.
Chcete si praktikovat? Prozkoumejte bitový tok H.264
Můžete vygenerovat snímkové video a použít MediaInfo k prozkoumání bitového toku H.264. Ve skutečnosti nic nebrání podívat se i na zdrojový kód, který analyzuje bitový tok H.264 (AVC).
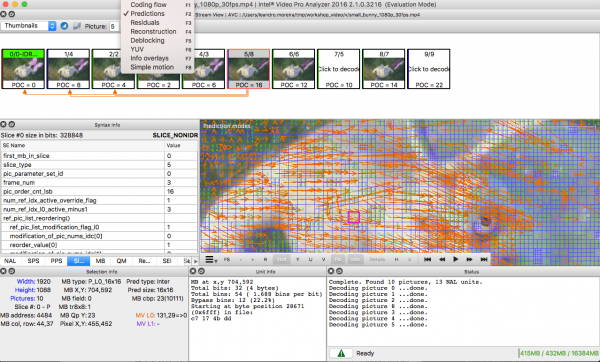
Pro praxi můžete použít Intel Video Pro Analyzer (už jsem snad říkal, že program je placený, ale existuje bezplatná zkušební verze s omezením na 10 snímků?).
Přehled
Všimněme si, že mnohé moderní kodeky používají stejný model, který jsme právě prozkoumali. Podívejme se na blokovou schému video kodeku Thor. Obsahuje všechny kroky, kterými jsme prošli. Celý smysl této poznámky je, abyste alespoň lépe chápali inovace a dokumentaci v této oblasti.
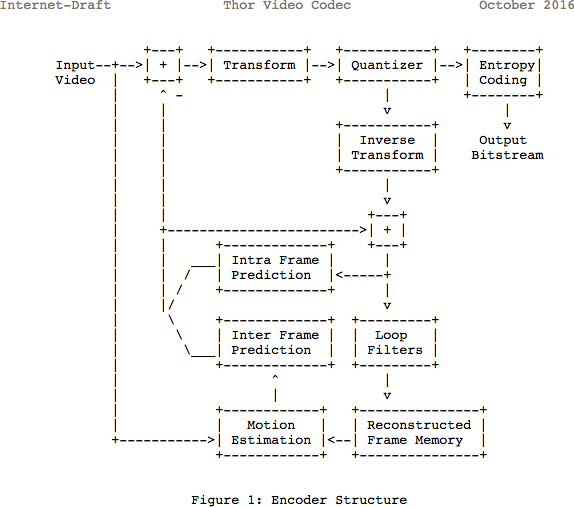
Dříve jsme spočítali, že bude potřeba 139 GB diskového prostoru pro uložení video souboru délky jednu hodinu při kvalitě 720p a 30 fps. Pokud použijete metody, které jsme probrali v tomto článku (mezikadrové a interní predikce, transformace, kvantování, entropické kódování atd.), můžete dosáhnout (s ohledem na to, že utrácíme 0,031 bitu na pixel) videa s uspokojivou kvalitou, které zabere pouze 367,82 MB, nikoli 139 GB paměti.
Jak H.265 dosahuje lepší míry komprese než H.264?
Nyní, když víte více o tom, jak fungují kodeky, je snazší rozumět tomu, jak nové kodeky mohou poskytovat vyšší rozlišení s menším množstvím bitů.
Pokud porovnáváte AVC a HEVC, mějte na paměti, že téměř vždy jde o volbu mezi větší zátěží pro CPU a mírou komprese.
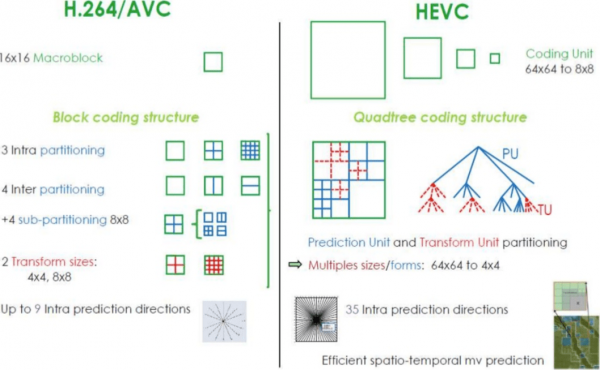
HEVC má více možností částí (a podčástí) než AVC, více interních předpovědních směrů, vylepšené entropické kódování a mnoho dalšího. Všechny tyto vylepšení udělaly H.265 schopným komprimovat o 50 % více než H.264.
První část:
Zdroj: habr.com
