

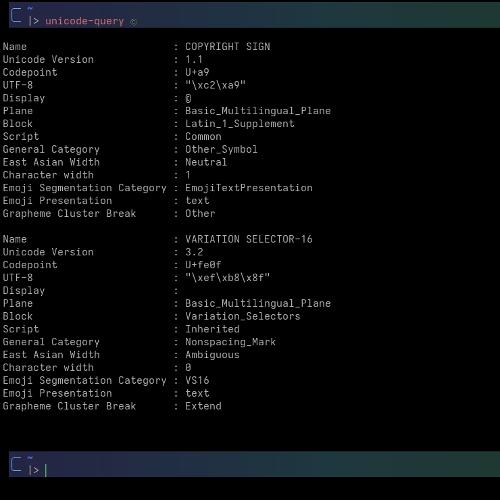
Byla vydána verze 0.9.0 knihovny pro jazyk C++ (standard C++20) libunicode. Projekt vyvíjí tým vývojářů emulátoru terminálu Contour a shell Endo (ve fázi aktivního vývoje) a distribuuje se pod licencí Apache 2.0.
- podpora standardů Unicode 17.0:
- API pro získání vlastností Unicode;
- SIMD optimalizace některých funkcí (při použití std::simd nebo std::experimental::simd, pokud jsou k dispozici);
- optimalizované převody UTF-8 UTF-16/UTF-32;
- ekvivalent funkce wcwidth (int unicode::width(char32_t));
- segmentace textu podle grafémů, znaků, emoji a písem;
- převod velikosti písmen a porovnání řetězců;
- vysokoúrovňové API pro segmentaci textu, vhodné pro implementaci tvarování textu.
- pokrytí testy většiny funkcí knihovny (šířka znaku a segmentace).
Sada také obsahuje konzolovou utilitu unicode-query pro získání podrobných informací o řetězcích.
Změny:
- přidáno API grapheme_cluster_width;
- vylepšení v manipulaci s verzemi Unicode („Age“);
- plná podpora UAX #15 Normy normalizace Unicode s podporou streamingu:
normalizer norm(Normalization_Form::NFC); // Zpracování rozloženého e + spoilující akcent, pak nový startér pro spuštění emise auto result = norm.feed(U’e’); CHECK(result.empty()); // stále vyrovnávám result = norm.feed(U’u0301′); CHECK(result.empty()); // stále vyrovnávám (kombinující značka) result = norm.feed(U’x’); // startér spouští emisi předchozího segmentu REQUIRE_FALSE(result.empty()); CHECK(result == U"u00E9"); // e + akcent složeno do e-akcentu result = norm.flush(); CHECK(result == U"x"); // konečný segment
- funkce script_extensions nyní vrací std::optional<std::span>;
- implementováno pravidlo GB9c pro rozdělení skupin grafémů pro kombinace znaků v jazycích skupiny Indic;
- v grapheme_segmenter byla opravena pravidla pro GB11 a GB4/GB5; zastaralé API bylo odstraněno;
- implementováno SIMD-optimalizované konvertování UTF-8 do UTF-16/UTF-32;
- šířka spojovacích znaků Hangul V/T je nyní nulová;
- implementováno segmentování podle hranic slov;
- opravy v C API;
- refaktorování systému sestavování a pomocného generátoru tabulek C++;
- byly přidány komplexní testy pro převod UTF-16/UTF-32;
- v CI byla přidána statická verze utility unicode-query.
Zdroj: linux.org.ru
