

Nedávno vyšlo , které dobře ukazuje trendy ve strojovém učení posledních let. Stručně řečeno: počet startupů v oblasti strojového učení v posledních dvou letech rapidně klesl.
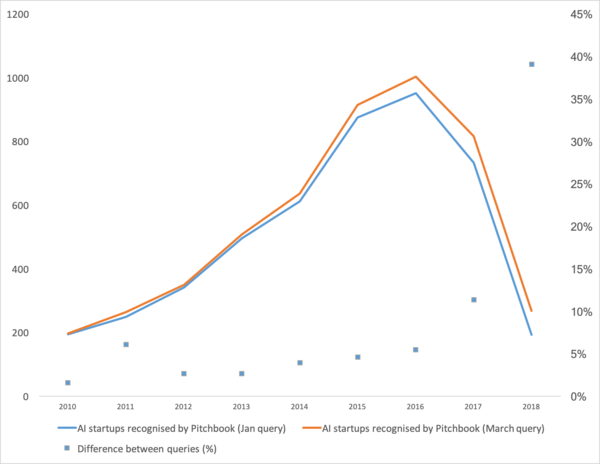
No co. Podíváme se na to, zda «praskl bubble», «jak dál žít» a probereme, odkud se to všechno vzalo.
Nejprve si povíme, co bylo tím impulsem tohoto trendu. Odkud přišel. Snad si všichni vzpomenou strojového učení v roce 2012 v soutěži ImageNet. Přece jen to bylo první globální událost! Ale ve skutečnosti to tak není. A růst trendu začíná o něco dříve. Rozdělil bych ho na několik momentů.
- Rok 2008 znamenal vznik termínu „velká data“. Skutečné produkty začaly od roku 2010. Velká data jsou přímo spojena se strojovým učením. Bez velkých dat není stabilní fungování algoritmů, které v té době existovaly. A to nejsou neuronové sítě. Do roku 2012 byly neuronové sítě záležitostí marginální menšiny. Zato v té době začaly fungovat zcela jiné algoritmy, které existovaly už léta, nebo dokonce desetiletí: (1963, 1993), (1995), (2003),… Startupy té doby byly převážně spojeny s automatizovaným zpracováním strukturovaných dat: pokladny, uživatelé, reklama, a mnohé další.
Odvozenina této první vlny — soubor frameworků, jako jsou XGBoost, CatBoost, LightGBM, atd.
- V letech 2011-2012 vyhrály sérii soutěží v rozpoznávání obrazů. Jejich skutečné použití se trochu zpozdilo. Řekl bych, že masově zaměřené startupy a řešení začala vznikat až od roku 2014. Dva roky trvalo, než se strávil fakt, že neuronky opravdu fungují, vytvořit uživatelsky přívětivé frameworky, které mohly být nainstalovány a spuštěny v rozumném čase, vyvinout metody, které by stabilizovaly a zrychlily čas konvergence.
Konvoluční sítě umožnily řešit úkoly strojového vidění: klasifikace obrazů a objektů na obrázku, detekce objektů, rozpoznávání objektů a lidí, zlepšování obrazů, atd., atp.
- Roky 2015-2017. Boom algoritmů a projektů založených na rekurentních sítích nebo jejich analogích (LSTM, GRU, TransformerNet atd.). Objevily se dobře fungující algoritmy pro "řeč-na-text" a systémy strojového překladu. Částečně jsou založené na konvolučních sítích pro vytváření základních prvků. Částečně na tom, že se nám podařilo shromáždit opravdu velké a kvalitní datové sady.
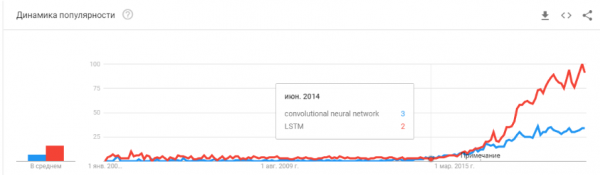
"Bublina praskla? Hype je přehřátý? Zemřeli jako blockchain?"
Jasně! Zítra na vašem telefonu přestane fungovat Siri a pozítří Tesla neodliší zatáčku od klokana.
Neuronové sítě už fungují. Jsou v desítkách zařízení. Opravdu umožňují vydělávat, mění trh a okolní svět. Hype vypadá poněkud jinak:
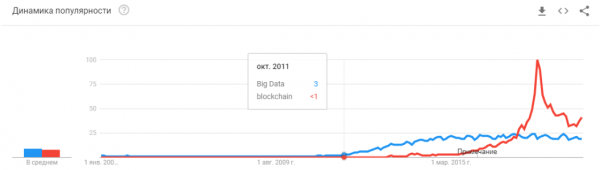
Jednoduše řečeno, neuronové sítě už přestaly být něčím novým. Ano, mnoho lidí má přehnaná očekávání. Ale velké množství firem se naučilo aplikovat neuronové sítě a vytvářet produkty na jejich základě. Neuronové sítě poskytují nové funkce, umožňují zkrátit pracovní místa a snížit ceny služeb:
- Výrobní firmy integrují algoritmy pro analýzu chyb na linkách.
- Hospodářství chovatele dobytka kupují systémy pro kontrolu krav.
- Automatické kombajny.
- Automatizované call centrály.
- Filtry v Snapchatu. (aspoň něco užitečného!)
Ale hlavní, a ne tak zřejmé: "Nové nápady už nejsou, nebo nepřinesou okamžitý kapitál." Neuronové sítě vyřešily desítky problémů. A vyřeší ještě více. Všechny zřejmé nápady, které existovaly, daly vznik mnoha startupům. Ale vše, co bylo na povrchu, už bylo sebráno. Za poslední dva roky jsem nepotkal žádný nový nápad pro aplikaci neuronových sítí. Žádný nový přístup (no, ok, tam jsou u GANů nějaké potíže).
A každý následující startup je stále složitější. Už to nevyžaduje dva kluky, kteří trénují neuronovou síť na otevřených datech. Vyžaduje programátory, servery, tým pro označování, složitou podporu atd.
Jako výsledek — startupů ubývá. Ale produkce roste. Potřebujete implementovat rozpoznávání SPZ? Na trhu je stovky odborníků s relevantními zkušenostmi. Můžete najmout a za pár měsíců váš zaměstnanec udělá systém. Nebo koupit hotový. Ale zakládat nový startup?.. Šílenství!
Je třeba vytvořit systém sledování návštěvníků - proč platit za spoustu licencí, když si můžete za 3-4 měsíce vytvořit vlastní, přizpůsobenou pro své podnikání.
Nyní procházejí neuronové sítě stejnou cestou, jakou prošlo mnoho jiných technologií.
Pamatujete, jak se od roku 1995 měnil pojem "vývojář webových stránek"? Dokud není trh nasycen specialisty. Profesionálů je velmi málo. Ale mohu se vsadit, že za 5-10 let nebude mezi programátorem v Javě a vývojářem neuronových sítí velký rozdíl. Obě profese budou na trhu dostatečně zastoupeny.
Prostě budou existovat druhy úkolů, pro které se neuronové sítě využívají. Objevil se úkol - najímáte specialistu.
"A co dál? Kde je slibovaná umělá inteligence?"
Tady je malá, ale zajímavá nejasnost :)
Ten technologický stack, který existuje dnes, zjevně nás k umělé inteligenci nepovede. Myšlenky, jejich novost - do značné míry vyčerpaly své možnosti. Pojďme si promluvit o tom, co drží současnou úroveň vývoje.
Omezení
Začneme s autonomními vozidly. Zdá se, že je jasné, že vytvořit plně autonomní automobily při dnešních technologiích je možné. Ale za jak dlouho se to stane - není jasné. Tesla tvrdí, že se to stane za pár let -
Existuje mnoho dalších , kteří to hodnotí na 5-10 let.
Podle mého názoru, za 15 let se infrastruktura měst již sama změní tak, že objev autonomních automobilů se stane nevyhnutelným, stane se jejich pokračováním. Ale to přece nelze považovat za inteligenci. Moderní Tesla je velmi složitý stroj na filtrování dat, jejich vyhledávání a přeučování. Jsou to pravidla-pravidla-pravidla, sběr dat a filtry nad nimi (tohle jsem o tom napsal podrobněji, nebo se můžete podívat na poznámky).
První problém
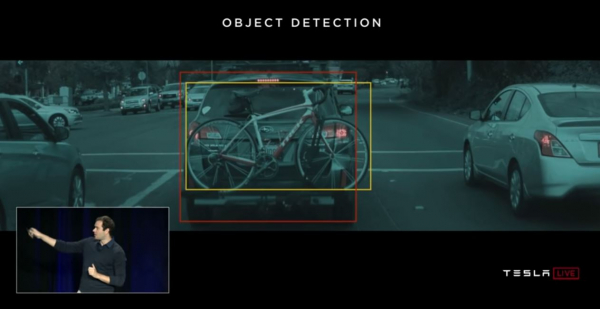
A právě zde vidíme první zásadní problém. Velké data. To je přesně to, co vyvolalo aktuální vlnu neuronových sítí a strojového učení. Nyní, abychom vytvořili něco složitého a automatického, potřebujeme hodně dat. Ne jen hodně, ale opravdu velmi mnoho. Potřebujeme automatizované algoritmy pro jejich sběr, označování a použití. Chceme, aby stroj viděl náklaďáky proti slunci - musíme nejprve shromáždit dostatečný jejich počet. Chceme, aby stroj nezbláznil z kola připevněného k nosiči - potřebujeme více vzorků.
A jedna ukázka nestačí. Stovky? Tisíce?
Druhý problém
Druhý problém — vizualizace toho, co naše neuronová síť pochopila. To je velmi netriviální úkol. Dosud málo kdo rozumí, jak to vizualizovat. Tyto články jsou velmi čerstvé, to jsou pouze některé příklady, i když vzdálené:
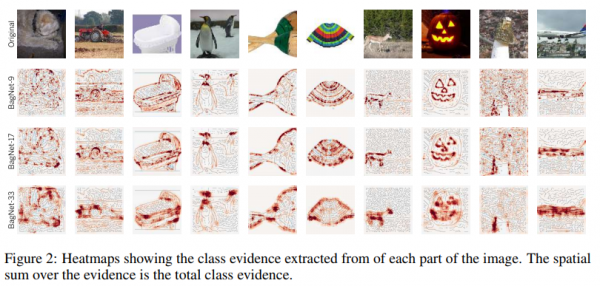
cyklickosti na texturní prvky. Dobře ukazuje, na čem se neuronová síť ráda cyklí + co vnímá jako výchozí informace.
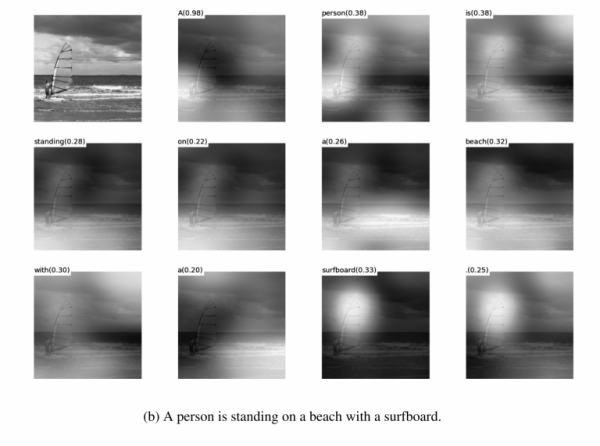
pozornost při . Opravdu lze pozornost často použít právě k tomu, aby ukázala, co vyvolalo takovou reakci sítě. Takové nástroje jsem potkával jak pro debugování, tak pro produktová řešení. Na toto téma existuje opravdu hodně článků. Ale čím složitější jsou data, tím obtížnější je pochopit, jak dosáhnout stabilní vizualizace.
Nu a ano, starý dobrý soubor z „podívej se, co je uvnitř sítě v “. Tyto obrázky byly populární přibližně před 3-4 lety, ale všichni rychle pochopili, že obrázky jsou sice krásné, ale nemají moc význam.
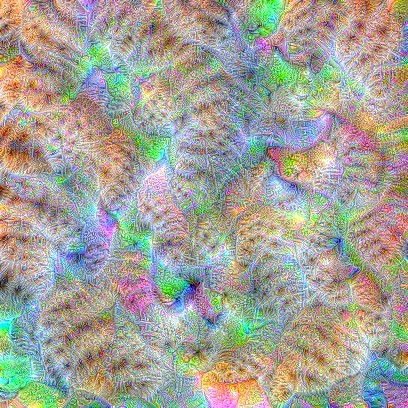
Nezmínil jsem desítky dalších zlepšení, způsobů, hacků, výzkumů o tom, jak zobrazit vnitřnosti sítě. Fungují tyto nástroje? Pomáhají rychle pochopit, v čem je problém a debuggovat síť?.. Získat poslední procenta? No, přibližně takto:
Můžete se podívat na jakoukoli soutěž na Kaggle. A na popis toho, jak lidé vytvářejí konečné řešení. Nahromadili jsme 100-500-800 milionů modelů a ono to fungovalo!
Samozřejmě, přeháním. Ale rychlé a přímé odpovědi tyto přístupy nedávají.
Mít dostatek zkušeností a prozkoumat různé varianty můžete vydat verdikt o tom, proč váš systém přijal takové rozhodnutí. Ale upravit chování systému bude složité. Nasadit záplatu, posunout práh, přidat datový soubor, vzít jinou backendovou síť.
Třetí problém
Třetí fundamentální problém — sítě se neučí logiku, ale statistiku. Statisticky to :
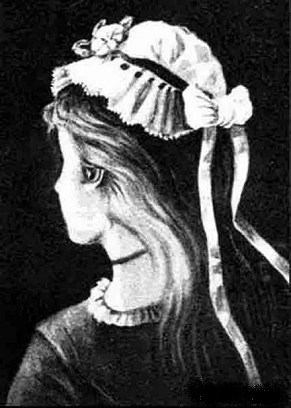
Logicky to příliš nevypadá. Neuronové sítě se neučí nic složitého, pokud je k tomu nenutíme. Vždy se učí maximálně jednoduché rysy. Jsou tam oči, nos, hlava? Pak je to tvář! Nebo přiveď příklad, kde by oči neznamenaly tvář. A opět — miliony příkladů.
Na dně je spousta místa
Řekl bych, že právě tyto tři globální problémy dnes omezují vývoj neuronových sítí a strojového učení. Tam, kde tyto problémy neomezovaly, se již aktivně využívají.
Je to konec? Neuronové sítě se zastavily?
Nevím. Ale samozřejmě, všichni doufají, že ne.
Existuje mnoho přístupů a směrů k řešení těch fundamentálních problémů, které jsem osvětlil výše. Ale zatím žádný z těchto přístupů nedovolil udělat něco fundamentálně nového, vyřešit něco, co dosud nebylo vyřešeno. Zatím jsou všechny fundamentální projekty založeny na stabilních přístupech (Tesla) nebo zůstávají testovacími projekty institucí nebo korporací (Google Brain, OpenAI).
Pokud bych měl hovořit hrubě, hlavním směrem je vytváření určitého vysokého úrovňového znázornění vstupních dat. V určitém smyslu „paměti“. Nejjednodušší příklad paměti jsou různé „Embedding“ — reprezentace obrázků. Například všechny systémy rozpoznávání tváří. Síť se učí získávat ze tváře určité stabilní znázornění, které nezávisí na otočení, osvětlení, rozlišení. V podstatě síť minimalizuje metriku „odlišné tváře — daleko“ a „stejné — blízko“.
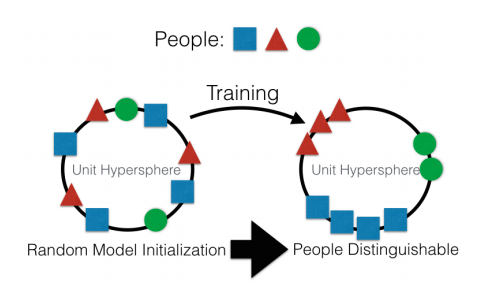
Pro takové učení jsou potřeba desítky a stovky tisíc příkladů. Ale výsledek nese určité náznaky „One-shot Learning“. Nyní nepotřebujeme stovky tváří, abychom si zapamatovali člověka. Stačí pouze jedna tvář, a vše — my !
Ale je tu problém… Síť se může naučit pouze dost jednoduché objekty. Při pokusu rozlišovat ne tváře, ale například „lidi podle oblečení“ (úkol ) — kvalita se propadá o mnoho řádů. A síť již nemůže naučit dost zřejmé změny úhlů.
A učit se na milionech příkladů — také takové si to užívání.
Existují práce na významném zmenšení výběru. Například si hned vzpomenu na jednu z prvních prací na OneShot Learning :
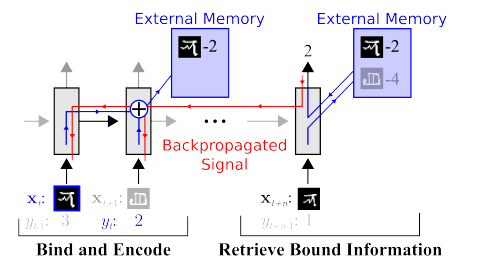
Takových prací je mnoho, například nebo nebo .
Jednou z nevýhod je, že učení obvykle funguje dobře na nějakých jednoduchých, "MNISTovských" příkladech. Při přechodu k složitějším úkolům je potřeba větší databáze, model objektů nebo nějaká magie.
Práce na One-Shot učení je obecně velmi zajímavé téma. Najdete tu mnoho myšlenek. Ale většinou ty dvě problémy, které jsem zmínil (předtrénování na obrovském datasetu / nestabilita na složitých datech), velmi brání učení.
Na druhou stranu se k tématu Embedding hodí GAN — generativní adversariální sítě. Určitě jste četli spoustu článků na tento téma na Habr., ,)
Zvláštností GAN je vytváření určitého vnitřního prostoru stavů (v podstatě toho samého Embeddingu), který umožňuje generovat obrázek. To mohou být , mohou to být .
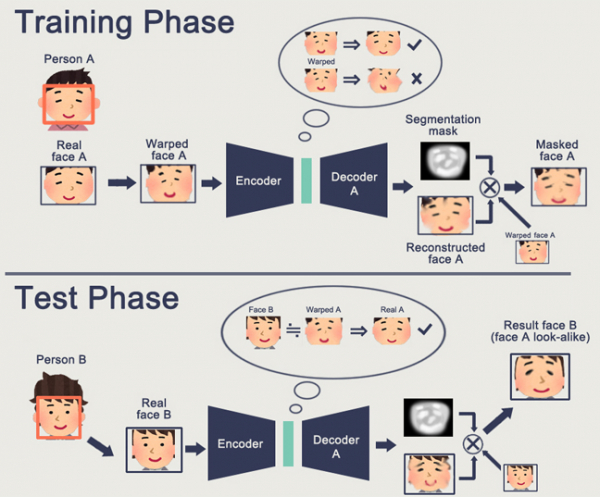
Problém GAN je, že čím složitější je generovaný objekt, tím složitější je jej popsat v logice „generátor-diskriminátor“. Výsledkem je, že z reálných aplikací GAN, které jsou na poslech - pouze DeepFake, který opět manipuluje s reprezentacemi tváří (pro které existuje obrovská databáze).
Dalších užitečných aplikací jsem viděl velmi málo. Obvykle to jsou nějaké vymyšlené kousky s doplňováním obrázků.
A opět. Nikdo nemá představu, jak nám to pomůže posunout se do světlé budoucnosti. Představa logiky/prostoru v neuronové síti je dobrá. Ale potřebujeme obrovské množství příkladů, není nám jasné, jak si neuronová síť dává dohromady toto složité zobrazení.
Reinforcement learning — je přístup úplně z jiné strany. Určitě si pamatujete, jak Google porazil všechny v Go. Nedávné vítězství ve Starcraftu a Dota. Ale tady to není tak růžové a perspektivní. Nejlépe o RL a jeho komplikacích mluví .
Pokud bych měl stručně shrnout, co autor napsal:
- Modely z krabice nevyhovují / ve většině případů fungují špatně.
- Praktické úkoly se dají jednoduše vyřešit jinými způsoby. Boston Dynamics nepoužívá RL kvůli jeho složitosti / nepředvídatelnosti / výpočetním složitostem.
- Aby RL fungoval, potřebujete složitou funkci. Často je obtížné ji vytvořit / napsat.
- Je těžké školit modely. Musíte vynaložit spoustu času na rozproudění a překonání lokálních optimů.
- V důsledku toho je obtížné model opakovat, model je nestabilní při nejmenších změnách.
- Často se přizpůsobuje nějakým neobvyklým vzorcům, až po generátor náhodných čísel.
Klíčový moment — RL zatím nefunguje v produkčním prostředí. Google má nějaké experimenty ( , ). Ale neviděl jsem žádný produktový systém.
Paměť. Nevýhodou výše uvedeného je neorganizovanost. Jedním z přístupů, jak to všechno zorganizovat, je poskytnout neuronové síti přístup k oddělené paměti. Aby mohla ukládat a přepisovat výsledky svých kroků. Pak se neuronová síť může definovat aktuálním stavem paměti. To je velmi podobné klasickým procesorům a počítačům.
Nejznámější a nejpopulárnější — od DeepMind:
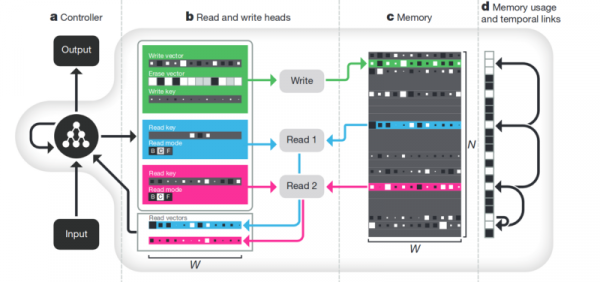
Zdá se, že to je klíč k pochopení inteligence? Ale pravděpodobně ne. Systému je i tak potřeba obrovský objem dat k trénování. A funguje převážně se strukturovanými tabulkovými daty. Přitom, když Facebook podobný problém, zvolili cestu „na nic paměti, prostě uděláme neuronku složitější, a více příkladů — a ona se sama naučí“.
Disentanglement. Další způsob, jak vytvořit smysluplnou paměť, je vzít stejné embeddingy, ale při trénování zavést další kritéria, která by umožnila v nich vyčlenit „významy“. Například chceme naučit neuronovou síť rozlišovat chování člověka v obchodě. Kdybychom šli standardní cestou — museli bychom vytvořit desítku sítí. Jedna hledá člověka, druhá určuje, co dělá, třetí jeho věk, čtvrtá — pohlaví. Další logika sleduje část obchodu, kde se to děje/naučuje se to. Třetí určuje jeho trajektorii atd.
Nebo, pokud by bylo nekonečné množství dat, mohlo by se naučit jednu síť na všechny možné výsledky (je zřejmé, že takový objem dat nelze nasbírat).
Přístup k dysentelgimentu nám říká, že bychom měli školit síť tak, aby sama byla schopna rozlišovat pojmy. Aby byla schopna z videa vytvořit embedding, kde jedna oblast by definovala akci, jedna - pozici na podlaze v čase, jedna - výšku člověka, a další - jeho pohlaví. Při školení bychom chtěli co nejméně naznačovat síti takové klíčové pojmy, ale aby si sama vytyčila a seskupila oblasti. Takových článků je poměrně málo (některé z nich , , ) a celkově jsou dost teoretické.
Ale tento směr, alespoň teoreticky, by měl řešit výše uvedené problémy.
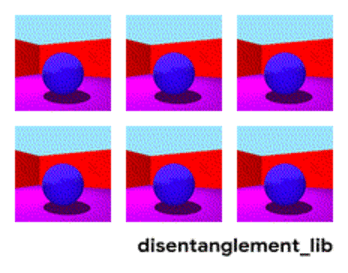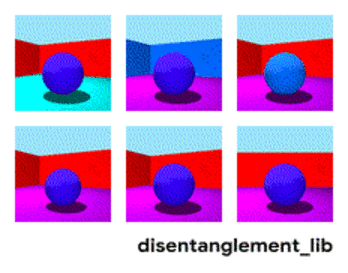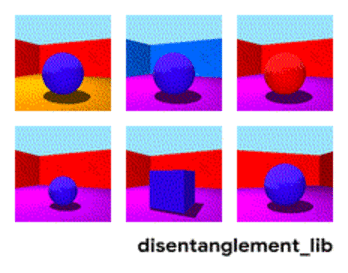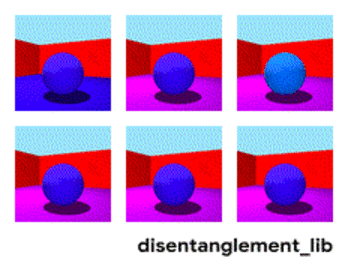
Decomposition obrázku podle parametrů "barva stěn / barva podlahy / tvar objektu / barva objektu / atd."
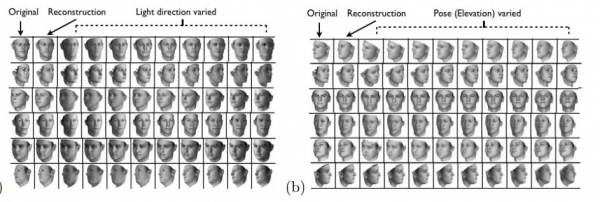
Decomposition obličeje podle parametrů "velikost, obočí, orientace, barva pleti, atd."
Ostatní
Existuje mnoho dalších, ne tolik globálních směrů, které umožňují nějak zmenšit databáze, pracovat s různorodějšími daty, atd.
Pozornost. Asi nemá smysl vyčleňovat to jako samostatnou metodu. Jen přístup, který posiluje ostatní. Je mu věnováno mnoho článků (,,). Smyslem pozornosti je zvýšit reakci sítě právě na významné objekty během školení. Často nějakým externím cílovým ukazatelem, nebo malou externí sítí.
3D simulace. Pokud uděláte dobrý 3D engine, může jím často pokrýt 90 % tréninkových dat (viděl jsem příklad, kdy skoro 99 % dat bylo pokryto dobrým enginem). Existuje mnoho nápadů a hacků, jak donutit síť, která byla školena na 3D enginu, pracovat s reálnými daty (Fine tuning, style transfer, atd.). Ale často udělat dobrý engine je o několik řádů složitější než shromáždit data. Příklady, kdy byly vytvořeny enginy:
Výuka robotů (, )
Studium produkty v obchodě (ale ve dvou projektech, které jsme dělali - jsme se bez toho bez problémů obešli).
Školení ve společnosti Tesla (opět to video, které bylo výše).
Závěry
Celý článek je v jistém smyslu shrnutím. Asi hlavní poselství, které jsem chtěl sdělit - "zdarma skončilo, neuronové sítě již nenabízejí jednoduchá řešení". Nyní je třeba pracovat na složitých řešeních. Nebo pracovat na složitých vědeckých výzkumech.
A vůbec, téma je diskutabilní. Možná mají čtenáři zajímavější příklady?
Zdroj: habr.com
