

Moderní informační systémy jsou dost složité. Jejich složitost je zčásti způsobena složitostí zpracovávaných dat. Tato složitost dat často spočívá v různorodosti používaných modelů dat. Například, když se data stávají "velkými", jedním z problémů je nejen jejich objem ("volume"), ale také jejich rozmanitost ("variety").
Pokud zatím nenacházíte chybu v úvahách, pokračujte ve čtení.
Obsah
Polyglot persistence
Jak bylo řečeno výše, někdy v rámci jedné systému je nutné pro ukládání dat a řešení různých úloh jejich zpracování používat několik různých databázových systémů, z nichž každý podporuje svůj model dat. S lehkou rukou M. Fowlers, řady známých knih a jednoho z Agile Manifesto, taková situace získala název polyglot persistence („mnohovariantní úložiště“).
Fowler také přináší následující příklad organizace ukládání dat v plně funkčním a vysoce zatíženém aplikaci v oblasti elektronického obchodování.
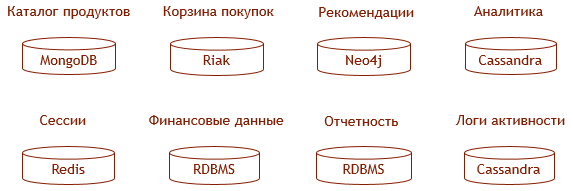
Tento příklad je samozřejmě poněkud zjednodušený, ale některé úvahy pro volbu konkrétní databáze pro daný účel lze nalézt, například, .
Je jasné, že být správcem takového zoo není snadné.
- Objem kódu, který vykonává ukládání dat, roste úměrně počtu použitých databázových systémů; objem kódu, který synchronizuje data, – dobře, pokud není úměrný druhé mocnině tohoto čísla.
- Náklady na zajištění enterprise charakteristik (škálovatelnosti, odolnosti proti chybám, vysoké dostupnosti) každé z použitých databázových systémů vzrůstají v poměru k počtu používaných databázových systémů.
- Je nemožné zajistit enterprise charakteristiky pod systému ukládání jako celku – zejména transakční funkčnost.
Z pohledu ředitele zoo to vypadá takto:
- Růst cen licencí a technické podpory od výrobce DBMS.
- Nafukování personálu a prodlužování termínů.
- Přímé finanční ztráty nebo sankce za nesoulad dat.
Můžeme pozorovat významný nárůst celkových nákladů na vlastnictví systému (TCO). Existuje nějaké východisko ze situace „více variantního ukládání“?
Multimodalita
Termín „více variantní ukládání“ se dostal do běžného užívání v roce 2011. Uvědomění si problémů přístupu a hledání řešení trvalo několik let, a do roku 2015 analytici Gartner nahlas formulovali odpověď:
- Z „»:
Budoucnost DBMS, jejich architektur a využití — více modelů.
- Z „»:
Vedoucí provozní DBMS budou nabízet několik modelů — relační a nereálné — v rámci jediné platformy.
Zdá se, že tentokrát se analytici Gartner nespletli. Pokud navštívíte stránku s DBMS na DB-Engines, můžete vidět, že většina jeho lídrů se pozicionuje právě jako více modelové DBMS. To samé lze vidět i na stránce s jakýmkoli konkrétním hodnocením.oV tabulce níže jsou uvedeny DBMS — lídři v každém specifickém hodnocení, kteří prohlašují svou více modelovost. Pro každou DBMS je uveden počáteční podporovaný model (kdysi jediný), a vedle něj modely, které jsou nyní podporovány. Rovněž jsou zde uvedeny DBMS, které se pozicionují jako „od počátku více modelové“, nemající podle tvrzení tvůrců žádný počáteční zděděný model.
DBMS
| Počáteční model | Další modely | Relační |
|---|---|---|
| Oracle | Grafový, dokumentový | MS SQL |
| Grafový*, dokumentový | Grafový, dokumentový | MS SQL |
| PostgreSQL | Grafový, dokumentový | MarkLogic |
| Dokumentový | Grafový, relační | Klíč-hodnota, grafový* |
| MongoDB | Grafový, relační | DataStax |
| Široký sloupec | Dokumentový, grafový | Klíč-hodnota |
| Redis | Dokumentový, grafový* | Grafový, dokumentový, relační |
| ArangoDB | — | MS SQL |
| OrientDB | — | Poznámky k tabulce |
| Azure CosmosDB | — | Poznámky k tabulce |
Hvězdičkami v tabulce jsou označeny tvrzení, která vyžadují upozornění:
DBMS PostgreSQL nepodporuje grafový model dat, nicméně takový produkt
- na jeho základě Pokud jde o MongoDB, je správnější hovořit spíše o přítomnosti grafových operátorů v dotazovacím jazyce (
- $lookup, ), než o podpoře grafového modelu, i když samozřejmě jejich zavedení vyžadovalo určité optimalizace na úrovni fyzického ukládání ve prospěch podpory grafového modelu.
- Pokud jde o Redis, mluvíme o rozšíření .
Dále pro každou z tříd ukážeme, jak se realizuje podpora několika modelů v DBMS této třídy. Nejvíce důležité budeme považovat relační, dokumentový a grafový model a na příkladech konkrétních DBMS bude ukázáno, jak se realizují „chybějící“.
Multimodální databáze založené na relačním modelu
Mezi předními DBMS v současnosti dominují relační, prognózu Gartnera by nebylo možné považovat za splněnou, kdyby RDBMS neprokazovaly pokrok směrem k multimodálnosti. A prokazují. Nyní lze úvahy o tom, že multimodální DBMS je podobná švýcarskému noži, s nímž se nedá udělat nic pořádně, nasměrovat přímo na Larryho Ellisona.
Autorovi se však více líbí realizace multimodálnosti v Microsoft SQL Serveru, na jehož příkladu bude popisována podpora RDBMS dokumentového a grafového modelu.
Dokumentový model v MS SQL Serveru
O tom, jak je v MS SQL Serveru realizována podpora dokumentového modelu, byly na Habu již dvě skvělé články, omezím se na stručné shrnutí a komentář:
Způsob podpory dokumentového modelu v MS SQL Serveru je dost typický pro relační DBMS: JSON dokumenty se doporučuje ukládat do běžných textových polí. Podpora dokumentového modelu spočívá v poskytování speciálních operátorů pro analýzu tohoto JSON:
- pro extrakci skalárních hodnot atributů,
- pro extrakci poddokumentů.
Druhým argumentem obou operátorů je výraz v syntaxi podobné JSONPath.
Abstraktně lze říci, že takto uložené dokumenty nejsou v relační DBMS „prvními třídami entit“, na rozdíl od dvojic. Konkrétně v MS SQL Serveru v současné době chybí indexy na polích JSON dokumentů, což ztěžuje operace spojování tabulek podle hodnot těchto polí a dokonce i výběr dokumentů podle těchto hodnot. Nicméně, je možné vytvořit na takovém poli vypočítávaný sloupec a index podle něj.
Dodatečně MS SQL Server poskytuje možnost pohodlně konstruovat JSON dokument z obsahu tabulek pomocí operátoru — možnost, v určitém smyslu opačná předchozímu běžnému ukládání. Je jasné, že jakkoli rychlá může být RDBMS, tento přístup je v rozporu s ideologií dokumentových DB, které v podstatě uchovávají hotové odpovědi na populární dotazy, a mohou řešit pouze problémy pohodlí při vývoji, nikoli výkonu.
Konečně, MS SQL Server umožňuje řešit úkol opačný konstrukci dokumentu: můžete rozložit JSON do tabulek pomocí . Pokud dokument není zcela plochý, bude třeba použít CROSS APPLY.
Grafový model v MS SQL Serveru
Podpora grafového (LPG) modelu je zcela očekávatelně realizována také v Microsoft SQL Serveru. : doporučuje se používat speciální tabulky pro ukládání uzlů a pro ukládání hran grafu. Takové tabulky se vytvářejí pomocí výrazů CREATE TABLE AS NODE a CREATE TABLE AS EDGE odpovídajícím způsobem.
Tabulky prvního typu jsou podobné běžným tabulkám pro ukládání záznamů s tím vnějším rozdílem, že v tabulce je přítomno systémové pole $node_id — unikátní identifikátor uzlu grafu v rámci databáze.
Analogicky, tabulky druhého typu mají systémová pole $from_id a $to_id, záznamy v těchto tabulkách přirozeně definují vazby mezi uzly. Pro ukládání vazeb každého typu se používá samostatná tabulka.
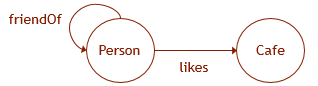 Ilustrujme to na příkladu. Předpokládejme, že grafová data mají schéma jako na uvedeném obrázku. Potom pro vytvoření odpovídající struktury v databázi je třeba provést následující DDL dotazy:
CREATE TABLE Person (
  ID INTEGER NOT NULL,
  name VARCHAR(100)
) AS NODE;

CREATE TABLE Cafe (
  ID INTEGER NOT NULL,
  name VARCHAR(100),
) AS NODE;

CREATE TABLE likes (
  rating INTEGER
) AS EDGE;

CREATE TABLE friendOf
  AS EDGE;

ALTER TABLE likes
  ADD CONSTRAINT EC_LIKES CONNECTION (Person TO Cafe);
Hlavní specifikum těchto tabulek spočívá v tom, že v dotazech k nim je možné používat grafové vzory se syntaxí podobnou Cypheru (ovšem „*“ a další zatím nejsou podporovány). Na základě měření výkonu lze také předpokládat, že způsob ukládání dat v těchto tabulkách se liší od mechanismu ukládání dat v běžných tabulkách a je optimalizován pro vykonávání podobných grafových dotazů.
SELECT Cafe.name
  FROM Person, likes, Cafe
  WHERE MATCH (Person-(friendOf)-(likes)->Cafe)
  AND Person.name = 'John';
Navíc je poměrně obtížné při práci s takovými tabulkami tyto grafové vzory nevyužívat, protože v běžných SQL dotazech pro řešení obdobných úloh by bylo nutné vynaložit další úsilí na získání systémových „grafových“ identifikátorů uzlů ($node_id, $from_id, $to_id; ze stejného důvodu zde nejsou uvedeny dotazy na vkládání dat, protože by byly příliš složité).
Shrnujíc popis implementace dokumentového a grafového modelu v MS SQL Server bych podotkl, že takové implementace jedné modely na druhé se na první pohled nezdají být úspěšné z hlediska jazykového designu. Je třeba rozšiřovat jeden jazyk druhým, jazyky nejsou zcela "ortogonální", pravidla kombinovatelnosti mohou být poměrně podivná.
Multimodální databáze založené na dokumentovém modelu
V této části bych chtěl ilustrovat implementaci multimodelovosti v dokumentových DB na příkladu jedné z méně populárních, a to MongoDB (jak bylo řečeno, má pouze podmíněné grafové operátory $graphLookup a ), které nepracují na shardovaných kolekcích), ale na příkladu zralejší a "enterprise" databáze .
Takže ať už kolekce obsahuje sadu XML dokumentů následujícího typu (ukládání JSON dokumentů MarkLogic také umožňuje):
John
  Smith
Relační model v MarkLogic
Relationalní reprezentaci kolekce dokumentů lze vytvořit pomocí (obsah elementů value v příkladu níže může být libovolný XPath):
/Person


      Person


          SSN
          @SSN
          string


          name
          name


          surname
          surname
K vytvořenému zobrazení lze adresovat SQL dotaz (například přes ODBC):
SELECT name, surname FROM Person WHERE name="John"Bohužel, relace vytvořená pomocí šablony zobrazení je pouze pro čtení. Při zpracování dotazu na něj se MarkLogic pokusí využít . Dříve měl MarkLogic omezené relační reprezentace, které byly zcela a byly zapisovatelné, ale nyní jsou považovány za zastaralé.
Grafový model v MarkLogic
Podpora grafového (RDF) modelu funguje přibližně stejně. Opět pomocí lze vytvořit RDF reprezentaci kolekce dokumentů z výše uvedeného příkladu:
/Person
PREFIX
"http://example.org/example#"
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || surname )
sem:iri( $PREFIX || @SSN )
sem:iri( $PREFIX || name )
Na získaný RDF graf lze adresovat SPARQL dotaz:
PREFIX :
SELECT ?name ?surname {
  :631803299804 :name ?name ; :surname ?surname .
}
Na rozdíl od relačního modelu, grafový model MarkLogic podporuje ještě dvěma dalšími způsoby:
- DBMS může být plnohodnotným samostatným úložištěm RDF dat (trojice budou nazývány na rozdíl od výše popsaného ).
- RDF ve speciálním serializaci může být jednoduše vloženo do XML- nebo JSON dokumentů (a trojice pak budou nazývány ). Pravděpodobně jde o alternativu k mechanismům
idrefa další.
Dobrou představu o tom, jak „to vlastně funguje“ v MarkLogic poskytuje , v tomto smyslu je to nízkoúrovňové, přestože zamýšlená funkce je spíše opačná — snažit se abstrahovat od používaného datového modelu, zajistit konzistentní práci s daty v různých modelech, transakčnost a další.
Multimodální databáze „bez hlavního modelu“
Na trhu jsou také DBMS, které se profilují jako od začátku multimodelové, neobsahující žádný zděděný základní model. Mezi ně patří , (od roku 2018 je vývojový tým vlastněn společností SAP) a (služba součástí cloudové platformy Microsoft Azure).
Ve skutečnosti „základní“ modely existují v ArangoDB a OrientDB. V obou případech se jedná o vlastní datové modely, které představují zobecnění dokumentového modelu. Zobecnění spočívá především ve zjednodušení možnosti provádět dotazy grafového a relačního charakteru.
Tyto modely jsou v uvedených databázích jedině dostupné pro použití a pro práci s nimi jsou určeny vlastní dotazovací jazyky. Bezpochyby jsou tyto modely a databáze perspektivní, avšak absence kompatibility se standardními modely a jazyky znemožňuje použití těchto databází v děděných systémech — jejich nahrazení již používanými databázemi je nemožné.
O ArangoDB a OrientDB byl na Habru již skvělý článek: .
ArangoDB
ArangoDB deklaruje podporu grafového datového modelu.
Uzly grafu v ArangoDB jsou běžné dokumenty, a hrany jsou dokumenty speciálního druhu, které mají vedle běžných systémových polí (_key, _id, _rev) systémová pole _from a _to. Dokumenty v dokumentových databázích se tradičně sdružují do kolekcí. Kolekce dokumentů představujících hrany se v ArangoDB nazývají edge-kolekcemi. Mimochodem, dokumenty edge-kolekcí jsou také dokumenty, takže hrany v ArangoDB mohou být také uzly.
Vstupní data
Předpokládejme, že máme kolekci persons, jejíž dokumenty vypadají takto:
[
  {
    "_id"  : "people/alice" ,
    "_key" : "alice" ,
    "name" : "Alice"
  },
  {
    "_id"  : "people/bob" ,
    "_key" : "bob" ,
    "name" : "Bob"
  }
]
Předpokládejme, že také existuje kolekce cafes:
[
  {
    "_id" : "cafes/jd" ,
    "_key" : "jd" ,
    "name" : "John Donne"
  },
  {
    "_id" : "cafes/jj" ,
    "_key" : "jj" ,
    "name" : "Jean-Jacques"
  }
]
Pak kolekce likes může vypadat takto:
[
  {
    "_id" : "likes/1" ,
    "_key" : "1" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jd",
    "since" : 2010
  },
  {
    "_id" : "likes/2" ,
    "_key" : "2" ,
    "_from" : "persons/alice" ,
    "_to" : "cafes/jj",
    "since" : 2011
  } ,
  {
    "_id" : "likes/3" ,
    "_key" : "3" ,
    "_from" : "persons/bob" ,
    "_to" : "cafes/jd",
    "since" : 2012
  }
]
Dotazy a výsledky
Dotaz ve stylu grafu v ArangoDB používaným jazykem AQL, který vrací v lidsky čitelné podobě informace o tom, komu které kavárny se líbí, vypadá takto:
FOR p IN persons
  FOR c IN OUTBOUND p likes
  RETURN { person : p.name , likes : c.name }
Ve vztahovém stylu, kdy spíše "počítáme" vazby, než abychom je uchovávali, lze tento dotaz přepsat takto (mimochodem, bez kolekce likes by se to obešlo):
FOR p IN persons
  FOR l IN likes
  FILTER p._key == l._from
    FOR c IN cafes
    FILTER l._to == c._key
    RETURN { person : p.name , likes : c.name }
Výsledek bude v obou případech stejný:
[
  { "person" : "Alice" , likes : "Jean-Jacques" } ,
  { "person" : "Alice" , likes : "John Donne" } ,
  { "person" : "Bob" , likes : "John Donne" }
]
Další dotazy a výsledky
Pokud se zdá, že výše uvedený formát výsledku je spíše charakteristický pro relační databáze než pro dokumentové, můžete vyzkoušet tento dotaz (nebo můžete využít ):
FOR p IN persons
  RETURN {
    person : p.name,
    likes : (
      FOR c IN OUTBOUND p likes
      RETURN c.name
    )
}
Výsledek bude mít následující podobu:
[
  { "person" : "Alisa" , likes : ["Jean-Jacques" , "John Donne"]  } ,
  { "person" : "Bob" , likes : ["John Donne"] }
]
OrientDB
Základem realizace grafového modelu nad dokumentovým v OrientDB je pole dokumentů mít kromě více či méně standardních skalarových hodnot také hodnoty takových typů, jako jsou LINK, LINKLIST, LINKSET, LINKMAP a LINKBAG. Hodnoty těchto typů – odkazy nebo kolekce odkazů na dokumentů.
Přidělený systémový identifikátor dokumentu má "fyziologický význam", ukazuje pozici záznamu v databázi a vypadá přibližně takto: @rid : #3:16. Tímto způsobem hodnoty odkazových vlastností jsou skutečně spíše ukazatele (jak v grafovém modelu), a nikoli kritéria výběru (jak v relačním).
Stejně jako v ArangoDB jsou v OrientDB hrany reprezentovány jako samostatné dokumenty (i když pokud hrana nemá své vlastnosti, lze ji učinit , a nebude ji odpovídat samostatný dokument).
Vstupní data
Ve formátu, který je blízký dat z předchozího příkladu pro ArangoDB by vypadaly přibližně takto:
[
     {
      "@type": "document",
      "@rid": "#11:0",
      "@class": "Person",
      "name": "Alisa",
      "out_likes": [
        "#30:1",
        "#30:2"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#12:0",
      "@class": "Person",
      "name": "Bob",
      "out_likes": [
        "#30:3"
      ],
      "@fieldTypes": "out_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#21:0",
      "@class": "Cafe",
      "name": "Jean-Jacques",
      "in_likes": [
        "#30:2",
        "#30:3"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#22:0",
      "@class": "Cafe",
      "name": "John Donne",
      "in_likes": [
        "#30:1"
      ],
      "@fieldTypes": "in_likes=LINKBAG"
    },
    {
      "@type": "document",
      "@rid": "#30:1",
      "@class": "likes",
      "in": "#22:0",
      "out": "#11:0",
      "since": 1262286000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:2",
      "@class": "likes",
      "in": "#21:0",
      "out": "#11:0",
      "since": 1293822000000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    },
    {
      "@type": "document",
      "@rid": "#30:3",
      "@class": "likes",
      "in": "#21:0",
      "out": "#12:0",
      "since": 1325354400000,
      "@fieldTypes": "in=LINK,out=LINK,since=date"
    }
  ]
Jak vidíme, vrcholy také uchovávají informace o příchozích a odchozích hranách. Při O dokumentovém API je nutné sledovat referenční integritu samostatně, zatímco Graph API tuto práci na sebe bere. Podívejme se, jak vypadá dotaz na OrientDB v "čistých" dotazovacích jazycích, které nejsou integrovány do programovacích jazyků.
Dotazy a výsledky
Dotaz, který má stejný účel jako dotaz v příkladu pro ArangoDB, v OrientDB vypadá takto:
SELECT name AS person_name, OUT('likes').name AS cafe_name
   FROM Person
   UNWIND cafe_name
Výsledek bude získán v následující podobě:
[
  { "person_name": "Alice", "cafe_name": "John Donne" },
  { "person_name": "Alice", "cafe_name": "Jean-Jacques" },
  { "person_name": "Bob",  "cafe_name": "Jean-Jacques" }
]
Pokud se formát výsledku opět zdá příliš "relační", je třeba odstranit řádek s :
[
  { "person_name": "Alice", "cafe_name": [ "John Donne", "Jean-Jacques" ] },
  { "person_name": "Bob",  "cafe_name": [ "Jean-Jacques" ] }
]
Dotazovací jazyk OrientDB lze charakterizovat jako SQL s vkládáním podobným Gremlinu. V verzi 2.2 se objevila forma dotazu podobná Cypheru, :
MATCH {CLASS: Person, AS: person}-likes->{CLASS: Cafe, AS: cafe}
RETURN person.name AS person_name, LIST(cafe.name) AS cafe_name
GROUP BY person_name
Formát výsledku bude stejný jako v předchozím dotazu. Přemýšlejte, co je třeba odstranit, aby byl více "relační", jako v prvním dotazu.
Azure CosmosDB
Méně se výše uvedené o ArangoDB a OrientDB vztahuje na Azure CosmosDB. CosmosDB poskytuje následující API pro přístup k údajům: SQL, MongoDB, Gremlin a Cassandra.
SQL API a MongoDB API se používají pro přístup k datům v dokumentovém modelu. Gremlin API a Cassandra API slouží k přístupu k datům v grafovém a sloupcovém modelu. Data ve všech modelech jsou ukládána ve formátu vnitřního modelu CosmosDB: („atom-record-sequence“), který je také blízký dokumentovému modelu.
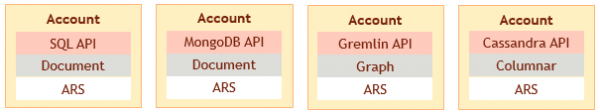
Ale zvolený model dat a používané API jsou fixovány v okamžiku vytváření účtu ve službě. Není možné přistupovat k údajům nahraným v jednom modelu v formátu jiného modelu, což by ilustrovalo přibližně takový obrázek:
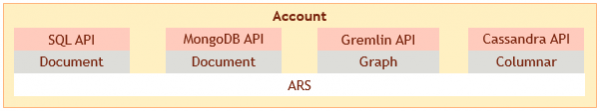
Tímto způsobem multimodalita v Azure CosmosDB dnes představuje pouze možnost používat několik databází, které podporují různé modely, od jednoho výrobce, což neřeší všechny problémy variantního ukládání.
Multimodální databáze založené na grafovém modelu?
Zajímavé je, že na trhu zatím nejsou multimodální DBMS, které by měly na základě grafový model (pokud nepočítáme multimodalitu jako podporu dvou grafových modelů: RDF a LPG; viz o tom v ). Největší problémy způsobuje implementace na základě grafového modelu dokumentů, nikoli relačního.
Otázka, jak implementovat relační model na grafové bázi, byla projednávána již od samotného vzniku posledního. , například, :
Neexistuje nic inherentního v grafovém přístupu, co by bránilo vytvoření vrstvy (např. vhodným indexováním) na grafové databázi, která umožňuje relační pohled s (1) obnovením n-tic z obvyklých párů klíč-hodnota a (2) seskupováním n-tic podle typu vztahu.
Při implementaci dokumentového modelu na grafovém je třeba mít na paměti například následující:
- Prvky JSON pole jsou považovány za seřazené, vycházející z vrcholu hrany grafu — nikoli;
- Data v dokumentovém modelu jsou obvykle denormalizována; i když by se nechtělo uchovávat několik kopií stejného vnořeného dokumentu, obvykle nemají poddokumenty identifikátory;
- Na druhé straně ideologie dokumentových databází spočívá v tom, že dokumenty jsou hotovými "agregáty", které není třeba každýkrát znovu vytvářet. Je třeba zabezpečit v grafovém modelu možnost rychle získat podgraf, odpovídající již hotovému dokumentu.
Trochu reklamy
Autor článku má vztah k vývoji databáze NitrosBase, jejíž vnitřní model je grafový, zatímco externí modely — relační a dokumentový — jsou jejími reprezentacemi. Všechny modely mají stejná práva: téměř jakákoli data jsou dostupná v jakémkoli z nich pomocí přirozeného dotazovacího jazyka. Navíc mohou být data v jakékoli reprezentaci měněna. Změny se projeví ve vnitřním modelu a následně i v dalších reprezentacích.
Jak vypadá odpovídání modelů v NitrosBase – popíšu, doufám, v jednom z následujících článků.
Závěr
Doufám, že obecné kontury toho, co se nazývá multimodelovostí, se čtenáři staly více či méně jasné. Multimodelovými se nazývají poměrně různé databáze a "podpora několika modelů" může vypadat různě. Pro pochopení toho, co se v každém konkrétním případě nazývá "multimodelovostí", je užitečné odpovědět na následující otázky:
- Jedná se o podporu tradičních modelů, nebo o nějaký jeden "hybridní" model?
- Jsou modely "rovnoprávné", nebo je jeden z nich podřízen ostatním?
- "Jsou modely sobě lhostejné? Mohou být data zapsaná v jednom modelu přečtena v jiném nebo dokonce přepsána?"
"Myslím, že na otázku o relevanci multimodálních DBMS již lze poskytnout kladnou odpověď, ale zajímavé je, jaké konkrétní jejich typy budou v nejbližší době více žádané. Zdá se, že větší poptávka bude po multimodálních DBMS, které podporují tradiční modely, především relační; popularita multimodálních DBMS nabízejících nové modely, které spojují výhody různých tradičních, je záležitostí spíše vzdálené budoucnosti."
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
"Používáte multimodální DBMS?"
"Nepoužíváme, ukládáme vše v jedné DBMS a v jednom modelu"
"Používáme multimodální možnosti tradičních DBMS"
"Praktikujeme polyglotní úložiště (polyglot persistence)"
"Používáme nové multimodální DBMS (Arango, Orient, CosmosDB)"
"Hlasovalo 19 uživatelů. Zdrželi se 4 uživatelé."
Zdroj: habr.com
