

shrnutí:
- Strojové učení hledá vzory v datech. Avšak umělá inteligence může být "předpojatá" – to znamená, že může nacházet nesprávné vzory. Například systém detekce rakoviny kůže na fotografii může věnovat zvláštní pozornost snímkům pořízeným v lékařské ordinaci. Strojové učení nedokáže chápat: jeho algoritmy pouze identifikují vzorce v číslech, a pokud data nejsou reprezentativní, takový bude i výsledek jejich zpracování. Odhalit takové chyby může být obtížné kvůli samotné mechanice strojového učení.
- Nejzřejmějším a nejvíce znepokojujícím problémem je rozmanitost lidí. Existuje mnoho důvodů, proč mohou údaje o lidech ztratit objektivitu už v etapě sběru. Ale nemyslete si, že tento problém se týká pouze lidí: podobné potíže se objevují při pokusu o detekci povodně ve skladu nebo porušené plynové turbíny. Některé systémy mohou mít předsudky vůči barvě pleti, jiné budou předpojatě chápat senzory Siemens.
- Takové problémy nejsou pro strojové učení nové a nejsou výsadou jen jeho. Nesprávné předpoklady se dělají v jakýchkoli složitých strukturách a pochopit, proč bylo přijato určité rozhodnutí, je vždy obtížné. S tím je třeba bojovat komplexně: vytvářet nástroje a procesy pro ověřování — a vzdělávat uživatele, aby neslepě následovali doporučení AI. Strojové učení skutečně dělá některé věci mnohem lépe než my — ale psi, například, jsou mnohem efektivnější než lidé při detekci drog, což určitě není důvod je povolávat jako svědky a vynášet rozsudky na základě jejich výpovědí. A psi jsou, mimochodem, mnohem chytřejší než jakýkoli systém strojového učení.
Strojové učení je dnes jedním z nejdůležitějších základních technologických trendů. Je to jeden z hlavních způsobů, jakým technologie změní okolní svět v příštím desetiletí. Některé aspekty těchto změn vyvolávají obavy. Například potenciální dopad strojového učení na pracovní trh nebo jeho využívání pro neetické účely (například autoritářskými režimy). Existuje ještě jeden problém, kterému se tento příspěvek věnuje: předpojatost umělé inteligence.
Tohle je složitý příběh.
Umělá inteligence od Googlu umí najít kočky. Tato zpráva z roku 2012 byla tehdy něčím výjimečným.
Co je to "předpojatost AI"?
"Surová data" jsou zároveň oxymóron a špatný nápad; data je třeba dobře a pečlivě připravit. -Jeffrey Boker
Až do roku 2013 bylo potřeba popisovat logické kroky pro vytvoření systému, který by například rozpoznával kočky na fotografiích. Jak najít na obrázku rohy, rozpoznat oči, analyzovat textury na přítomnost srsti, spočítat nohy a tak dále. Pak shromáždit všechny komponenty — a zjistit, že to vlastně nefunguje. Připomíná to mechanického koně — teoreticky ho lze vyrobit, ale prakticky je příliš složité jeho popsání. Na výstupu máte stovky (nebo dokonce tisíce) ručně psaných pravidel. A žádný fungující model.
S nástupem strojového učení jsme přestali používat "ruční" pravidla pro rozpoznávání určitého objektu. Místo toho vezmeme tisíc vzorků "toho", X, tisíc vzorků "jiného", Y, a přimějeme počítač, aby na základě jejich statistické analýzy sestavil model. Poté dáme tomuto modelu nějaký příklad dat a on s určitou přesností určí, zda odpovídá jednomu z těchto souborů. Strojové učení generuje model na základě dat, ne prostřednictvím člověka, který ho píše. Výsledky jsou ohromující, zejména v oblasti rozpoznávání obrazů a vzorů, a proto se celá tech industrie nyní přechází na strojové učení (ML).
Ale není to tak jednoduché. V reálném světě vaše tisíce příkladů X nebo Y obsahují také A, B, J, L, O, R a dokonce L. Mohou být nepravidelně rozloženy a některé z nich se mohou vyskytovat tak často, že systém na ně zaměří více pozornosti než na objekty, které vás zajímají.
Co to znamená v praxi? Můj oblíbený příklad je, když systémy rozpoznávání obrazů . Je jasné, proč: většina fotografií-příkladů "ovce" byla pořízena na loukách, kde žijí, a na těchto obrázcích tráva zabírá mnohem více místa než malé bílé chlupaté bytosti, a právě trávu systémy považují za nejdůležitější.
Existují příklady a vážnější. Z nedávna — jeden o detekci rakoviny kůže na fotografiích. Ukázalo se, že dermatologové často fotografují pravítko spolu s projevem rakoviny kůže, aby zdokumentovali velikost útvarů. U příkladů fotografií zdravé kůže pravítka nejsou. Pro systém AI se tato pravítka (přesněji, pixely, které my označujeme jako „pravítko“) stala jedním z rozdílů mezi sadami příkladů, a někdy důležitějšími než malé vyrážky na kůži. Tak systém, vytvořený pro rozpoznávání rakoviny kůže, občas namísto toho rozpoznával pravítka.
Klíčový bod zde je to, že systém nemá semantické porozumění tomu, na co se dívá. My se díváme na sadu pixelů a vidíme v nich ovci, kůži nebo pravítka, zatímco systém vidí pouze číselný řetězec. Nevidí trojrozměrný prostor, nevidí ani objekty, ani textury, ani ovce. Vidí pouze vzory v datech.
Složitost diagnostiky takových problémů spočívá v tom, že neuronová síť (model generovaný vaším systémem strojového učení) se skládá z tisíců a set tisíců uzlů. Neexistuje jednoduchý způsob, jak nahlédnout do modelu a vidět, jak přijímá rozhodnutí. Mít takový způsob by znamenalo, že proces je dostatečně jednoduchý na to, aby bylo možné všechna pravidla popsat ručně, bez použití strojového učení. Lidé mají obavy, že strojové učení se stalo jakýmsi „černým boxem“. (Za chvíli vysvětlím, proč je to přirovnání přehnané.)
To, ve zjednodušené podobě, je problém zaujatosti umělé inteligence nebo strojového učení: systém pro nalezení vzorů v datech může nalézt mylné vzory a vy si toho nemusíte všimnout. To je základní charakteristika technologie a je to zřejmé všem, kdo s ní pracují ve vědeckých kruzích a ve velkých technologických společnostech. Ale její následky jsou složité a naše možná řešení těchto následků také.
Nejprve si promluvme o důsledcích.
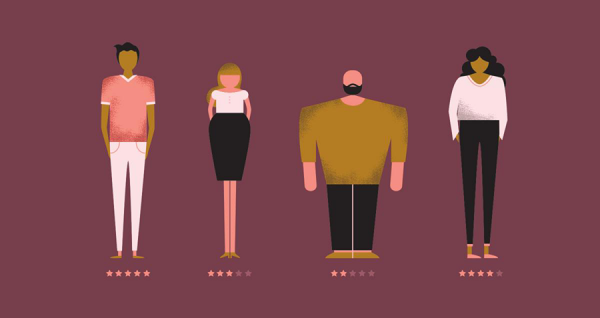
AI nám může implicitně vybírat pro různé kategorie lidí na základě velkého množství nepovšimnutelných signálů
Scénáře zaujatosti AI
Nejsamozřejmější a nejděsivější je, že tento problém se může projevit, když jde o lidskou rozmanitost. Nedávno , že Amazon se pokusil vybudovat systém strojového učení pro primární výběr uchazečů o zaměstnání. Protože mezi zaměstnanci Amazonu je více mužů, příklady "úspěšného náboru" byly také častěji mužského pohlaví, a v selekci životopisů, kterou systém navrhl, bylo více mužů. Amazon si toho všiml a systém neuváděl do produkce.
Nejdůležitější na tomto příkladu je, že systém údajně upřednostňoval uchazeče mužského pohlaví, ačkoliv pohlaví nebylo v životopise uvedeno. Systém viděl jiné vzory v příkladech "úspěšného náboru": například ženy mohou používat specifická slova k popisu svých úspěchů, nebo mít specifická koníčky. Samozřejmě, že systém nevěděl, co je "hokej", kdo jsou "lidé", ani co je "úspěch" — jen prováděl statistickou analýzu textu. Ale vzory, které viděl, by pravděpodobně zůstaly nepozorovány člověkem, a některé z nich (například to, že lidé různých pohlaví různě popisují úspěch) bychom pravděpodobně i při jejich pohledu těžko postřehli.
Dál — hůř. Systém strojového učení, který velmi dobře identifikuje rakovinu na světlé pleti, může horší pracovat s tmavou pletí, nebo naopak. Není to nutně kvůli zaujatosti, ale proto, že pravděpodobně potřebujete vybudovat pro jinou barvu pleti samostatný model, vybrat jiné charakteristiky. Systémy strojového učení nejsou zaměnitelné ani v tak úzké oblasti, jako je rozpoznávání obrazů. Musíte systém nastavit, někdy prostě pomocí pokusů a omylů, abyste dobře postřehli rysy v datech, která vás zajímají, dokud nedosáhnete požadované přesnosti. Ale možná si nevšimnete, že systém je v 98 % případů přesný při práci s jednou skupinou a pouze v 91 % (i když je to přesnější než analýza provedená člověkem) — s jinou.
Doposud jsem používal především příklady týkající se lidí a jejich charakteristik. Téma, na které se tato diskuse většinou zaměřuje. Ale je důležité pochopit, že zaujatost vůči lidem je pouze částí problému. Budeme používat strojové učení pro mnoho věcí, a chyba výběru bude relevantní pro všechny z nich. Na druhou stranu, pokud pracujete s lidmi, může být zaujatost dat spojena nikoli s nimi.
Abychom to pochopili, vraťme se k příkladu s rakovinou kůže a zvažme tři hypotetické možnosti selhání systému.
- Nepravidelná distribuce lidí: nevyvážený počet fotografií pleti různých tónů, což vede k falešně pozitivním nebo falešně negativním výsledkům spojeným s pigmentací.
- Data, na kterých se systém trénuje, obsahují často se vyskytující a nepravidelně distribuovanou charakteristiku, která nesouvisí s lidmi a nemá diagnostickou hodnotu: pravítko na fotografiích projevů rakoviny kůže nebo trávu na fotografiích ovcí. V takovém případě se výsledek liší, pokud systém na obrázku najde pixely něčeho, co lidské oko určí jako "pravítko".
- Data obsahují cizí charakteristiku, kterou člověk nemůže vidět, i když ji bude hledat.
Co to znamená? Apriori víme, že data mohou různě reprezentovat různé skupiny lidí, a minimálně můžeme naplánovat hledání podobných výjimek. Jinými slovy, existuje spousta sociálních důvodů předpokládat, že data o skupinách lidí již obsahují jisté předsudky. Když se podíváme na foto s pravítkem, uvidíme to pravítko – jednoduše jsme to dříve ignorovali, vědouce, že to není důležité, a zapomněli, že systému nic není známo.
Ale co když jsou všechny vaše fotografie nezdravé kůže pořízené v kanceláři, kde se používají žárovky, a zdravé – při fluorescenčním světle? Co když, když jste dokončili snímání zdravé kůže, jste před pořízením nezdravé aktualizovali operační systém na telefonu a Apple nebo Google mírně změnili algoritmus potlačení šumu? Člověk si toho nevšimne, jak moc by se to snažil hledat. Ale systém strojového učení to okamžitě uvidí a využije. Nic neví.
Když jsme mluvili o falešných korelacích, může se také stát, že data jsou přesná a výsledky správné, ale z etických, právních nebo manažerských důvodů je nechcete použít. V některých jurisdikcích například není možné poskytovat ženám slevu na pojištění, i když ženy mohou řídit bezpečněji. Můžeme si snadno představit systém, který při analýze historických dat přiřadí ženským jménům nižší rizikový koeficient. Dobře, odstraníme jména z výběru. Ale vzpomeňte si na příklad s Amazonem: systém může určení pohlaví na základě jiných faktorů (i když neví, co je pohlaví, ani co je auto), a vy si toho nevšimnete, dokud regulátor zpětně neanalyzuje vaše nabízené tarify a neudělí vám pokutu.
Nakonec se často předpokládá, že tyto systémy budeme používat pouze pro projekty související s lidmi a sociálními interakcemi. To ale není pravda. Pokud vyrábíte plynové turbíny, určitě budete chtít použít strojové učení na telemetrii přenášenou desítkami nebo stovkami senzorů na vašem produktu (audio-, video-, teplotní a další senzory generují data, která lze velmi snadno přizpůsobit k vytvoření modelu strojového učení). Hypoteticky můžete říci: „Tady jsou data o tisíci porouchaných turbínách, získaná před jejich poruchou, a tady jsou data z tisíce turbín, které neporouchaly. Vytvořte model, abyste řekli, jaký je mezi nimi rozdíl.“ A teď si představte, že senzory Siemens jsou na 75 % špatných turbín a pouze na 12 % dobrých (přitom neexistuje žádná vazba na poruchy). Systém vytvoří model, aby našel turbíny se senzory Siemens. Ups!

Obrázek — Moritz Hardt, UC Berkeley
Řízení předpojatosti AI
Co s tím můžeme udělat? Můžeme se na problém podívat ze tří stran:
- Metodologická přísnost při sběru a správě dat pro trénink systému.
- Technické nástroje pro analýzu a diagnostiku chování modelu.
- Školení, vzdělávání a opatrnost při implementaci strojového učení do produktů.
V knize „Měšťan v šlechtě“ od Molièra je vtip: jednomu muži řekli, že literatura se dělí na prózu a poezii, a on s nadšením zjišťuje, že celý život mluvil prózou, aniž by to věděl. Pravděpodobně se statistici dnes cítí nějak podobně: aniž by si toho všimli, zasvětili své kariéry umělé inteligenci a chybě ve vzorkování. Hledání chyby ve vzorkování a trápení se kvůli ní — to není nový problém, musíme k jeho řešení přistoupit systematicky. Jak již bylo zmíněno, v některých případech je skutečně jednodušší zkoumat problémy spojené s daty o lidech. A priori předpokládáme, že můžeme mít předsudky vůči různým skupinám lidí, ale předsudek vůči senzorům Siemens si těžko dokážeme představit.
Nové na tom všem je, že lidé se již nezabývají statistickou analýzou přímo. Tu vykonávají stroje, které vytvářejí velké složité modely, které jsou obtížné k pochopení. Otázka transparentnosti je jedním z hlavních aspektů problému zaujatosti. Bojíme se, že systém není jen zaujatý, ale že není žádná možnost odhalit jeho zaujatost, a že strojové učení se tímto liší od jiných forem automatizace, které se, jak se předpokládá, skládají z jasných logických kroků, které lze ověřit.
Zde jsou dva problémy. Možná bychom přece jen mohli provádět určitý audit systémů strojového učení. A audit jakéhokoli jiného systému ve skutečnosti není o nic snazší.
Za prvé, jedním z směrů současného výzkumu v oblasti strojového učení je hledání metod, jak identifikovat důležitou funkčnost systémů strojového učení. Strojové učení (ve svém současném stavu) je zcela nová vědecká oblast, která se rychle mění, takže nemá smysl myslet si, že věci, které dnes nejsou možné, se nemohou brzy stát docela reálnými. Projekt je zajímavým příkladem.
Za prvé, myšlenka, že lze zkoumat a chápat proces rozhodování v existujících systémech nebo organizacích, je teoreticky zajímavá, ale v praxi to už tak skvělé není. Pochopit, jak se rozhodnutí přijímají ve velké organizaci, není vůbec snadné. I když existuje formální proces rozhodování, neodráží to skutečný způsob, jakým lidé interagují, a navíc často sami nemají logický systémový přístup k přijímání svých rozhodnutí. Jak řekl můj kolega , lidé jsou také černé boxy.
Vezměte tisíc lidí z několika překrývajících se firem a institucí, a problém se stane ještě složitějším. Po skutečnosti víme, že „Space Shuttle“ mělo rozpadnout na kusy při návratu, a jednotlivci uvnitř NASA měli informace, které je opravňovaly k tomu, aby si mysleli, že by se mohlo stát něco špatného, ale systém toho obecně nebyl vědom. NASA právě prošla podobným auditem, kdy ztratila předchozí Shuttle, a přesto ztratila další — ze velmi podobného důvodu. Je snadné tvrdit, že organizace a lidé dodržují jasná logická pravidla, která lze ověřit, pochopit a změnit — ale zkušenosti dokazují opak. To je "».
Často srovnávám strojové učení s databázemi, zejména s relačními — novou základní technologií, která změnila možnosti informatiky a svět kolem ní, která se stala součástí všeho, co neustále používáme, aniž bychom si to uvědomovali. I databázích také existují problémy, které mají podobnou povahu: systém může být postaven na nesprávných předpokladech nebo špatných datech, což však bude těžké postřehnout, a lidé, kteří systém používají, budou dělat to, co jim říká, aniž by se ptali. Existuje spousta starých vtipů o daňových úřednících, kteří jednou špatně zapsali vaše jméno, a přesvědčit je, aby chybu opravili, je mnohem obtížnější než vlastně změnit jméno. O tom se může přemýšlet různě, ale není jasné, co je lepší: považovat to za technický problém v SQL, za chybu v novém vydání Oracle, nebo za selhání byrokratických institucí? Jak obtížné je najít chybu v procesu, který vedl k tomu, že systém nemá takovou funkci, jako je oprava překlepů? Mohlo se to pochopit ještě předtím, než začali lidé stěžovat?
Tento problém ilustrují ještě lépe příběhy, kdy řidiči kvůli zastaralým datům v navigaci sjíždějí do řek. Dobře, mapy by se měly neustále aktualizovat. Ale do jaké míry je TomTom vinen za to, že vaše auto odnáší do moře?
Říkám to proto, že ano — zaujatost strojového učení vytvoří problémy. Ale tyto problémy budou podobné těm, se kterými jsme se v minulosti setkávali, a budou je moci postřehnout a vyřešit (nebo ne) přibližně tak dobře, jak se nám to dařilo v minulosti. Proto je nepravděpodobné, že by se scénář, ve kterém by zaujatost AI způsobila škodu, stal s předními výzkumníky, kteří pracují ve velké organizaci. Spíše nějaký nezajímavý technologický dodavatel nebo výrobce softwaru napíše něco z brucha, přičemž použije pro něj nepochopitelné open-source komponenty, knihovny a nástroje. A nešťastný zákazník se nechá unést slovním spojením „umělá inteligence“ v popisu produktu a bez zbytečných otázek to předá svým nízko placeným zaměstnancům, kteří budou nuceni dělat to, co řekne AI. To se právě stalo s databázemi. To není problém umělé inteligence, ani problém softwaru. To je lidský faktor.
Závěr
Strojové učení může udělat vše, čemu můžete naučit psa — ale nikdy si nemůžete být jisti, čemu jste toho psa skutečně naučili.
Často mám dojem, že termín „umělá inteligence“ jen brání tomu, abychom se dostali k diskuzím jako je tato. Tento termín vytváří falešný dojem, že jsme jej skutečně vytvořili — tuto inteligenci. Že jsme na cestě k HAL9000 nebo Skynet — k něčemu, co skutečně rozumí. Ale ne. Jsou to jen stroje a je mnohem správnější je srovnávat, řekněme, s pračkou. Ta mnohem lépe zvládá praní než člověk, ale pokud do ní dáte nádobí místo prádla, to jej… vypere. Nádobí bude dokonce čisté. Ale nebude to to, co jste očekávali, a k tomu dojde nejen proto, že systém má nějaké předsudky o nádobí. Pračka neví, co je nádobí, ani co je oblečení — je to jen příklad automatizace, která se konceptuálně neliší od toho, jak byly procesy automatizovány dříve.
Ať už je téma jakékoli — o strojích, letadlech nebo databázích — tyto systémy budou zároveň velmi mocné a velmi omezené. Bude to zcela závislé na tom, jak lidé tyto systémy používají, zda mají dobré nebo špatné úmysly a jak dobře chápou jejich fungování.
Proto tvrzení, že „umělá inteligence je matematika, tudíž nemůže mít předsudky“, je naprosto nesprávné. Ale stejně tak špatné je tvrdit, že strojové učení je „subjektivní ve své podstatě“. Strojové učení nachází vzory v datech a jaké vzory najde, závisí na datech, a ta závisí na nás. Stejně jako na tom, co s nimi děláme. Strojové učení skutečně dělá některé věci mnohem lépe než my — ale psi jsou například mnohem efektivnější než lidé při objevování drog, což rozhodně není důvod k tomu je povolávat jako svědky a vynášet rozsudky na základě jejich svědectví. A psi, mimochodem, jsou mnohem chytřejší než jakýkoli systém strojového učení.
Překlad: .
Editace: .
Komunita: .
Zdroj: habr.com
