

V jednom z chatů mi položili otázku:
— Je něco, co bych si mohl přečíst o správném zabalení serverů do skříní?
Uvědomil jsem si, že takový text neznám, a proto jsem napsal svůj.
Za prvé, tento text se týká fyzických serverů ve fyzických datových centrech (DC). Za druhé, předpokládejme, že máme dostatek serverů: stovky až tisíce. Pro menší množství tento text nemá smysl. Za třetí, máme tři omezení: fyzické místo ve skříních, napájení na skříň, a skříně stojí v řadách, takže můžeme použít jeden ToR switch pro připojení serverů ve vedlejších skříních.
Odpověď na otázku silně závisí na tom, který parametr optimalizujeme a co můžeme měnit, abychom dosáhli nejlepšího výsledku. Například je možné, že jen potřebujeme zabrat minimum místa, abychom více uvolnili pro budoucí růst. Možná máme volnost ve výběru výšky skříní, výkonu na skříň, zásuvek v PDU, počtu skříní ve skupině switchů (jeden switch na 1, 2 nebo 3 skříně), délce kabelů a práci na kabeláži (to je kritické na koncích řad: při 10 skříních v řadě a 3 skříních na switch musíme tahat kabely do jiného řadu, nebo nevyužít porty ve switchi), atd., atd. Samostatné příběhy: volba serverů a volba DC, budeme předpokládat, že byly vybrány.
Bylo by dobré porozumět některým nuancím a podrobnostem, zejména průměrnému/maximálnímu odběru serverů a tomu, jak nám je dodávána elektřina. Takže, pokud máme ruské napětí 230V a jednu fázi na skříň, pak 32A jistič může udržet ~7kW. Dejme tomu, že nominálně platíme za 6kW na skříň. Pokud poskytovatel měří naši spotřebu pouze podle řady 10 skříní, a ne podle každé skříně, a pokud je jistič nastaven na odstavení na přibližně 7kW, pak technicky můžeme v jedné skříni spotřebovat 6.9kW, v jiné 5.1kW a vše bude v pořádku — bez postihu.
Obvykle je naším hlavním cílem minimalizace výdajů. Nejlepším kritériem pro měření je snížení TCO (total cost of ownership — celkové náklady na vlastnictví). Tvoří je následující části:
- CAPEX: nákup infrastruktury DC, serverů, síťového hardwaru a kabeláže
- OPEX: nájem DC, spotřebovaná elektřina, údržba. OPEX závisí na životnosti. Je rozumné předpokládat, že je rovný 3 rokům.
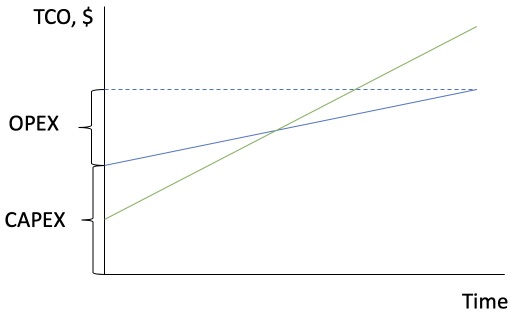
V závislosti na tom, jak velké jsou jednotlivé části v celkovém celku, musíme optimalizovat to nejdražší a ostatní ať využívá všechny zbylé zdroje co nejefektivněji.
Představme si, že máme již existující datové centrum, výšku racku H jednotek (pro příklad H=47), elektrickou spotřebu na rack Prack (Prack=6kW) a rozhodli jsme se použít h=2U dvouunitové servery. Odebereme 2..4 jednotky z racku na switche, patch panely a organizéry. Tedy fyzicky se nám do racku vejde Sh=rounddown((H-2..4)/h) serverů (t.j. Sh = rounddown((47-4)/2)=21 server na rack). Zapamatujeme si toto Sh.
V jednoduchém případě jsou všechny servery v racku stejné. Celkově, pokud naplníme rack servery, tak na každý server můžeme průměrně vynaložit výkon Pserv=Prack/Sh (Pserv = 6000W/21 = 287W). Pro zjednodušení zde ignorujeme spotřebu switche.
Uděláme krok zpět a určíme, co je maximální spotřeba serveru Pmax. Pokud to řekneme jednoduše, velmi neefektivně a zcela bezpečně, pak čteme, co je napsáno na napájecím zdroji serveru — to je ono.
Pokud je to složitější, efektivněji, tak vezmeme TDP (thermal design package) všech komponent a sečteme je (to není úplně pravda, ale jde to i tak).
Obvykle neznáme TDP komponentů (kromě CPU), proto bereme ten nejobvyklejší, ale i nejsložitější přístup (potřebujeme laboratoř) — vezmeme experimentální server v potřebné konfiguraci a zatížíme ho, například Linpackem (CPU a paměť) a fio (disky), měříme spotřebu. Pokud to myslíme vážně, musíme také vytvářet co nejteplejší prostředí v chladném chodbě během testů, protože to ovlivňuje spotřebu ventilátorů i CPU. Získáváme maximální spotřebu konkrétního serveru s konkrétní konfigurací v těchto konkrétních podmínkách pod touto konkrétní zátěží. Mějme na paměti, že nový firmware systému, jiná verze softwaru, další podmínky mohou ovlivnit výsledek.
Celkově se vracíme k Pserv a jak ho porovnat s Pmax. To je otázka pochopení práce služeb a toho, jak silné nervy má váš technický ředitel.
Pokud nechceme riskovat, pak předpokládáme, že všechny servery mohou současně začít spotřebovávat svůj maximum. V tomto okamžiku může nastat jeden vstup do datového centra. Infrastruktura a za těchto podmínek musí poskytovat službu, takže Pserv ≡ Pmax. To je přístup, kde je absolutně důvěryhodnost zásadní.
Pokud technický ředitel myslí nejen na dokonalou bezpečnost, ale i na finance společnosti a je dost odvážný, můžeme usoudit, že
- začínáme řídit naše dodavatele, zejména zakazujeme provádět plánovanou údržbu během očekávané špičky, abychom minimalizovali výpadky jednoho vstupu;
- a/nebo naše architektura umožňuje ztratit skříň/řadu/datové centrum, a služby pokračují v práci;
- a/nebo dobře rozložíme zátěž horizontálně mezi skříně, takže naše služby nikdy nepřeskočí na maximální spotřebu v jednom racku vše najednou.
Je velmi užitečné nejen hádat, ale také monitorovat spotřebu a vědět, jak skutečně spotřebovávají servery elektřinu za běžných a špičkových podmínek. Proto po určité analýze technický ředitel zúží vše, co má, a říká: „my rozhodnutím stanovíme, že maximálně dosažitelné průměrné hodnoty z maximálních spotřeb na rack budou **o tolik** nižší než maximální spotřeba,“ zjednodušeně Pserv=0.8*Pmax.
A potom do skříně na 6kW se již nevejde 16 serverů s Pmax = 375W, ale 20 serverů s Pserv = 375W * 0.8 = 300W. To znamená o 25 % více serverů. To je velmi velká úspora — vždyť také potřebujeme o 25 % méně skříní (a ušetříme také na PDU, switchích a kabelech). Velkým nedostatkem tohoto řešení je, že musíme neustále monitorovat, zda jsou naše předpoklady stále platné. Zda nová verze firmwaru nezměnila podstatným způsobem činnost ventilátorů a spotřebu, zda vývoj se s novým vydáním nezačal využívat servery mnohem efektivněji (jinými slovy, dosáhli vyšší zátěže a větší spotřeby na server). Protože pak naše původní předpoklady a závěry se okamžitě stávají neplatnými. To je riziko, které je třeba zodpovědně přijmout (nebo se mu vyhnout a potom platit za očividně nedostatečně zatížené skříně).
Důležité poznámka — je dobré se snažit rozložit servery z různých služeb horizontálně mezi racky, pokud to je možné. Je to potřeba, aby se zabránilo situacím, kdy jedna dávka serverů pro jednu službu přichází a racky jsou vertikálně naplněny pro zvýšení „hustoty“ (protože je to jednodušší). Ve skutečnosti však dojde k situaci, kdy je jeden rack zaplněn stejnými nízkoužitkovými servery jedné služby a druhý — stejně vysokoužitkovými. Pravděpodobnost selhání druhého je podstatně vyšší, protože profil zatížení je stejný a všechny servery v tomto racku začnou na základě zvýšeného zatížení spotřebovávat stejně hodně.
Vraťme se k rozložení serverů v rackech. Prozkoumali jsme fyzická omezení místa v racku a omezení elektrického napájení, teď se podívejme i na síť. Lze použít switche s 24/32/48 porty N (pro příklad máme 48-portové ToR switche). Naštěstí není tolik variant, pokud se nezabýváme break-out kabely. Zvažujeme scénáře, kdy máme jeden switch na rack, jeden switch na dva nebo tři racky ve skupině Rnet. Myslím, že více než tři racky ve skupině je už příliš, protože problém kabeláže mezi racky se stává mnohem větším.
Takže pro každý síťový scénář (1, 2 nebo 3 racky ve skupině) rozložíme servery mezi racky:
Srack = min(Sh, rounddown(Prack/Pserv), rounddown(N/Rnet))
Takže pro variantu se 2 racky ve skupině:
Srack2 = min(21, rounddown(6000/300), rounddown(48/2)) = min(21, 20, 24) = 20 serverů na rack.
Podobně počítáme ostatní varianty:
Srack1 = 20
Srack3 = 16
A jsme prakticky na cíli. Počítáme počet racků pro rozložení všech našich serverů S (nechť je to 1000):
R = roundup(S / (Srack * Rnet)) * Rnet
R1 = roundup(1000 / (20 * 1)) * 1 = 50 * 1 = 50 racků
R2 = roundup(1000 / (20 * 2)) * 2 = 25 * 2 = 50 racků
R3 = roundup(1000 / (16 * 3)) * 3 = 25 * 2 = 63 racky
Dále počítáme TCO pro každou variantu na základě počtu racků, potřebného počtu switchů, kabeláže atd. Vybereme tu variantu, kde je TCO nižší. Profit!
Všimněte si, že ačkoliv je potřebný počet racků pro varianty 1 a 2 stejný, jejich cena bude různá, protože počet switchů pro druhou variantu je dvojnásobně menší, zatímco délka potřebných kabelů je větší.
P.S. Pokud existuje možnost hrát si s výkonem a výškou skříně, variabilita se zvyšuje. Proces však lze zjednodušit na výše popsané, prostým procházením variant. Ano, kombinací bude více, ale přesto velmi omezené množství — napájení skříně pro výpočet lze zvyšovat po 1 kW, standardní skříně bývají v omezeném počtu rozměrů: 42U, 45U, 47U, 48U, 52U. A zde může pomoci Excelovská analýza Co-Kdyby v režimu Datová tabulka. Podíváme se na získané tabulky a vybereme minimum.
Zdroj: habr.com
