

Po pěti měsících vývoje byl zveřejněn release projektu IncidentRelay 1.1, který rozvíjí otevřený systém pro organizaci pohotovostí, směrování upozornění a podporu incidentů, spuštěný na vlastním serveru (self-hosted). IncidentRelay 1.1 je označena jako první stabilní release (větev 1.0 měla status beta verze). Projekt je zaměřen na týmy SRE, DevOps a infrastruktury, které potřebují lokálně nasadit alternativu k SaaS službám pro správu pohotovosti (on-call management), uplatňování eskalačních politik a reakci na incidenty. Kód projektu je napsán v Pythonu a je distribuován pod licencí MIT.
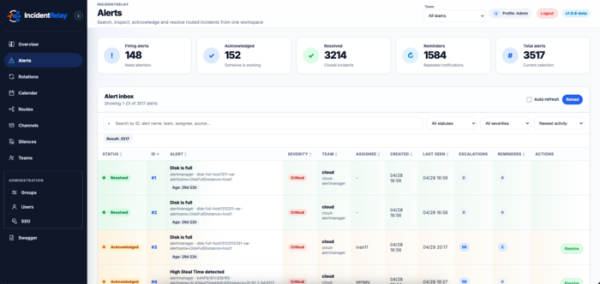
IncidentRelay přijímá události ze systémů monitorování, přiřazuje je k službě, týmu a rotaci, a poté doručuje oznámení odpovědným pohotovostním pracovníkům nebo týmům. Systém implementuje rozvrhy pohotovostí, rotace, předefinování směn, potvrzení o přijetí incidentu, stavy ACK/Resolve, připomínky, eskalace, dočasné výměny pohotovostních pracovníků, stanovení doby plánovaných prací a potlačení hlučných upozornění.
Hlavní výhoda projektu — úplná kontrola nad infrastrukturou a logikou směrování. IncidentRelay se nasazuje ve vlastním prostředí, pracuje se svou databází a umožňuje jasně oddělit příchozí směry, týmy, rotace a kanály doručování. Příchozí tokeny patří směrování, nikoli kanálům, takže je jednodušší pochopit, který externí zdroj má právo odesílat události konkrétnímu týmu.
V IncidentRelay je podporován příjem událostí z Prometheus Alertmanager, Grafana Alerting, Zabbix, Sentry, LibreNMS, RMON, AWS SNS/CloudWatch a libovolných webhooků. Pro odesílání oznámení jsou k dispozici kanály Mattermost, Slack, Telegram, Discord, Microsoft Teams, email, webhooky, push notifikace pro prohlížeče/PWA a poskytovatelé hlasových hovorů. V Mattermost a Telegram mohou oznámení obsahovat akce pro potvrzení a vyřešení problému, což umožňuje zpracování incidentu bez přechodu do samostatného rozhraní.
Projekt lze spouštět prostřednictvím Docker Compose, RPM balíčku pro distribuce podobné Red Hatu, ručně přes systemd, stejně jako v Kubernetes pomocí Helm chartu. Pro malé instalace lze použít SQLite, pro pracovní systémy a vyšší zátěž se doporučuje PostgreSQL.
V nové verzi jsou navrženy následující změny:
- Byly přidány víceúrovňové on-call rotace s časovými omezeními, prioritami vrstev a zohledněním dočasných náhrad;
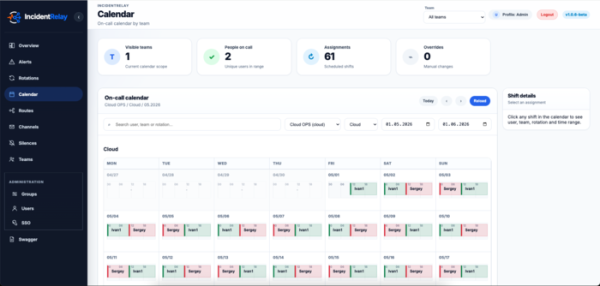
- Objevil se kalendář pohotovostních služeb, CalDAV a ICS předplatné pro externí kalendáře;
- Byly implementovány politiky eskalace incidentů s vícestupňovými řetězci zvyšování úrovně;
- Byly přidány skupiny upozornění, seskupování událostí, odložená oznámení a ruční sloučení souvisejících alertů;
- Objevily se okna pro provádění plánovaných prací a "tichá" upozornění;
- Byla přidána možnost přidávat komentáře k alertům;
- Byly přidány priority incidentů (P1-P5) a automatické zvyšování priority podle důležitosti;
- Byly realizovány služební katalogy, závislosti služeb, SLI/SLO, historie vlivu na funkčnost systémů (Service Impact History) a obchodní služby (Business Services);
- Objevil se Explain Trace pro analýzu routingu: proč alert skončil nebo neskončil v týmu, byl seskupen, potlačen nebo zaslán do konkrétního kanálu;
- Byly přidány kontroly (Heartbeats/dead-man switch) pro watchdog, backup, ETL a další úkoly, kde je problémem nedostatek očekávaného signálu.
Zdroj: opennet.ru
