

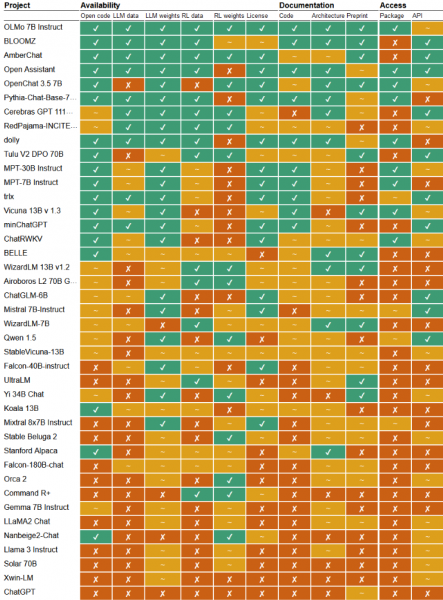
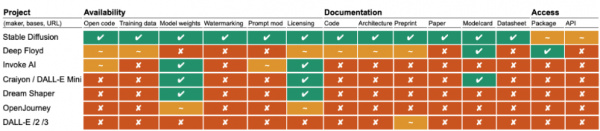
Výzkumníci z Radboudské univerzity v Nijmegen (Nizozemsko) připravili žebříček otevřenosti 40 velkých jazykových modelů a 7 modelů pro generování obrázků na základě textového popisu, které výrobci označují jako otevřené. Vzhledem k tomu, že kritéria otevřenosti modelů strojového učení se teprve formují, vznikla situace, kdy se pod záminkou otevřenosti šíří modely, které mají licenci omezující rozsah použití (například mnohé modely zakazují užití v komerčních projektech). Často také výrobci neposkytují přístup k datům použitým při trénování, neodhalují detaily implementace nebo plně neotevřou související kód.
Většinu modelů, které se prezentují jako „otevřené“, je třeba brát spíše jako „otevřené váhové koeficienty“ nebo přesněji „dostupné váhové koeficienty“, protože jsou šířeny pod omezujícími licencemi zakazujícími použití v komerčních produktech. Externí výzkumníci mohou s takovými modely experimentovat, ale nemají možnost přizpůsobit model svým potřebám nebo prozkoumat implementaci. Více než polovina modelů neposkytuje podrobnosti o datech, která byla použita pro trénink, a také nezveřejňuje informace o vnitřní struktury a architektuře.
Nejotevřenějšími modely jsou považovány BloomZ, AmberChat, OLMo, Open Assistant a Stable Diffusion, které byly publikovány pod otevřenými licencemi spolu se vstupními daty, kódem a implementací API. Modely od Googlu (Gemma 7B), Microsoftu (Orca 2) a Meta (Llama 3), které jsou výrobci označovány jako otevřené, skončily blíže konci žebříčku, protože neposkytují přístup k vstupním datům, neodhalují technické detaily implementace a váhové koeficienty modelu šíří pod licencemi, které omezují rozsah použití. Populární model Mistral 7B se umístil přibližně v polovině žebříčku, protože je dodáván pod otevřenou licencí, ale je pouze částečně zdokumentován, nezveřejňuje data použitá při trénování a má neúplně otevřený související kód.
Výzkumníci navrhli 14 kritérií otevřenosti AI modelů, která zahrnují podmínky pro zveřejnění kódu, dat pro učení, vah, variant dat a parametrů optimalizovaných pomocí učení s posilováním (RL), jakož i dostupnost balíčků, API, dokumentace a podrobného popisu implementace.
Podle navrženého konceptu definice otevřeného AI organizací OSI (Open Source Initiative) jsou hlavními kritérii otevřenosti AI systému poskytnutí možností využití k jakýmkoli účelům bez nutnosti získání samostatného povolení; studium činnosti systému a inspekce jeho komponent; provádění změn pro jakékoli účely; předání jiným osobám jak původní verze, tak i edice po provedení změn.
Aby bylo možné provádět změny, AI systém musí zahrnovat:
- Podrobné informace o datech použitých během trénování a metodologii trénování. Informace by měly být dostatečné, aby profesionální vývojář mohl sám reprodukovat ekvivalentní AI systém, využívající ke trénování stejná nebo podobná data.
- Dostupnost zdrojového kódu, který umožňuje nejen spuštění AI systému, ale i provedení procesu jeho učení (v uvedené tabulce, ve sloupci "kód" je u mnoha modelů uvedeno "~", což naznačuje částečnou dostupnost kódu, kdy je dostupný kód pro spuštění modelu, ale chybí kód pro učení nebo vytvoření modelu). Kód by měl také pokrývat oblasti, jako je předzpracování, kontrola dat a tokenizace. Kromě toho by měl být poskytnut podrobný popis architektury modelu.
- Parametry modelu (váhové koeficienty), které naznačují přítomnost stavu připraveného k použití po tréninku nebo přítomnost finální optimalizované varianty modelu.
Zdroj: opennet.ru
