

Už jsme to udělali!
„Cílem tohoto kurzu je připravit vás na vaši technickou budoucnost.“
 Ahoj, Habre. Pamatujete si na úžasný článek (+219, 2588 do záložek, 429k přečtení)?
Tak to je u Hammingových (ano, ano, sebespravující a sebekontrolující ) existuje celá , napsaná podle jeho přednášek. Překládáme ji, protože ten chlápek má pravdu.
Tato kniha není jen o IT, je to kniha o stylu myšlení neuvěřitelně skvělých lidí. „To není jen dávka pozitivního myšlení; popisuje podmínky, které zvyšují šance na vytvoření veliké práce.“
Děkujeme Andrey Pakhomov za překlad.
Teorie informace byla vyvinuta C. E. Shannonem na konci 40. let. Vedení Bellových laboratoří trvalo na tom, aby ji nazval „Teorie spojení“, protože to je mnohem přesnější název. Zřejmými důvody je název „Teorie informace“ mnohem více poutavý pro veřejnost, a proto si Shannon zvolil právě ten, který je znám i dnes. Sám název naznačuje, že teorie se zabývá informacemi, což ji činí důležitou, protože se stále hlouběji dostáváme do informační epochy. V této kapitole se dotknu několika základních závěrů této teorie a přednesu nikoli striktní, ale spíše intuitivní důkazy některých izolovaných tezí této teorie, abyste pochopili, co vlastně „Teorie informace“ je, kde ji můžete aplikovat a kde ne.
Nejprve, co je to „informace“? Shannon ztotožňuje informaci s neurčitostí. Zvolil negativní logaritmus pravděpodobnosti události jako kvantitativní míru informace, kterou získáte, když nastane událost s pravděpodobností p. Například, pokud vám řeknu, že v Los Angeles je mlhavé počasí, pak p je blízko 1, což nám vlastně nijak zvlášť mnoho informací nepřináší. Ale pokud řeknu, že v červnu prší v Monterey, pak tato zpráva nese určitou neurčitost a obsahuje více informací. Skutečná událost nenese žádné informace, protože log 1 = 0.
Podívejme se na to podrobněji. Shannon se domníval, že kvantitativní míra informace by měla být spojitou funkcí pravděpodobnosti události p, a pro nezávislé události by měla být aditivní – množství informací získaných z provádění dvou nezávislých událostí by mělo být rovno množství informací získaných z provádění společné události. Například výsledky hodu kostkou a mincí se obvykle považují za nezávislé události. Převeďme výše uvedené do jazyka matematiky. Pokud I(p) je množství informací, které je obsaženo v události s pravděpodobností p, pak pro společnou událost složenou ze dvou nezávislých událostí x s pravděpodobností p1 a y s pravděpodobností p2 dostaneme
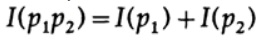
(x a y jsou nezávislé události)
To je funkční rovnice Cauchy, pravdivá pro všechna p1 a p2. Pro vyřešení této funkční rovnice předpokládejme, že
p1 = p2 = p,
to dává
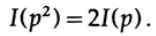
Pokud p1 = p2 a p2 = p, pak
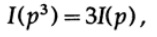
atd. Rozšiřováním tohoto procesu, používajícího standardní metodu pro exponenty, je pro všechna racionální čísla m/n platné následující
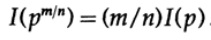
Z předpokládané kontinuity informační míry vyplývá, že logaritmická funkce je jediným kontinuálním řešením funkční rovnice Cauchy.
V teorii informace se obvykle předpokládá, že základ logaritmu je 2, proto binární volba obsahuje přesně 1 bit informace. Následně se informace měří podle vzorce
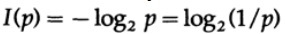
Zastavme se a podívejme se, co se stalo výše. Především jsme tak nějak nedali definici pojmu „informace“, pouze jsme definovali vzorec její kvantitativní míry.
Za druhé, tato míra závisí na neurčitosti a i když je dostatečně vhodná pro stroje – například telefonní systémy, rádio, televizi, počítače atd. – neodráží normální lidský vztah k informacím.
Za třetí, je to relativní míra, závislá na aktuálním stavu vašich znalostí. Pokud se díváte na tok „náhodných čísel“ z generátoru náhodných čísel, domníváte se, že každé další číslo je neurčité, ale pokud znáte vzorec pro výpočet „náhodných čísel“, další číslo bude známo a tudíž v sobě nebude obsahovat žádné informace.
Tímto způsobem definice informace, kterou uvedl Shannon, v mnoha ohledech vyhovuje strojům, ale zdá se, že neodpovídá lidskému chápání tohoto slova. Proto by bylo lepší nazvat "Teorii informace" "Teorií komunikace". Nicméně už je příliš pozdě na to, abychom měnili definice, které způsobily, že se teorie stala populární a které stále lidem dávají dojem, že se tato teorie zabývá "informacemi". Proto jsme nuceni s nimi smířit, ale vy musíte jasně pochopit, jak daleko je Shannonova definice informace od jejího běžného významu. Shannonova informace se zabývá něčím úplně jiným, a to nejistotou.
Na to je třeba myslet, když navrhujete jakoukoli terminologii. Jak moc odpovídá navrhovaná definice, například definice informace podle Shannona, vaší původní myšlence a jak se liší? Téměř neexistuje termín, který by přesně odrážel váš předchozí pohled na koncept, ale nakonec terminologie, kterou používáme, odráží smysl konceptu, takže formalizace něčeho pomocí jasných definic vždy přináší určitou míru šumu.
Zvažme systém, jehož abeceda se skládá z symbolů q s pravděpodobnostmi pi. V tomto případě průměrný počet informací v systému (jeho očekávaná hodnota) je roven:
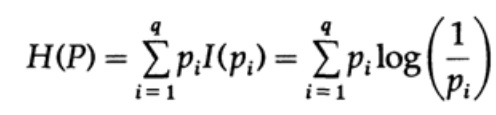
Toto se nazývá entropie systému s rozdělením pravděpodobnosti {pi}. Používáme termín "entropie", protože stejný matematický tvar se objevuje v termodynamice a statistické mechanice. Právě proto termín "entropie" vyvolává kolem sebe určitou auru důležitosti, která v konečném důsledku není odůvodněná. Stejná matematická forma zápisu nezaručuje stejnou interpretaci symbolů!
Entropie rozdělení pravděpodobnosti hraje hlavní roli v teorii kódování. Gibbsova nerovnost pro dvě různé rozdělení pravděpodobnosti pi a qi je jedním z důležitých důsledků této teorie. Musíme tedy dokázat, že
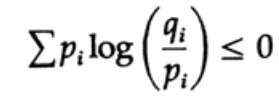
Důkaz se zakládá na zřejmém grafu, obr. 13.I, který ukazuje, že
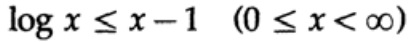
a rovnost je dosažena pouze při x = 1. Aplikujeme nerovnost na každé členění součtu levé části:
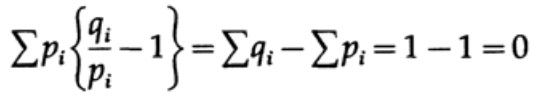
Pokud je abeceda komunikačního systému složena z q symbolů, přijímáme pravděpodobnost přenosu každého symbolu qi = 1/q a dosazením q získáváme z Gibbseovy nerovnosti.
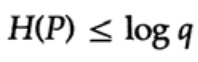
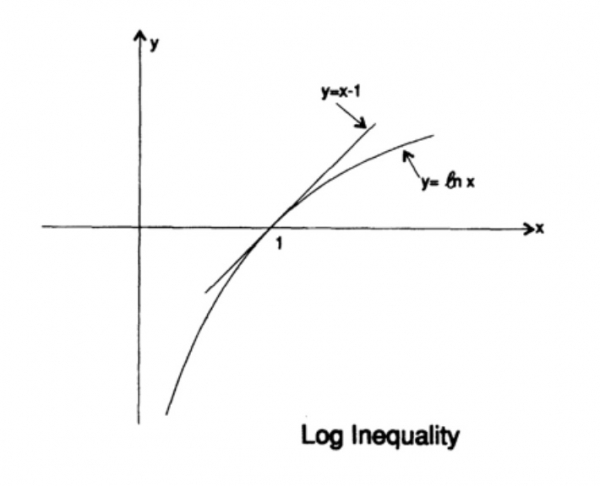
Obrázek 13.I
To znamená, že pokud je pravděpodobnost přenosu všech q symbolů stejná a rovna — 1/q, maximální entropie je rovna ln q, jinak platí nerovnost.
V případě jednoznačně dekódovatelného kódu máme Kraftovu nerovnost.
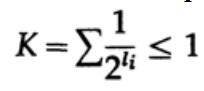
Nyní, pokud definujeme pseudo-pravděpodobnosti,
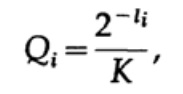
kde je to konečné, 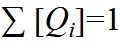 = 1, což vyplývá z Gibbseovy nerovnosti,
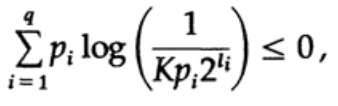
a použijeme trochu algebry (pamatujte, že K ≤ 1, takže logaritmický člen můžeme vynechat a možná později posílit nerovnost), dostaneme,
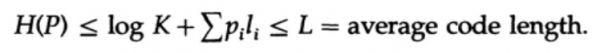
kde L je průměrná délka kódu.
Takže entropie je minimální hranicí pro jakýkoli symbolový kód s průměrnou délkou kódového slova L. To je Shannonova věta pro kanál bez šumu.
Nyní se podíváme na hlavní teorii o omezeních komunikačních systémů, kde je informace přenášena ve formě toku nezávislých bitů a přítomen je šum. Předpokládá se, že pravděpodobnost správného přenosu jednoho bitu P > 1/2, a pravděpodobnost, že hodnota bitu bude při přenosu invertována (dojde k chybě) je Q = 1 - P. Pro usnadnění předpokládejme, že chyby jsou nezávislé a pravděpodobnost chyby je stejná pro každý odeslaný bit — tedy v komunikačním kanálu je přítomen „bílý šum“.
Můžeme mít dlouhý tok z n bitů zakódovaných do jedné zprávy — n-dimenzionální rozšíření jednoho bitového kódu. Hodnotu n určíme později. Považujme zprávu složenou z n-bitů za bod v n-rozměrném prostoru. Protože máme n-rozměrný prostor — a pro zjednodušení budeme předpokládat, že každá zpráva má stejnou pravděpodobnost vzniku — existuje M možných zpráv (M bude také definováno později), tudíž pravděpodobnost jakékoliv odeslané zprávy je

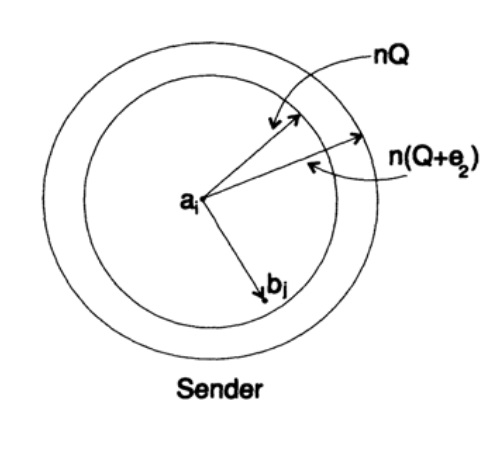
(odesílatel)
Graf 13.II
Dále se zaměříme na myšlenku šířky pásma kanálu. Bez podrobností lze říci, že šířka pásma kanálu se určuje jako maximální objem informací, který může být spolehlivě přenesen přes komunikační kanál, přičemž se zohledňuje maximálně efektivní kódování. Neexistují žádné důkazy, že by bylo možné přenést více informací přes komunikační kanál, než činí jeho kapacita. To lze dokázat pro binární symetrický kanál (který v našem případě používáme). Kapacita kanálu při přenosu bitů je určena jako
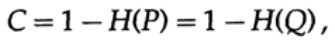
kde, jak už bylo dříve, P je pravděpodobnost absence chyby v jakémkoli odeslaném bitu. Při odesílání n nezávislých bitů se kapacita kanálu určuje jako
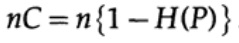
Pokud jsme blízko šířce pásma kanálu, musíme odeslat téměř takové množství informací pro každý ze symbolů ai, i = 1, …, M. S ohledem na to, že pravděpodobnost vzniku každého symbolu ai je 1 / M, dostaneme
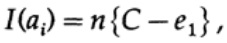
když odesíláme jakoukoli z M stejně pravděpodobných zpráv ai, máme
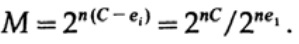
Při odesílání n bitů očekáváme vznik nQ chyb. V praxi budeme mít pro zprávu složenou z n bitů přibližně nQ chyb v přijaté zprávě. Při velkých n bude relativní variace (variace = šířka rozdělení, )
distribuce počtu chyb stále užší s rostoucím n.
Takže ze strany vysílače vezmu zprávu ai k odeslání a nakreslím kolem ní kouli s poloměrem
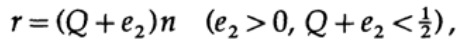
který je o něco větší o hodnotu rovnou e2 než očekávaný počet chyb Q, (obrázek 13.II). Pokud je n dostatečně velké, pak existuje jakákoli malá pravděpodobnost, že bod zprávy bj na straně příjemce překročí hranici této koule. Na situaci se podíváme, jak ji vidím já z pohledu vysílače: máme jakékoli poloměry od odeslané zprávy ai k přijaté zprávě bj s pravděpodobností chyby rovnou (nebo téměř rovnou) normálnímu rozdělení, dosahujícímu maxima v nQ. Pro jakékoli dané e2 existuje n dostatečně velké, že pravděpodobnost toho, že přijatý bod bj, vycházející za hranice mé koule, bude tak malá, jak si přejete.
Nyní se podívejme na tuto situaci z vaší strany (obr. 13.III). Na přijímací straně existuje koule S(r) se stejným poloměrem r kolem přijatého bodu bj v n-rozměrném prostoru, tak že pokud je přijatá zpráva bj uvnitř mé koule, pak odeslaná zpráva ai je uvnitř vaší koule.
Jak může vzniknout chyba? Chyba může nastat v případech popsaných v následující tabulce:
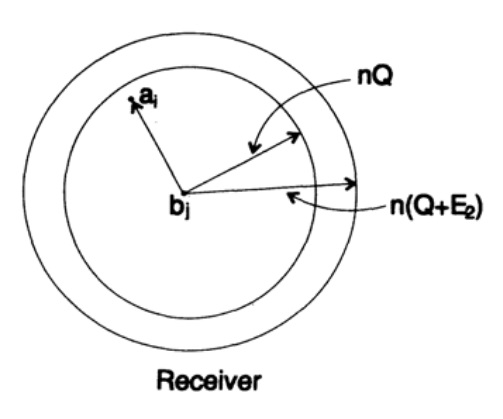
Obrázek 13.III
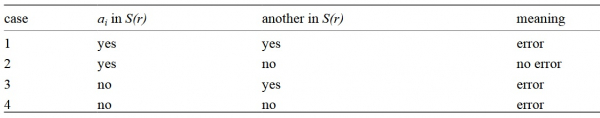
Zde vidíme, že pokud v kouli postavené kolem přijatého bodu existuje ještě alespoň jeden bod, odpovídající možné odeslané nezkódované zprávě, pak při přenosu došlo k chybě, protože nemůžete určit, která z těchto zpráv byla odeslána. Odeslaná zpráva neobsahuje chybu, pouze pokud bod, který jí odpovídá, leží v kouli, a neexistují další body, které by byly možné v daném kódu a které leží v téže kouli.
Máme matematickou rovnice pro pravděpodobnost chyby Re, pokud byla odeslána zpráva ai.
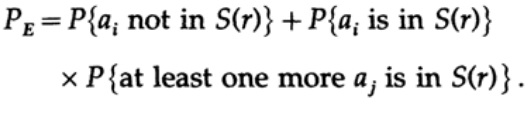
Můžeme vyhodit první faktor v druhém členu, přičemž jej vezmeme jako 1. Tím dostaneme nerovnost.
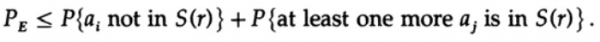
Je zřejmé, že
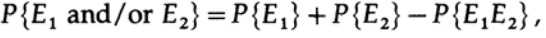
následně
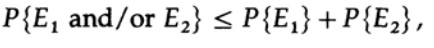
znovu aplikujeme na poslední člen vpravo.
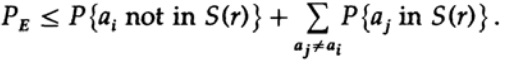
Předpokládáme, že n je dostatečně velké, první člen může být považován za libovolně malý, řekněme, menší než nějaké číslo d. Takže máme
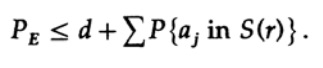
Nyní se podívejme, jak lze vytvořit jednoduchý substituční kód pro kódování M zpráv, které se skládají z n bitů. Bez představy o tom, jak přesně kód vytvářet (kódy pro opravu chyb ještě nebyly vynalezeny), Shannon zvolil náhodné kódování. Hoďte mincí pro každý z n bitů ve zprávě a opakujte proces pro M zpráv. Celkově je třeba provést nM hodů mincí, takže je možné

kódových slovníků, které mají stejnou pravděpodobnost ½nM. Samozřejmě, náhodný proces vytváření kódového slovníku znamená, že existuje pravděpodobnost vzniku duplicit, stejně jako kódových bodů, které budou blízko sebe a tudíž budou zdrojem pravděpodobných chyb. Je třeba prokázat, že pokud k tomu nedochází s pravděpodobností vyšší než jakákoliv libovolně zvolená malá hladina chyby, pak je zadané n dostatečně velké.
Rozhodující moment spočívá v tom, že Shannon z průměroval všechny možné kódové knihy, aby našel průměrnou chybu! Použijeme symbol Av [.], abychom označili průměrnou hodnotu ze všech možných náhodných kódových slovníků. Průměrování podle konstanty d samozřejmě dává konstantu, protože každý člen se shoduje s jakýmkoli jiným členem v součtu,
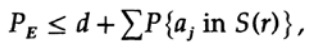
který může být zvýšen (M–1 se mění na M)
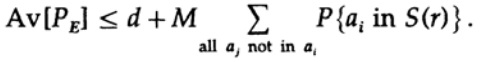
Pro jakoukoliv konkrétní zprávu, při průměrování všech kódových knih, kódování prochází všemi možnými hodnotami, takže průměrná pravděpodobnost, že bod se nachází v kouli, je poměr objemu koule k celkovému objemu prostoru. Objem koule přitom
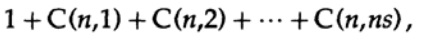
kde s=Q+e2 <1/2 a ns musí být celé číslo.
Poslední člen zprava je největší v tomto součtu. Nejdříve odhadneme jeho hodnotu pomocí Stirlingova vzorce pro faktoriály. Poté se podíváme na koeficient snižování předchozího členu, vezměte na vědomí, že tento koeficient se zvyšuje při pohybu doleva, a proto můžeme: (1) omezit hodnotu součtu součtem geometrické řady s tímto počátečním koeficientem, (2) rozšířit geometrickou řadu s ns členy na nekonečný počet členů, (3) spočítat součet nekonečné geometrické řady (standardní algebra, nic zásadního) a nakonec získat mezní hodnotu (pro dostatečně velké n):
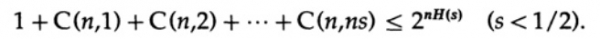
Všimněte si, jak entropie H(s) se objevila v binomickém identitě. Všimněte si, že Taylorova řada H(s)=H(Q+e2) dává odhad získaný pouze s ohledem na první derivaci a ignorování všech ostatních. Nyní sestavíme konečný výraz:
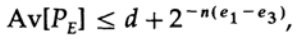
kde
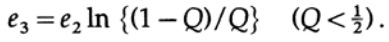
Všechno, co musíme udělat, je vybrat e2, tak aby e3 < e1, a pak bude poslední člen libovolně malý, při dostatečně velkém n. Proto může být průměrná chyba PE získána jakoukoli malou při šířce pásma kanálu libovolně blízkou C.
Pokud má průměrná hodnota všech kódů dostatečně malou chybu, pak by alespoň jeden kód měl být vhodný, a tedy existuje alespoň jeden vhodný kódovací systém. To je důležitý výsledek, který získal Shannon – "Shannonova věta pro kanál s rušením", ačkoliv je třeba poznamenat, že to prokázal pro mnohem obecnější případ než pro jednoduchý binární symetrický kanál, který jsem použil. Pro obecný případ jsou matematické úvahy mnohem složitější, ale myšlenky nejsou příliš rozdílné, takže velmi často lze pomocí příkladu speciálního případu odhalit skutečný smysl věty.
Pojďme zkritizovat výsledek. Opakovali jsme mnohokrát: „Při dostatečně velkých n“. Ale jak velké by mělo být n? Opravdu, opravdu velké, pokud skutečně chcete být zároveň blízko kapacitě kanálu a mít jistotu v correctně přenášených datech! Tak velké, že ve skutečnosti budete muset čekat velmi dlouho, abyste nashromáždili zprávu z takového množství bitů, abyste ji následně mohli zakódovat. Při tom bude velikost slovníku náhodného kódu prostě obrovská (vždyť takový slovník nelze představit v kratší formě než jako úplný seznam všech Mn bitů, přičemž n a M jsou velmi velké)!
Kódy pro opravu chyb se vyhýbají čekání na velmi dlouhou zprávu, s jejím následným kódováním a dekódováním přes velmi velké kódové knihy, protože se vyhýbají kódovým knihám jako takovým a místo toho používají běžné výpočty. V jednoduché teorii takové kódy obvykle ztrácejí schopnost přiblížit se k kapacitě kanálu a zároveň udržet dostatečně nízkou frekvenci chyb, avšak když kód opravuje velké množství chyb, vykazují dobré výsledky. Jinými slovy, pokud zakládáte určitou kapacitu kanálu pro opravu chyb, měli byste tuto možnost opravy chyb využívat většinu času, t. j. v každé odeslané zprávě by mělo být opraveno velké množství chyb, jinak tuto kapacitu zbytečně ztrácíte.
Dokázaná teorie uvedená výše však není bezvýznamná! Ukazuje, že efektivní systémy přenosu musí používat promyšlené kódovací schémata velmi dlouhých bitových řetězců. Příkladem jsou družice, které opustily vnější planety; jak se vzdalují od Země a Slunce, musí opravovat stále více a více chyb v bloku dat: některé družice používají solární panely, které poskytují přibližně 5 W, jiné používají atomové zdroje energie, které dávají přibližně stejný výkon. Slabý výkon zdroje napájení, malé velikosti vysílacích parabol a omezené velikosti přijímacích parabol na Zemi, ohromná vzdálenost, kterou musí signál překonat — to vše vyžaduje použití kódů s vysokou úrovní opravy chyb pro vybudování efektivního komunikačního systému.
Vraťme se k n-rozměrnému prostoru, který jsme použili při důkazu výše. Při jeho diskusi jsme ukázali, že téměř celý objem koule je soustředěn kolem vnějšího povrchu, — tak téměř jistě bude odeslaný signál umístěn na povrchu koule vybudované kolem přijatého signálu, i při relativně malém poloměru takové koule. Není proto překvapující, že přijatý signál po opravě libovolného množství chyb, nQ, se ukazuje jako libovolně blízký signálu bez chyb. Kapacita komunikačního kanálu, kterou jsme dříve zvažovali, je klíčem k porozumění tomuto jevu. Všimněte si, že podobné koule vybudované pro kódy Hamming s opravou chyb se nepřekrývají. Velké množství prakticky ortogonálních měření v n-rozměrném prostoru ukazuje, proč můžeme umístit M koulí do prostoru s malým překrytím. Pokud připustíme malé, jakékoli malé překrytí, které může vést pouze k malému počtu chyb při dekódování, můžeme dosáhnout hustého umístění koulí v prostoru. Hamming zaručil určitou úroveň opravy chyb, Shannon — nízkou pravděpodobnost chyby, ale přitom zachování skutečné přenosové kapacity jakékoli blízké kapacitě komunikačního kanálu, což kódy Hamming nedokáží.
Teorie informace neříká, jak navrhnout efektivní systém, ale ukazuje směr k efektivním komunikačním systémům. Je to cenný nástroj pro vytváření komunikačních systémů mezi stroji, ale jak bylo zmíněno dříve, nemá to mnoho společného s tím, jak si lidé mezi sebou vyměňují informace. Míra, do jaké je biologické dědictví podobné technickým komunikačním systémům, je prostě neznámá, a proto není v současnosti jasné, jak moc je teorie informace použitelná na geny. Nemáme na výběr, než to prostě zkusit, a pokud nám úspěch ukáže strojově podobnou povahu tohoto jevu, pak neúspěch naznačí jiné podstatné aspekty povahy informace.
Pojďme se na chvíli odvrátit. Viděli jsme, že všechna původní definice, více či méně, musí vyjadřovat podstatu našich základních přesvědčení, ale mají určitou míru zkreslení, a proto se ukazují jako neaplikovatelné. Tradičně se předpokládá, že nakonec definice, kterou používáme, skutečně určuje podstatu; ale to nám pouze ukazuje, jak věci zpracovávat, a nijak nám to nenesí žádný smysl. Poziční přístup, který je tak velmi schvalován v matematických kruzích, zanechává v praxi co do činění.
Nyní se podíváme na příklad IQ testů, kde je definice cyklická, jak jen chcete, a v důsledku toho vás zmátne. Vytvoří se test, který by měl měřit inteligenci. Poté je přezkoumán, aby byl co nejvíce konzistentní, a poté je publikován a kalibrován jednoduchou metodou tak, aby měřená "inteligence" byla normálně rozložena (samozřejmě podle kalibrační křivky). Všechna definice by měla být znovu zkontrolována, nejen když jsou poprvé navržena, ale také mnohem později, když jsou používána ve vyvozených závěrech. Do jaké míry jsou hranice definic vhodné pro vyřešený úkol? Jak často se definice uvedené v jednom kontextu začnou aplikovat v dost odlišných podmínkách? To se stává často! V humanitních vědách, se kterými se nevyhnutelně v životě setkáte, se to děje častěji.
Cílem této prezentace teorie informace, kromě představení její užitečnosti, bylo varovat vás před tímto nebezpečím nebo ukázat, jak ji použít k dosažení požadovaného výsledku. Dávno bylo poznamenáno, že počáteční definice ovlivňují, co nakonec najdete, mnohem více, než se zdá. Počáteční definice vyžadují vaši velkou pozornost nejen v jakékoli nové situaci, ale také v oblastech, se kterými již dlouho pracujete. To vám umožní pochopit, do jaké míry jsou získané výsledky tautologií, a ne něčím užitečným.
Známý příběh o Eddingtonovi vypráví o lidech, kteří lovili ryby v moři pomocí sítě. Zkoumáním velikosti ryb, které ulovili, určili minimální velikost ryby, která se v moři vyskytuje! Jejich závěr byl podmíněn použitým nástrojem, nikoli realitou.
Pokračování příště…
Kdo chce pomoci s překladem, sazbou a vydáním knihy — pište do soukromé zprávy nebo na e-mail magisterludi2016@yandex.ru
Mimochodem, spustili jsme také překlad další skvělé knihy — )
Obzvlášť hledáme ty, kdo pomůže přeložit . (překládáme po 10 minutách, prvních 20 už vzali)
Obsah knihy a přeložené kapitoly
- Úvod do umění vědeckého a inženýrského myšlení: Učení se učit (28. března 1995)
- „Základy digitální (diskrétní) revoluce“ (30. března 1995)
- „Historie počítačů — Hardware“ (31. března 1995)
- „Historie počítačů — Software“ (4. dubna 1995)
- „Historie počítačů — Aplikace“ (6. dubna 1995)
- „Umělá inteligence — Část I“ (7. dubna 1995)
- „Umělá inteligence — Část II“ (11. dubna 1995)
- „Umělá inteligence III“ (13. dubna 1995)
- „N-Dimenzionální prostor“ (14. dubna 1995)
- „Teorie kódování — Představování informací, Část I“ (18. dubna 1995)
- „Teorie kódování — Představování informací, Část II“ (20. dubna 1995)
- „Kódy pro opravu chyb“ (21. dubna 1995)
- „Teorie informace“ (25. dubna 1995)
- „Digitální filtry, část I“ (27. dubna 1995)
- „Digitální filtry, část II“ (28. dubna 1995)
- „Digitální filtry, část III“ (2. května 1995)
- „Digitální filtry, část IV“ (4. května 1995)
- „Simulace, část I“ (5. května 1995)
- „Simulace, část II“ (9. května 1995)
- „Simulace, část III“ (11. května 1995)
- „Optická vlákna“ (12. května 1995)
- „Počítačem podporované vzdělávání“ (16. května 1995)
- „Matematika“ (18. května 1995)
- „Kvantová mechanika“ (19. května 1995)
- „Kreativita“ (23. května 1995). Překlad:
- „Odborníci“ (25. května 1995)
- „Nespolehlivá data“ (26. května 1995)
- „Systémové inženýrství“ (30. května 1995)
- „Dostáváte to, co měříte“ (1. června 1995)
- (2. června 1995) překládáme po 10 minutových úsecích
- Hamming, „Vy a vaše výzkum“ (6. června 1995).
Kdo chce pomoci s překladem, sazbou a vydáním knihy — pište do soukromé zprávy nebo na e-mail magisterludi2016@yandex.ru
Zdroj: habr.com
