

V tomto článku probereme funkční závislosti v databázích – co to je, kde se používají a jaké existují algoritmy pro jejich vyhledávání.
Funkční závislosti budeme zvažovat v kontextu relačních databází. Jestliže to řekneme velmi zjednodušeně, v takových databázích jsou informace ukládány ve formě tabulek. Dále budeme používat přibližné pojmy, které ve striktní relační teorii nejsou vzájemně zaměnitelné: samotnou tabulku budeme nazývat vztahem, sloupce – atributy (jejich množina – schématem vztahu), a soubor hodnot řádku na podmnožině atributů – k-tichem.
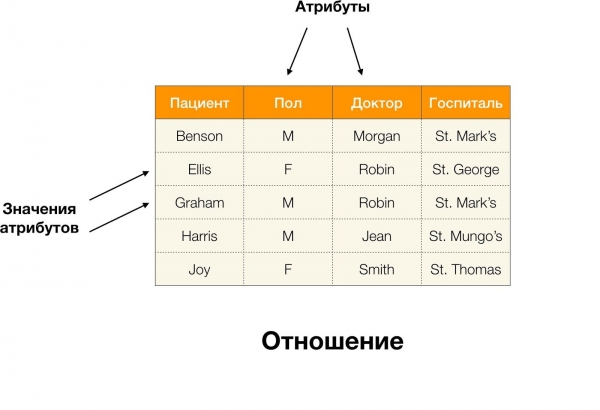
Například, v tabulce výše, (Benson, M, M organ) je k-tice podle atributů (Pacient, Pohlaví, Doktor).
Formálně se to zapisuje následujícím způsobem:  [Pacient, Pohlaví, Doktor] = (Benson, M, M organ).
Nyní můžeme zavést pojem funkční závislosti (FZ):
Definice 1. Vztah R splňuje FZ X → Y (kde X, Y ⊆ R) tehdy a jen tehdy, když pro jakékoli k-tice  ,
 ∈ R platí: pokud
 [X] =
 [X], pak
 [Y ] =
 [Y ]. V takovém případě se říká, že X (determinant neboli určující množina atributů) funkčně určuje Y (závislé množství).
Jinými slovy, existence FZ X → Y znamená, že pokud máme dvě k-tice v R a shodují se podle atributů X, pak se budou shodovat i podle atributů Y.
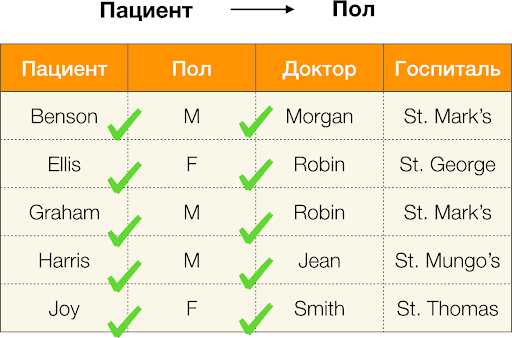
A nyní postupně. Zvažme atributy Pacient a Pohlaví pro které chceme zjistit, zda mezi nimi existují závislosti nebo ne. Pro takovou množinu atributů mohou existovat následující závislosti:
- Pacient → Pohlaví
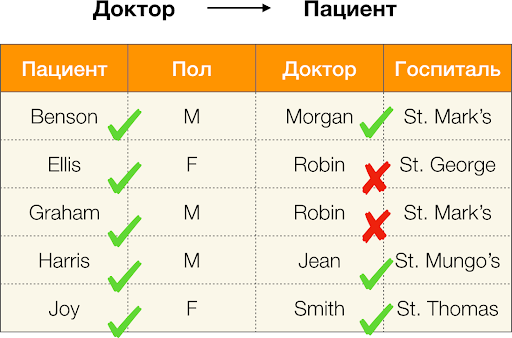
- Pohlaví → Pacient
Podle výše uvedené definice, aby byla prvá závislost zachována, každé unikátní hodnotě sloupce Pacient musí odpovídat pouze jedna hodnota sloupce Pohlaví. A pro tabulku-příklad to tak skutečně je. Nicméně v opačném směru to nefunguje, tedy druhá závislost není splněna, a atribut Pohlaví není determinantem pro Pacienta. Analogicky, pokud vezmeme závislost Doktor → Pacient, můžeme si povšimnout, že je porušena, protože hodnota Robin pod tímto atributem má několik různých hodnot – Ellis a Graham.
Takže funkční závislosti umožňují určit existující vazby mezi množinami atributů tabulky. Odtud budeme i nadále zvažovat nejzajímavější vazby, a to konkrétně takové X → Y, že jsou:
- netriviální, což znamená, že pravá část závislosti není podmnožinou levé (Y ̸⊆ X);
- minimální, což znamená, že neexistuje taková závislost Z → Y, že Z ⊂ X.
Zvažované dosud závislosti byly přísné, tedy neumožňující žádné narušení tabulky, ale kromě nich existují i takové, které připouštějí určitou nesouladnost mezi hodnotami tupelů. Tyto závislosti se přesouvají do samostatné třídy, nazývají se přibližné a umožňují jejich porušení v určitém počtu tupelů. Toto množství se reguluje ukazatelem maximální chyby emax. Například podíl chyby  = 0.01 může znamenat, že závislost může být porušena na 1 % z existujících tupelů na zvažované množině atributů. To znamená, že pro 1000 záznamů může maximálně 10 tupelů porušit FZ. My se však budeme zabývat poněkud jinou metrikou, založenou na párně odlišných hodnotách porovnávaných tupelů. Pro závislost X → Y na relaci jsou rovny nule. se to počítá takto:

Vypočtěme chybu pro Doktor → Pacient z výše uvedeného příkladu. Máme dva tupely, jejichž hodnoty se liší na atributu Pacient, ale shodují se na Doktorovi:  [Doktor, Pacient] = (Robin, Ellis) a
 [Doktor, Pacient] = (Robin, Graham). Podle definice chyby musíme zohlednit všechny konfliktní páry, a to znamená, že těchto bude dvě: (
 ,
 ) a její inverze (
 ,
 ). Dosadíme do vzorce a získáme:

A nyní se pokusíme odpovědět na otázku: „A k čemu to vše?“ Ve skutečnosti existují různé FZ. První typ — to jsou takové závislosti, které jsou stanoveny administrátorem v průběhu návrhu databáze. Obvykle jich je málo, jsou přísné a jejich hlavní použití — normalizace dat a design schématu relace.
Druhý typ — závislosti, které představují "skryté" údaje a dříve neznámé vazby mezi atributy. To znamená, že o těchto závislostech se nepřemýšlelo v době návrhu a nacházejí se až pro stávající sadu dat, aby na základě mnoha identifikovaných funkčních závislostí bylo možné učinit určité závěry o uchovávaných informacích. Právě s těmito závislostmi pracujeme. Těmito otázkami se zabývá celá oblast datového dolování s různými vyhledávacími technikami a na jejich základě vyvinutými algoritmy. Pojďme se podívat, jak mohou být nalezené funkční závislosti (přesné nebo přibližné) užitečné v určitých datech.
Dnes se mezi hlavními oblastmi použití závislostí vyčleňují čištění dat. To zahrnuje vývoj procesů pro identifikaci "špinavých dat" s následnou opravou. Jasnými příklady "špinavých dat" jsou duplicity, chyby v datech nebo překlepy, chybějící hodnoty, zastaralá data, nadbytečné mezery a podobně.
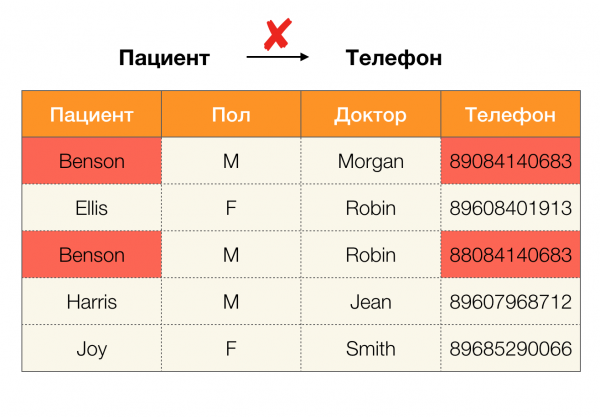
Příklad chyby v datech:
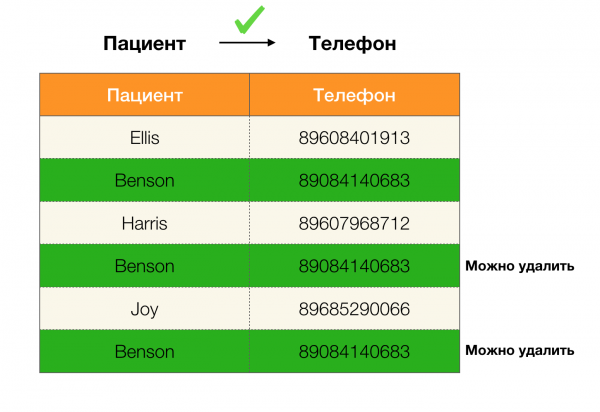
Příklad duplicit v datech:
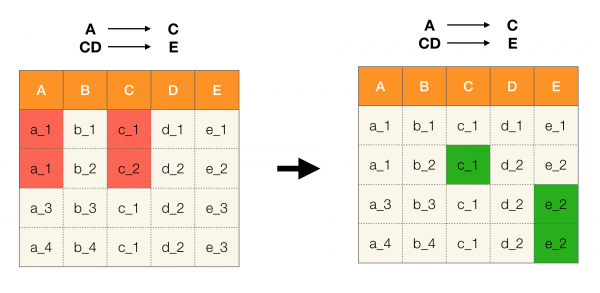
Například máme tabulku a soubor funkčních závislostí, které by měly být dodržovány. Čištění dat v tomto případě znamená změnit data tak, aby funkční závislosti byly správné. Při tom by měl být počet modifikací minimální (pro tuto proceduru existují vlastní algoritmy, na které se v tomto článku nebudeme zaměřovat). Níže je uveden příklad takové transformace dat. Vlevo je původní vztah, ve kterém zjevně nejsou dodržovány požadované funkční závislosti (červenou barvou je zvýrazněn příklad porušení jedné z funkčních závislostí). Vpravo je uveden aktualizovaný vztah, ve kterém zelené buňky ukazují změněné hodnoty. Po provedení takové procedury se potřebné závislosti začaly dodržovat.
Další populární oblastí využití je návrh databázového systému. Je zde dobré připomenout normální formy a normalizaci. Normalizace je proces, při kterém se vztah přizpůsobuje určitým standardům, z nichž každý je svým způsobem definován normální formou. Nebudeme se podrobně zabývat požadavky různých normálních forem (to se probírá v každé knize o databázových kurzech pro začátečníky), pouze si všimneme, že každá z nich používá koncept funkčních závislostí svým způsobem. Funkční závislosti jsou v podstatě omezení integrity, která se berou v úvahu při návrhu databáze (v tomto kontextu se funkční závislosti někdy nazývají superklíči).
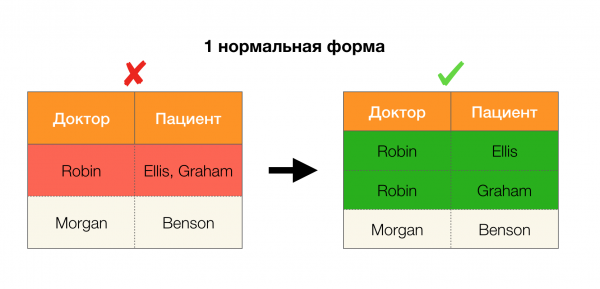
Zvažme jejich aplikaci pro čtyři normální formy na obrázku níže. Připomeňme, že Boyce-Coddova normální forma je přísnější než třetí forma, ale zároveň je méně přísná než čtvrtá. Poslední formu prozatím neřešíme, protože k jejímu uplatnění je zapotřebí chápat víceznakové závislosti, které nás v tomto článku nezajímají.
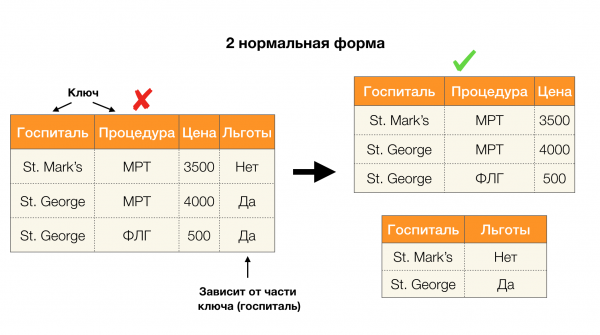
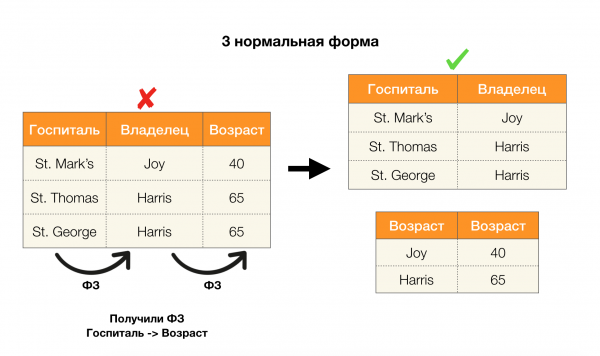
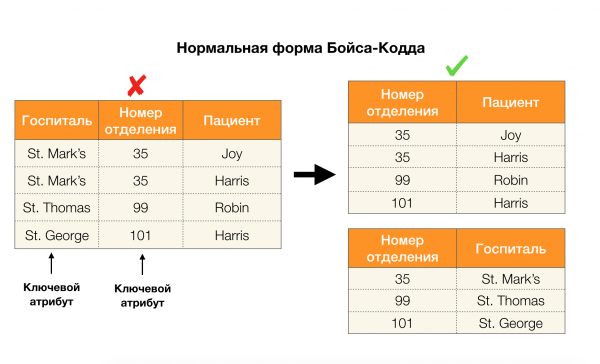
Další oblastí, kde našly závislosti své uplatnění, je snížení dimenze prostoru charakteristik v úlohách, jako je konstrukce naivního bayesovského klasifikátoru, extrakce významných charakteristik a reparametrizace regresního modelu. V originálních článcích se tato úloha nazývá určení nadbytečných charakteristik (feature redundancy) a relevantních (feature relevancy) [5, 6], a je řešena aktivním využitím konceptů databází. S příchodem takových prací můžeme říci, že dnes existuje poptávka po řešeních, která umožňují zkombinovat databázi, analýzu a realizaci výše zmíněných optimalizačních problémů do jednoho nástroje [7, 8, 9].
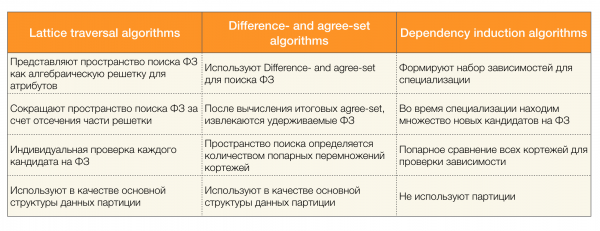
Pro hledání funkčních závislostí v datovém souboru existuje mnoho algoritmů (jak moderních, tak i méně moderních). Tyto algoritmy lze rozdělit do tří skupin:
- Algoritmy používající procházení algebraických mřížek (Lattice traversal algorithms)
- Algoritmy založené na hledání shodných hodnot (Difference- and agree-set algorithms)
- Algoritmy založené na párových srovnáních (Dependency induction algorithms)
Krátký popis každého typu algoritmu je uveden v tabulce níže:
Více o této klasifikaci si můžete přečíst [4]. Níže jsou uvedeny příklady algoritmů pro každý typ:
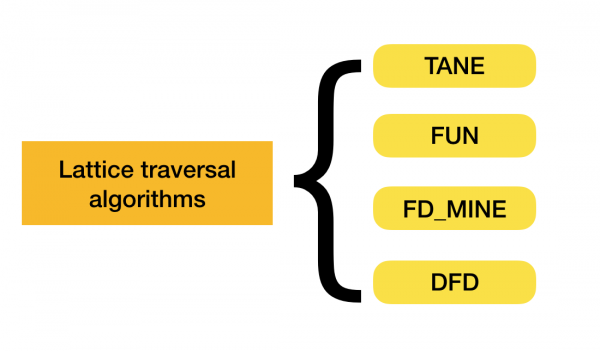
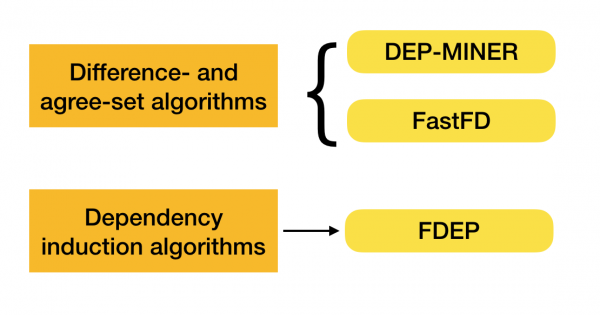
V současnosti se objevují nové algoritmy, které kombinují několik přístupů k hledání funkčních závislostí. Příklady těchto algoritmů zahrnují Pyro [2] a HyFD [3]. Analýza jejich fungování bude předmětem následujících článků této série. V tomto článku se zaměříme pouze na základní pojmy a lemma, která jsou potřebná pro pochopení technik identifikace závislostí.
Začněme jednoduše — difference-set a agree-set, používané ve druhém typu algoritmů. Difference-set představuje množinu uspořádaných dvojic, které se neshodují podle hodnot, zatímco agree-set naopak — uspořádané dvojice, které se shodují podle hodnot. Je třeba poznamenat, že v tomto případě zvažujeme pouze levou část závislosti.
Také důležitým pojmem, které se objevilo výše, je algebrická mřížka. Jelikož mnohé moderní algoritmy pracují s tímto pojmem, je potřebné mít představu o tom, co to je.
Abychom zavedli pojem mřížky, potřebujeme definici částečně uspořádané množiny (nebo partially ordered set, zkráceně — poset).
Definice 2. Říká se, že množina S je částečně uspořádána binárním vztahem ⩽, pokud pro všechna a, b, c ∈ S platí vlastnosti:
- Reflexivnost, tedy a ⩽ a
- Antisymetričnost, to znamená, že pokud a ⩽ b a b ⩽ a, pak a = b
- Tranzitivita, tedy pro a ⩽ b a b ⩽ c platí, že a ⩽ c
Takový vztah se nazývá vztahem (nepřísného) částečného pořádku, a samo množství — částečně uspořádanou množinou. Formální označení: ⟨S, ⩽⟩.
Jako nejjednodušší příklad částečně uspořádané množiny můžeme vzít množinu všech přirozených čísel N s obvyklým vztahem pořádku ⩽. Není těžké ověřit, že všechny potřebné axiomy platí.
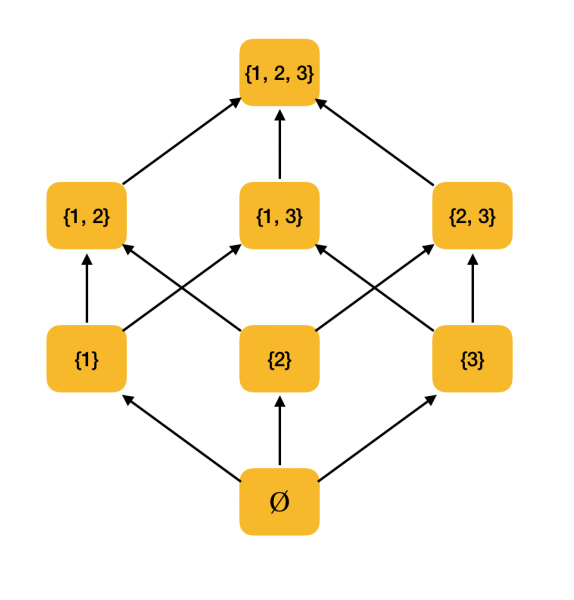
Obsáhlejší příklad. Zvažme množinu všech podmnožin {1, 2, 3}, uspořádanou vztahem zanoření ⊆. Opravdu, tento vztah splňuje všechny podmínky částečného pořádku, proto ⟨P ({1, 2, 3}), ⊆⟩ — částečně uspořádaná množina. Na obrázku níže je znázorněna struktura této množiny: pokud lze z jednoho prvku dojít pomocí šipek k druhému prvku, pak jsou v vztahu pořádku.
Budeme potřebovat ještě dvě jednoduché definice z oblasti matematiky — supremum (supremum) a infimum (infimum).
Definice 3. Nechť ⟨S, ⩽⟩ — částečně uspořádaná množina, A ⊆ S. Horní mez A je takový prvek u ∈ S, že ∀x ∈ S: x ⩽ u. Nechť U — množina všech horních mezí S. Pokud v U existuje nejmenší prvek, pak se nazývá supremum a označuje se jako sup A.
Analogicky se zavádí pojem přesné dolní meze.
Definice 4. Nechť ⟨S, ⩽⟩ — částečně uspořádaná množina, A ⊆ S. Dolní mez A je takový prvek l ∈ S, že ∀x ∈ S: l ⩽ x. Nechť L — množina všech dolních mezí S. Pokud v L existuje největší prvek, pak se nazývá infimum a označuje se jako inf A.
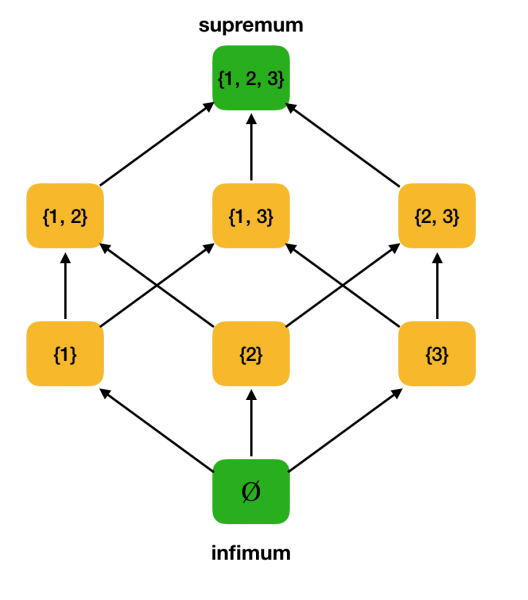
Zvažme jako příklad výše uvedenou částečně uspořádanou množinu ⟨P ({1, 2, 3}), ⊆⟩ a najděme v ní supremum a infimum:
Nyní můžeme formulovat definici algebraické mřížky.
Definice 5. Nechť ⟨P, ⩽⟩ — částečně uspořádaná množina, taková že každá dvouprvková podmnožina má přesné horní a dolní meze. Pak se P nazývá algebraická mřížka. Přičemž sup{x, y} zapisují jako x ∨ y, a inf {x, y} — jako x ∧ y.
Ověříme, že náš pracovní příklad ⟨P ({1, 2, 3}), ⊆⟩ je mřížka. Opravu, pro každé a, b ∈ P ({1, 2, 3}), a∨b = a∪b, a a∧b = a∩b. Například zvažme množiny {1, 2} a {1, 3} a najděme jejich infimum a supremum. Když je překryjeme, dostaneme množinu {1}, která bude infimum. Supremum získáme jejich sjednocením — {1, 2, 3}.
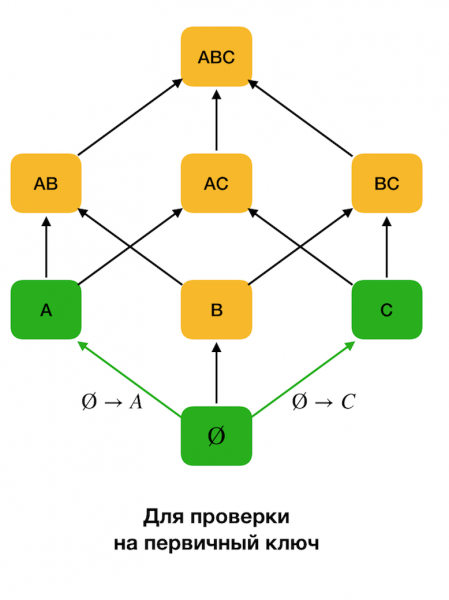
V algoritmech pro odhalování FZ je prostor hledání často reprezentován ve formě mřížky, kde množiny s jedním prvkem (čti první úroveň mřížky hledání, kde levá část závislostí se skládá z jednoho atributu) představují každý atribut původní relace.
Na začátku se zvažují závislosti typu ∅ → Jednoduchý atribut. Tento krok umožňuje určit, které atributy jsou primárními klíči (pro takové atributy neexistují determinanty, a proto je levá část prázdná). Dále se takové algoritmy posouvají po mřížce nahoru. Je třeba poznamenat, že mřížku lze procházet ne celou, tedy pokud se na vstup předá požadovaná maximální velikost levé části, algoritmus dál s tímto velikostí už postupovat nebude.
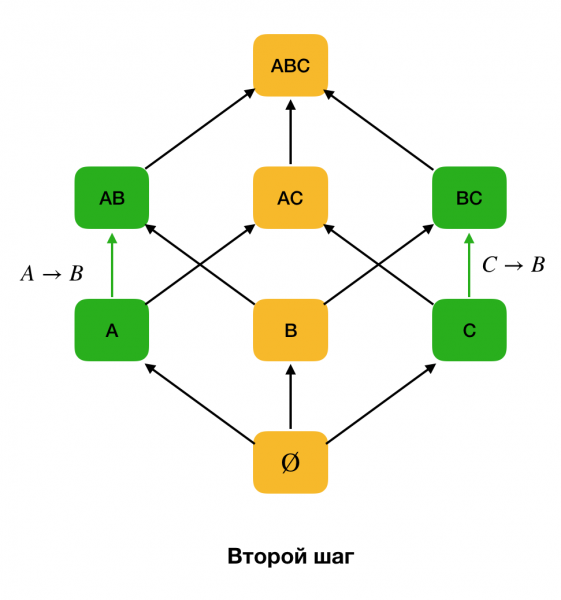
Na obrázku níže je ukázáno, jak lze použít algebraickou mřížku v úloze hledání FZ. Zde každé hrana (X, XY) představuje závislost X → Y. Například jsme prošli první úroveň a víme, že se udržuje závislost A → B (zobrazíme to zeleným spojením mezi vrcholy A a B). To znamená, že když budeme pokračovat mřížkou nahoru, nemusíme kontrolovat závislost A, C → B, protože ta už nebude minimální. Podobně bychom ji nekontrolovali, kdyby se udržovala závislost C → B.
Kromě toho většina moderních algoritmů pro hledání FZ používá strukturu dat zvanou partition (v původním textu - stripped partition [1]). Formální definice partition vypadá následovně:
Definice 6. Nechť X ⊆ R je množina atributů pro relaci r. Kluster představuje množinu indexů tuplí z r, které mají stejnou hodnotu pro X, tj. c(t) = {i|ti[X] = t[X]}. Partition představuje množinu klusterů, vylučující klustry jednotkové délky:

Jednoduše řečeno, partition pro atribut X představuje množinu seznamů, kde každý seznam obsahuje čísla řádků se stejnými hodnotami pro X. V moderní literatuře je struktura, která reprezentuje partition, nazývána position list index (PLI). Klustry jednotkové délky jsou vylučovány za účelem komprese PLI, protože to jsou klustry, které obsahují pouze číslo záznamu s unikátní hodnotou, kterou bude vždy snadné určit.
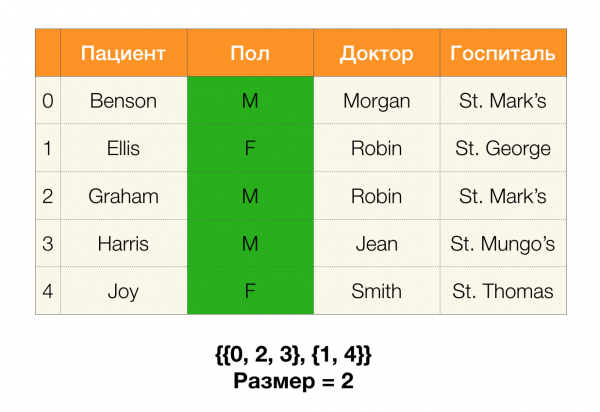
Zvažme příklad. Vraťme se k té samé tabulce s pacienty a vytvořme partition pro sloupce Pacient a Pohlaví (na levé straně se objevil nový sloupec, v němž jsou označena čísla řádků tabulky):
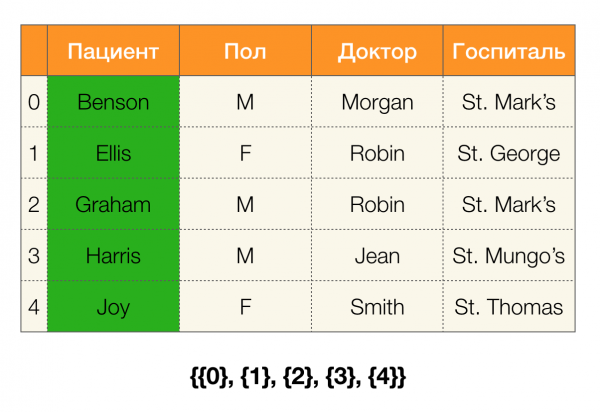
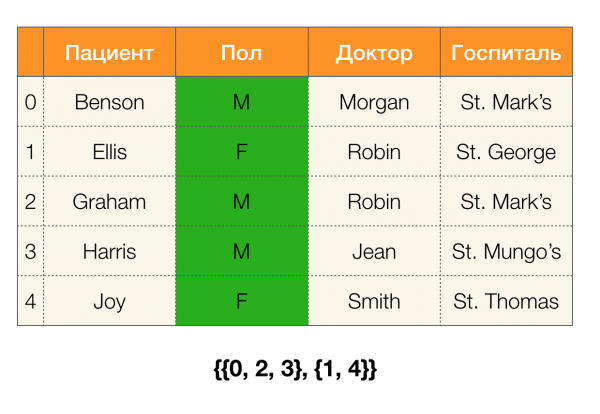
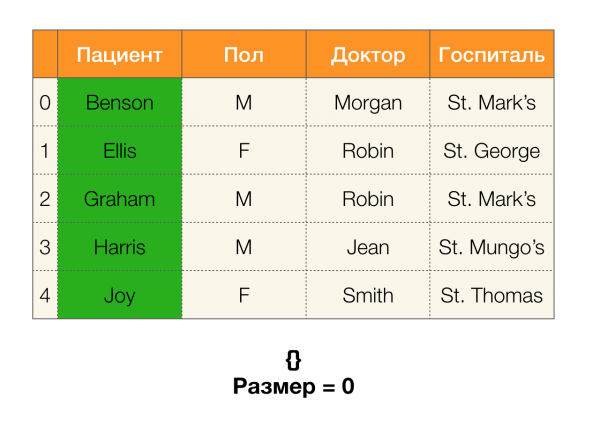
Přitom, podle definice, partition pro sloupec Pacient ve skutečnosti bude prázdná, protože jednotlivé klustry jsou vylučovány z partition.
Partition lze získat podle několika atributů. A pro to existují dvě cesty: projít tabulkou a vytvořit partition najednou podle všech potřebných atributů, nebo ji vytvořit pomocí operace průniku partition podle podmnožiny atributů. Algoritmy hledání FZ používají druhou variantu.
Jednoduše řečeno, aby například získali partition podle sloupců ABC, lze vzít partition pro AC a B (nebo jakákoli jiná sada nepřekrývajících se podmnožin) a provést jejich průnik. Operace průniku dvou partition vyčleňuje nejdelší shluky, které jsou společné pro obě partition.
Podívejme se na příklad:
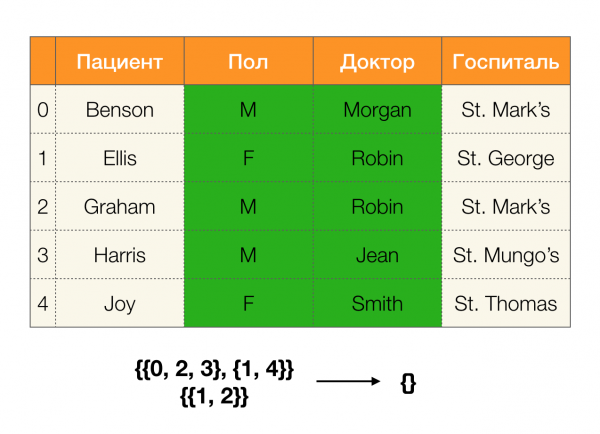
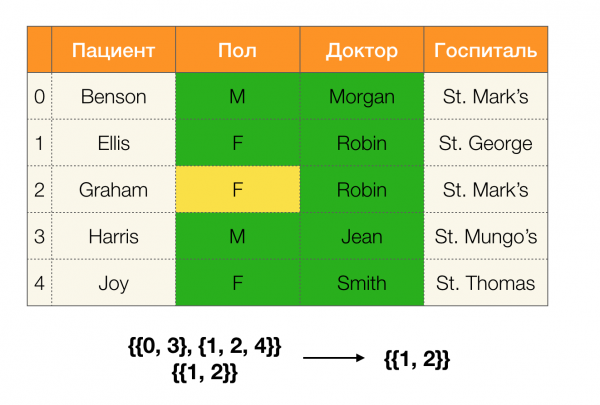
V prvním případě jsme obdrželi prázdnou partition. Pokud se podíváme na tabulku, skutečně tam nejsou žádné shodné hodnoty podle dvou atributů. Pokud však tabulku mírně upravíme (příklad vpravo), obdržíme již neprázdný průnik. Řádky 1 a 2 skutečně obsahují shodné hodnoty podle atributů Pohlaví a Doktor.
Dále budeme potřebovat takový koncept, jako je velikost partition. Formálně:

Jednoduše řečeno, velikost partition představuje počet shluků, které vstupují do partition (pamatujme, že jednotlivé shluky do partition nepatří!):
Nyní můžeme definovat jednu z klíčových lem, která pro dané partition umožňuje určit, zda je závislost udržována či nikoli:
Lemma 1. Závislost A, B → C je udržována, pokud a pouze pokud

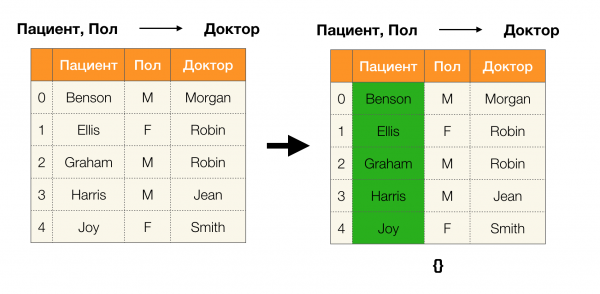
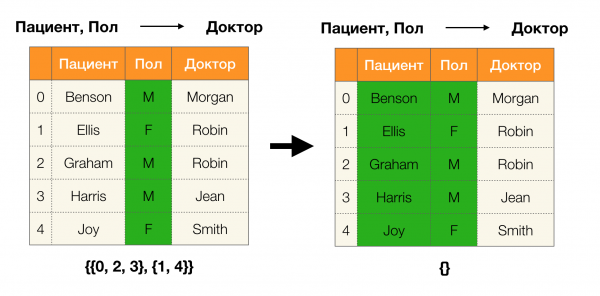
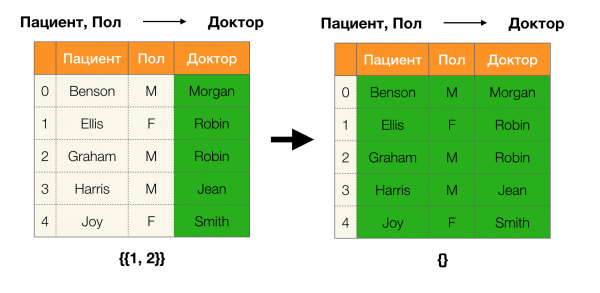
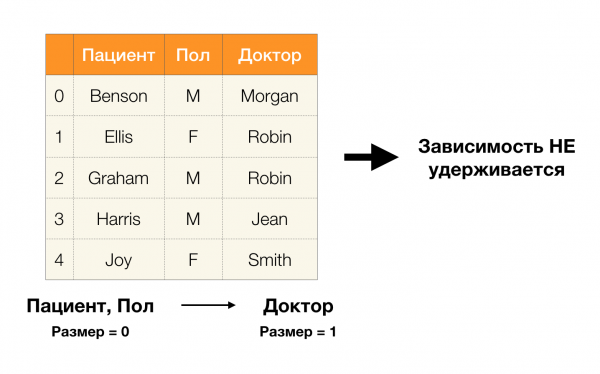
Podle lemmy, pro určení, zda je závislost udržována, je třeba provést čtyři kroky:
- Vypočítat partition pro levou část závislosti
- Vypočítat partition pro pravou část závislosti
- Vypočítat součin prvního a druhého kroku
- Porovnat velikosti partition získaných v prvním a třetím kroku
Níže je uveden příklad kontroly, zda je závislost udržována podle této lemmy:
V tomto článku jsme probrali takové koncepty, jako je funkční závislost, přibližná funkční závislost, prozkoumali, kde se používají, a jaké algoritmy pro vyhledávání FZ existují. Také jsme podrobně probrali základní, ale důležité pojmy, které jsou aktivně používány v moderních algoritmech pro vyhledávání FZ.
Odkazy na literaturu:
- Huhtala Y. a kol. TANE: Efektivní algoritmus pro objevování funkčních a přibližných závislostí //The computer journal. – 1999. – Sv. 42. – č. 2. – s. 100-111.
- Kruse S., Naumann F. Efektivní objevování přibližných závislostí //Proceedings of the VLDB Endowment. – 2018. – Sv. 11. – č. 7. – s. 759-772.
- Papenbrock T., Naumann F. Hybridní přístup k objevování funkčních závislostí //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – s. 821-833.
- Papenbrock T. a kol. Objevování funkční závislosti: Experimentální hodnocení sedmi algoritmů //Proceedings of the VLDB Endowment. – 2015. – Sv. 8. – č. 10. – s. 1082-1093.
- Kumar A. a kol. Slučit nebo nezlučovat?: Dvakrát se zamyslet nad sloučením před výběrem funkcí //Proceedings of the 2016 International Conference on Management of Data. – ACM, 2016. – s. 19-34.
- Abo Khamis M. et al. Učení v databázích s řídkými tenzory // Sborník 37. sympozia ACM SIGMOD-SIGACT-SIGAI o principech databázových systémů. – ACM, 2018. – S. 325-340.
- Hellerstein J. M. et al. Analytická knihovna MADlib: neboli MAD dovednosti, SQL // Sborník nadace VLDB. – 2012. – T. 5. – č. 12. – S. 1700-1711.
- Qin C., Rusu F. Spekulativní aproximace pro teraskalní optimalizaci gradientního sestupu // Sborník čtvrté dílny o analýze dat v cloudu. – ACM, 2015. – S. 1.
- Meng X. et al. Mllib: Strojové učení v Apache Spark // Journal of Machine Learning Research. – 2016. – T. 17. – č. 1. – S. 1235-1241.
Autoři článku: , výzkumnice v , a , výzkumnice v
Zdroj: habr.com
