

Bylo zveřejněno vydání databázového systému Redis 8.4, který patří do třídy NoSQL systémů. Redis poskytuje funkce pro ukládání dat ve formátu klíč/hodnota, rozšířené podporou strukturovaných datových formátů, jako jsou seznamy, hash a množiny, a také možností provádění skriptů na straně serveru napsaných v jazyce Lua. Kód projektu je napsán v jazyce C a šíří se pod licencí AGPLv3.
Databázový systém Redis podporuje transakce, které umožňují provést skupinu příkazů najednou, zaručující konzistentnost a pořadí (příkazy z jiných požadavků se nemohou vmísit) provádění daného souboru příkazů, a v případě problémů umožňují vrátit změny zpět. Všechna data se plně ukládají do operační paměti. Klientské knihovny jsou k dispozici pro většinu populárních jazyků, včetně Perlu, Pythonu, PHP, Javy, Ruby a Tcl.
Pro správu dat se poskytují příkazy jako inkrementace/dekrementace, standardní operace nad seznamy a množinami (sjednocení, průnik), přejmenování klíčů, vícenásobné výběry a funkce pro řazení. Podporovány jsou dva režimy ukládání: periodická synchronizace dat na disk a vedení logu změn na disku. V druhém případě je zaručena úplná ochrana všech změn. Je možné organizovat replikaci dat v režimu master-slave na několik servery, prováděnou bez blokování. K dispozici je také režim výměny zpráv „publikace/předplatné“, při kterém se vytváří kanál, ze kterého jsou zprávy šířeny předplatitelům.
Hlavní změny v Redis 8.4:
- Byl přidán příkaz „FT.HYBRID“ s implementací hybridního vyhledávání, které kombinuje v jednom dotazu možnosti fulltextového a vektorového vyhledávání, přičemž zohledňuje jak přímé shody, tak blízkost podle významu. Podporovány jsou možnosti agregace výsledků se syntaxí jako u příkazu „FT.AGGREGATE“.
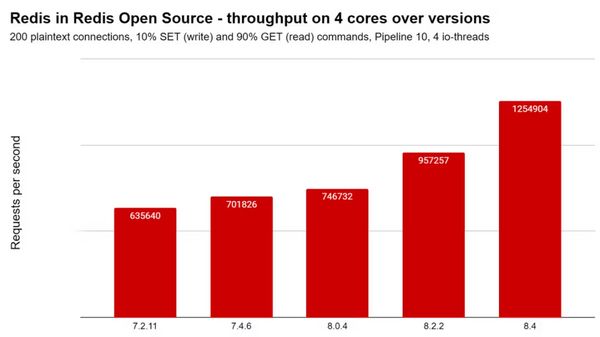
- Byla zvýšena propustnost v typických aplikacích Redis pro cache. Například při zatížení obsahujícím 10 % zápisových operací (SET) a 90 % čtecích operací (GET) a ukládání řetězcových hodnot o velikosti 1 kB vzrostla propustnost o 30 %.

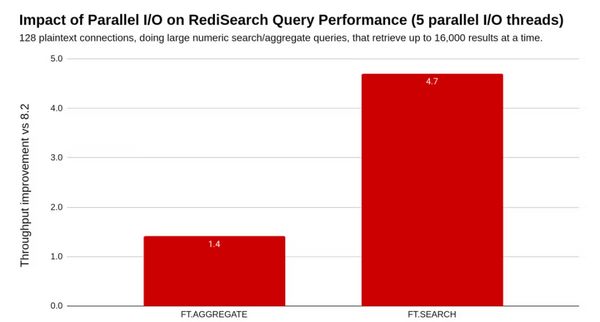
- Byla zvýšena výkonnost vyhledávacích operací (FT.SEARCH) a agregace výsledků (FT.AGGREGATE). V zatížených systémech s velkým počtem paralelních dotazů byl zaznamenán nárůst propustnosti a snížení latence až o 4,7krát při vyhledávání a až o 1,4krát při agregaci výsledků.

- Byla provedena optimalizace alokace paměti při provádění dotazů a byla zajištěna možnost nastavení chování při vyčerpání dostupné paměti (OOM, out-of-memory).
- Byla snížena spotřeba paměti při ukládání malých řetězců (až 7 bytů) ve strukturách typu JSON. Například pole v JSON, obsahující 500 malých prvků ve formátu klíč/hodnota, nyní zabírá o 37 % méně paměti.
- Byla zvýšena účinnost ukládání číselných polí JSON, kde mají všechny prvky jeden typ (pokud dříve byl pro každý prvek v takovém poli uložen typ a hodnota, nyní je typ uložen pouze jednou pro celé pole). V provedeném testu si taková pole s milionem homogenních prvků nyní vyžadují o 50-92 % méně paměti v závislosti na typu.
- Do příkazu SET byly přidány možnosti IFEQ, IFNE, IFDEQ a IFDNE, které umožňují provést aktualizaci řetězcového klíče pomocí jediného příkazu v situacích, kdy se jeho přidružená hodnota od doby jejího vytažení nezměnila jiným klientem.
- Byl přidán příkaz XDELEX pro atomické odstranění řetězcového klíče, pokud se jeho přidružená hodnota od doby vytažení nezměnila.
- Byl přidán příkaz DIGEST, který vrací hash hodnoty přidružené ke zvolenému klíči.
- Do příkazu XREADGROUP byla přidána možnost „CLAIM “ pro čtení jak čekajících (idle pending), tak příchozích (incoming) zpráv.
- Byl přidán příkaz MSETEX pro atomické nastavení nebo aktualizaci více řetězcových klíčů najednou, stejně jako pro aktualizaci jejich doby životnosti.
- Byl přidán mechanismus atomární migrace slotů mezi uzly clustera (ASM — Atomic Slot Migration), který připomíná úplnou synchronní replikaci, ale funguje na úrovni jednotlivých datových slotů. Byl přidán příkaz CLUSTER MIGRATION, pomocí kterého lze importovat sloty z jiných uzlů, sledovat pokrok migrace a v případě potřeby označit čekající operaci migrace.
- Byla přidána příkaz CLUSTER SLOT-STATS pro hodnocení statistik v clusteru na úrovni jednotlivých slotů, jako je počet klíčů, zatížení CPU a síťový vstup/výstup.
Zdroj: opennet.ru
