

Donald Knuth — vědec v oblasti informatiky, který tak pečlivě dbá na správnost svých knih, že nabízí jeden hexadecimální dolar ($2,56, 0x$1,00) za jakoukoli nalezenou „chybu“, kde chybou se rozumí všechno, co je „technicky, historicky, typograficky nebo politicky nesprávné“. Opravdu jsem chtěl dostat šek od Knutha, proto jsem se rozhodl hledat chyby v jeho vynikajícím díle „Umění programování“ (TAOCP). Podařilo se mi najít tři. Právě podle slova, Knuth poslal šek na 0x$3,00.
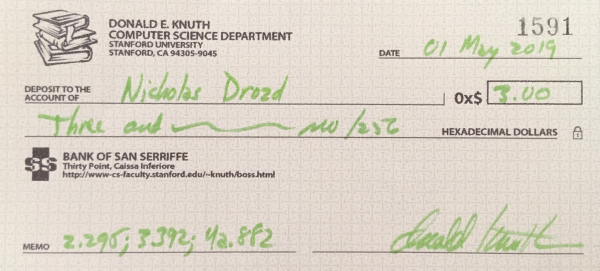
Jak vidíte, toto není skutečný šek. Dříve Knuth posílal skutečné šeky, ale přestal v roce 2008 kvůli . Nyní rozesílá „osobní depozitní certifikáty“ v (BoSS). Říká, že je ochoten poslat skutečné peníze v případě potřeby, ale zdá se, že je to příliš pracné.
Našel jsem dvě tiskové chyby a jednu historickou chybu. Vyjmenuji je podle klesající triviality.
Tisková chyba č. 1
První tisková chyba — na stránce 392 třetího svazku „Třídění a vyhledávání“, osmá řádka zespodu: „Po neúspěšném vyhledávání je někdy (sometime) žádoucí zavést do tabulky nový záznam, který obsahuje K; metoda, která to dělá, se nazývá algoritmus vyhledávání a vkládání. Chyba spočívá v tom, že místo sometime mělo být sometimes.
Samozřejmě, v takové chybě není nic překvapivého. Jen v tomto článku určitě naleznete několik tiskových chyb (žádné odměny za jejich nalezení). Co je opravdu překvapivé, je to, že si jich tak dlouho nikdo nevšiml. Stránka 392 není hluboko pohřbena v oddíle o matematice, je to nejprve první stránka šesté kapitoly „Vyhledávání“! Možná jeden z nejvíce čtených oddílů knihy. Mělo by tam být nejméně tiskových chyb, ale není.
Mimochodem, pokud jste někdy uvažovali o přečtení TAOCP, zkuste to. Mnozí řeknou, že je to příručka, která není určena pro přímé čtení, ale to není pravda. Autor má jasný názor a jedinečný styl. Jediná věc, která brání čitelnosti, je složitost matematiky. Existuje však jednoduché řešení: čtěte, dokud nedojdete k matematice, kterou nerozumíte, přeskočte ji a otevřete další oddíl, který můžete pochopit. Čtením tímto způsobem přeskočím alespoň 80% knihy, ale zbývajících 20% je skvélé!
Také se říká, že TAOCP nerelevantní, zastaralá nebo jinak nevhodná pro „skutečné programování“. To není pravda. Například v první části po úvodu se zkoumá vyhledávání prvku v nesetříděném poli. Nejjednodušší algoritmus je všem programátorům známý. Spusťte ukazatel na začátku pole a poté v cyklu proveďte následující kroky:
- Zkontrolujte, zda je aktuální prvek tím požadovaným. Pokud ano, vraťte ho; jinak
- zkontrolujte, zda není ukazatel mimo pole. Pokud ano, vraťte chybu; jinak
- zvyšte ukazatel a pokračujte.
Nyní zvažte: kolik kontrol hranic tento algoritmus vyžaduje v průměru? V nejhorším případě, když pole neobsahuje prvek, bude každému prvku v seznamu potřeba jedna kontrola, a v průměru to bude něco jako  . Inteligentnější vyhledávací algoritmus může použít pouze jednu kontrolu hranice. Připevněte požadovaný prvek na konec pole, poté spusťte ukazatel na začátku pole a v cyklu proveďte následující kroky:
- Zkontrolujte, zda je aktuální prvek tím požadovaným. Pokud ano, vraťte odpověď, pokud je ukazatel uvnitř pole, nebo chybu, pokud tomu tak není. Jinak
- zvyšte ukazatel a pokračujte.
Ať už tak či onak, prvek bude zaručeně nalezen a kontrola hranice je provedena pouze jednou, když se to stane. To je hluboká myšlenka, ale je dost jednoduchá i pro začínajícího programátora. Asi nemohu mluvit o relevanci této práce pro ostatní, ale okamžitě jsem tuto moudrost uplatnil jak ve svém osobním, tak v profesionálním kódu. Kniha TAOCP je plná takových perel (abych byl spravedlivý, obsahuje také spoustu podivných věcí, jako je ).
„Hledání, hledání
Tak dlouho
Hledání, hledání
Chtěl jsem jen tančit“
— Luther Vandross, „Hledání“ (1980)
Tisková chyba č. 2
Druhý tiskový omyl je v Tomu 4A, „Kombinatorické algoritmy“, část 1. Na stránce 60 je popsán úkol plánování vystoupení komiků v různých kasinech. Jako příklad je uvedeno několik skutečných komiků, včetně Lily Tomlin, Weird Al Yankovice a Robina Williamse, který byl ještě naživu, když kniha vyšla. Knuth vždy uvádí v rejstříku plná jména, takže Williams je zmíněn na stránce 882 jako „Williams, Robin Mac-Lorin“. Jeho druhé jméno končí na „n“, nikoli na „m“, tedy Mac-Lorin.
Mac-Lorin je dívčí jméno jeho matky. Byla pravnučkou Anselma Josepha Mac-Lorina, 34. guvernéra Mississippi. Jeho vláda se zřejmě nezapamatovala ničím pozitivním. Z knihy :
„Nejdůležitějším bodem během administrativy Mac-Lorina bylo vyhlášení války Španělsku ze strany Spojených států na jaře 1898… Bohužel válka mohla některým úředníkům poskytnout příležitosti k praktikování úplatkářství. Mac-Lorin byl obviněn z různých pochybností, včetně nepoctivosti a nadměrného využívání pravomocí k omilostňování. V éře hnutí za střízlivost ho kritici obvinili z opilství, což veřejně přiznal.“
Historická chyba
Zvažme tradiční algoritmus násobení ze školního programu. Kolik vyžaduje jednoprizmatických násobení? Předpokládejme, že násobíte  -místné číslo
 na
 -místné
 . Nejprve násobíte první číslici
 každou číslicí
 pořadě. Poté násobíte druhou číslici
 každou číslicí
 pořadě a tak dále, dokud neprojdete všemi číslicemi
 . Tímto způsobem tradiční násobení vyžaduje
 primárních násobení. Zejména násobení dvou čísel podle
 místností vyžaduje
 jednoprizmatická násobení.
To je špatné, ale proces lze optimalizovat pomocí metody vyvinuté sovětským matematikem Anatolijem Alexejevičem Karacubou. Předpokládejme, že  a
 jsou dvouciferná desítková čísla; to znamená, že existují čísla
 ,
 ,
 ,
 taková, že
 a
 (generalizace tohoto algoritmu na větší číslice vyžaduje určité manipulace; i když to není příliš složité, abych se ve detailech nespletl, raději se budu držet jednoduchého příkladu). Potom
 ,
 ,
 . Násobení dvojčlenů dává
 . V tuto chvíli máme stále
 jednoprizmatického násobení:
 ,
 ,
 ,
 . Nyní sečtěme a odečtěme
 . Po několika přeházeních, která nechám jako cvičení pro čtenáře, to vyjde
 — celkem tři jednociferné násobení! (Existují určité konstantní koeficienty, ale ty lze spočítat pouze sčítáním a posunováním cifer).
Nežádejte o důkaz, ale Karacubův algoritmus (rekurzivně obecně rozšířený z výše uvedeného příkladu) zlepšuje tradiční metodu násobení ze  operací na
 . Všimněte si, že se jedná o skutečné zlepšení algoritmu, a ne optimalizaci pro výpočty v mysli. Opravdu, algoritmus není vhodný pro počítání v mysli, protože vyžaduje vysoké náklady na rekurzivní operace. Navíc se efekt plně neprojeví, dokud čísla nebudou dostatečně velká (naštěstí místo Karacubova algoritmu přišly ještě rychlejší metody: v březnu 2019 byl zveřejněn algoritmus, který vyžaduje pouze násobení; urychlení se vztahuje pouze na nesmírně velká čísla).
Tento algoritmus je popsán na straně 295 druhého svazku „Následujících algoritmů“. Tam Knuth píše: „Zajímavé je, že tuto myšlenku objevili pouze v 1962 roce“, kdy byla zveřejněna studie popisující Karacubův algoritmus. Ale! V roce 1995 Karacuba zveřejnil článek „Složitost výpočtů“, ve kterém říká několik věcí: 1) kolem roku 1956 Kolmogorov předpokládal, že násobení nelze provést za méně než  kroků; 2) v 1960 roce se Karacuba zúčastnil semináře, kde Kolmogorov představil svou hypotézu n². 3) „Přesně za týden“ Karacuba vyvinul algoritmus „rozděl a panuj“; 4) v roce 1962 Kolmogorov napsal a zveřejnil článek jménem Karacuby s popisem algoritmu. „O tomto článku jsem se dozvěděl až poté, co ho přetiskli.“
Tím pádem chyba spočívá v tom, že místo 1962 byl uveden 1960 rok. To je vše.
Analýza
Hledání chyb nevyžadovalo zvláštní dovednosti.
- První chyba byla tak banální, jak je to jen možné, a nacházela se na relativně viditelném místě (na začátku kapitoly). Jakýkoli idiot by ji našel; prostě jsem se ocitl tím idiotem.
- Hledání druhé chyby vyžadovalo štěstí a úsilí, nikoli dovednost. Index pro „Williamse“ se nachází na předposlední stránce svazku, což je poměrně výrazná část knihy. Právě jsem procházel indexem (to není tak bolestné, jak se zdá, protože v indexech Knutha jsou skryté velikonoční vajíčka. Například tam jsou záznamy v arabštině a hebrejštině, a oba odkazují na stránku 66. Ale na této stránce není zmíněn žádný z jazyků; místo toho se zde zmiňují „jazyky čtené zprava doleva“). A má pozornost upoutalo druhé jméno. Protože obvykle čtu Wikipedii, tak jsem zkontroloval Robina Williamse a všiml jsem si nesrovnalosti.
- Chtěl bych říci, že jsem vedl vážný výzkum, abych našel historickou chybu, ale ve skutečnosti jsem se prostě podíval V prvních řádcích je napsáno: „Karatsubův algoritmus je algoritmus pro rychlé násobení. Objeven Anatolijem Karatsubou v roce 1960 a publikován v roce 1962.“ Po tomto zbývalo pouze sečíst dvakrát dvě.
V budoucnu bych chtěl najít podstatnější chybu, zejména v Knuthově kódu. Chtěl bych také najít chybu v prvním svazku „Základní algoritmy“. Možná bych nějakou našel, ale v místní knihovně z nějakého důvodu mají pouze svazky 2, 3 a 4A.
Finanční fakta:
- Celkově můj příspěvek do TAOCP tvoří jen tři symboly: jedno přidání s, nahrazení m na n a 2 na 0. Za cenu 2,56 USD jsou to docela výnosné symboly; pokud byste dostávali takové peníze, pak by článek o 1000 slovech (v průměru čtyři symboly) přinesl deset kusů.
- Se třemi šestnáctkovými dolary sdílím s 29 dalšími občany 69. místo na seznamu nejbohatších vkladatelů banky San-Serif (k 1. květnu 2019).
Další diskuse o šekech od Knutha
Obecná doporučení pro hledání chyb v knihách Knutha. Týkají se především technických chyb, které nemám. Je tam jedna věta, kterou jsem vzal vážně:
Lepší je počkat, až nasbíráte sadu chyb k zaslání. Spojením několika skutečných, ale ne velmi cenných chyb zvýšíte pravděpodobnost, že jedna z nich bude skutečně považována za chybu nebo radu. Pokud posíláte chyby jednotlivě, každou zvlášť mohou odmítnout.
Nechtěl jsem posílat jen nějaké hlouposti, ale poslechl jsem radu a poslal jsem e-mail až poté, co jsem našel historickou chybu, která se mi zdála dost závažná.
Ašutoš Mehra je třetím nejbohatším investorem v San-Serriff s obrovským jměním 0x$207,f0 v BoSS.
- Různé:
Zdroj: habr.com
