

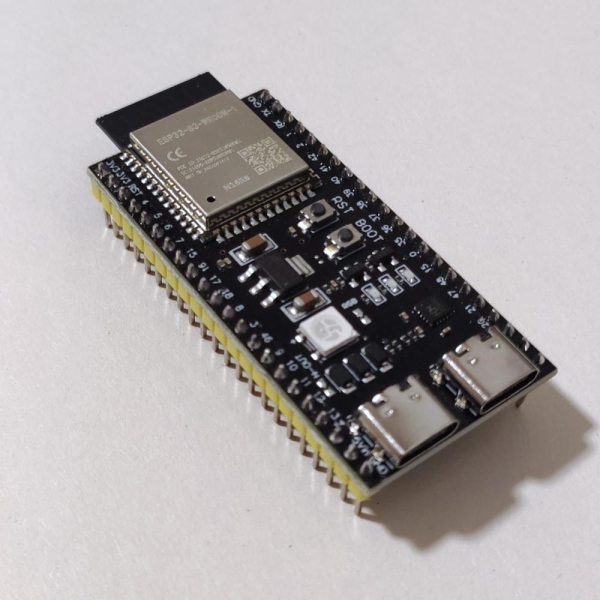
Vývojář Vjačeslav Serbov, vystupující pod přezdívkou slvDev, předvedl úplně lokální generaci textu na mikrořadiči ESP32-S3. Vytvořený jazykový model obsahuje 28,9 miliónu parametrů a vydává přibližně 9,9 tokenu za sekundu, aniž by se obracel na server nebo jiné externí výpočetní prostředky. Vygenerované krátké příběhy se zobrazují na připojeném OLED displeji.
Projekt esp32-ai byl testován na modulu ESP32-S3 N16R8, který disponuje 512 KB vestavěné SRAM, 8 MB PSRAM a 16 MB flash paměti. Kvantovaná na čtyři bity model zabírá 14,9 MB. V repozitáři jsou zveřejněny zdrojové kódy běhového prostředí v C, nástroje pro učení a kvantování modelu, firmware, testy a scénáře pro jeho nahrávání na desku.
Uvedených 28,9 miliónu parametrů by se nemělo přímo srovnávat s počtem parametrů běžných desktopových LLM. Podle podrobné zprávy vývojáře, model se skládá z hustého výpočetního jádra přibližně na 559 tisíc parametrů, výstupní vrstvy na 3,1 milionu parametrů a tabulky vrstevnatých vektorových reprezentací přibližně na 25 miliónů parametrů. Právě poslední zajišťuje hlavní část formální velikosti modelu, ale není zpracovávána celá při generaci každého tokenu.
Pro umístění modelu jsou využity tři úrovně paměti. Nejčastěji používaná data se nacházejí ve vnitřní SRAM, výstupní vrstva, KV-cache a dočasné buffery – v PSRAM, zatímco 25-miliónová tabulka zůstává ve flash paměti a je dostupná prostřednictvím mapování do adresového prostoru. Pro každý token je z ní načítáno jen přibližně šest řádků s celkovým objemem přibližně 450 bajtů.
Takové zařízení je založeno na technologii Per-Layer Embeddings, kterou aplikoval Google v Gemma 3n. Podle dokumentace Google, PLE-parametry mohou být ukládány mimo pracovní paměť modelu a přidávány do procesu výstupu při zpracování jednotlivých vrstev. V esp32-ai byl tento přístup přenesen na hierarchii paměti mikrořadiče, kde je rychlá SRAM zvlášť omezená.
První správná verze prostředí pro vykonávání napsaného v C poskytovala pouze 0,57 tokenu za sekundu. Po umístění výstupní vrstvy do PSRAM, přechodu na osmi bitové aktivace, rozdělení výpočtů mezi dvě jádra Xtensa LX7 a dalších optimalizacích byla latence snížena na 94,9 ms na krok modelu. Konečná naměřená rychlost dosáhla 9,88 tokenu za sekundu při zohlednění celého procesu generování. Hlavním omezením se nyní stala propustnost PSRAM při čtení výstupní vrstvy.
Model byl natrénován na syntetickém datasetu TinyStories, který se skládá z jednoduchých anglických příběhů s omezeným slovníkem. Proto je schopna pokračovat ve větách a vytvářet malé souvislé příběhy, ale není určena k odpovídání na otázky, provádění pokynů, programování nebo reprodukování faktických znalostí. Vývojář považuje práci především za demonstraci efektivního umístění modelu do paměti mikrokontroléru, nikoli za hotového autonomního chatbotu.
V aktuální dokumentaci autor zvlášť zdůrazňuje, že esp32-ai je samostatný projekt. Projekty llama2.c Andrey Karpathy a dřívější spuštění 260tisícového modelu na ESP32-S3 jsou uvedeny pouze jako orientační body a příklady předchozích prací: kód, záchytné body a metodika nejsou z nich přímo převzaty. Zdrojový kód esp32-ai se šíří pod licencí MIT.
Zdroj: linux.org.ru
