

V červnu tohoto roku se v malém švýcarském městě Rapperswil již po desáté konala akce s názvem . Tentokrát se na ní sešlo více než pět set nadšenců Haskellu, od nováčků po otce zakladatele jazyka. Ačkoli organizátoři tuto akci nazývají hackathonem, přesto to není konference nebo hackathon v klasickém slova smyslu. Její formát se liší od tradičních programátorských setkání. O ZuriHac jsme se dozvěděli náhodou, zúčastnili jsme se ho a nyní považujeme za svou povinnost podělit se o tuto neobvyklou objev.
O nás
Tento článek připravili dva studenti 3. ročníku programu „Aplikovaná matematika a informatika“ na VŠE – Petrohrad: Vasilij Aljoforov a Jelizaveta Vasilenková. Zájem o funkcionální programování pro nás oba začal cyklem přednášek D. N. Moskvin během 2. ročníku univerzity. V současné době se Vasilij účastní programu Google Summer of Code, v rámci kterého se věnuje realizaci algebraických grafů v jazyce Haskell pod vedením týmu projektu . Jelizaveta využila získané dovednosti funkcionálního programování ve své závěrečné práci, která byla věnována realizaci algoritmu anti-unifikace s následným využitím v teorii typů.
Formát akce
Cílovou skupinou jsou vlastníci projektů s otevřeným zdrojovým kódem, programátoři, kteří se chtějí podílet na jejich rozvoji, výzkumníci funkcionálního programování a jednoduše nadšenci do Haskellu. Tento rok se na místě konání – na univerzitě HSR Hochschule für Technik Rapperswil – sešli vývojáři z více než padesáti otevřených projektů v jazyce Haskell z celého světa, aby představili své produkty a zaujali nové lidi pro jejich rozvoj.
Fotografie z Twitteru
Zásada je velmi jednoduchá: je nutné předem napsat několik vět o svém projektu a poslat je organizátorům, kteří zveřejní informace o vašem projektu na stránce akce. Kromě toho mají autoři projektů první den třicet sekund na to, aby velmi stručně z pódia řekli, čím se zabývají a co je potřeba udělat. Poté se zájemci po autorech shánějí a podrobně se ptají na úkoly.
Zatím nemáme žádné vlastní otevřené projekty, ale velmi bychom chtěli přispět k již existujícím, proto jsme se zaregistrovali jako běžní účastníci. Během tří dnů jsme pracovali se dvěma skupinami vývojářů. Ukázalo se, že společné studium kódu a živá komunikace činí spolupráci autorů projektu a contributorů velmi produktivní – na ZuriHac jsme se dokázali vyznat v nových oblastech a pomohli jsme dvěma zcela odlišným týmům tím, že jsme uzavřeli jednu úlohu v každém z projektů.
Kromě cenné praxe se na ZuriHac konalo také několik přednášek a workshopů. Zvlášť si pamatujeme dvě přednášky. Na první z nich Andrej Mohov z Newcastle University hovořil o selektivních aplikativních funktorech — třídě typů, která by měla sloužit jako mezistupeň mezi aplikativními funktory a monádami. Na druhé přednášce jeden z zakladatelů Haskellu, Simon Peyton Jones, vyprávěl o tom, jak funguje typový vývod v kompilátoru GHC.
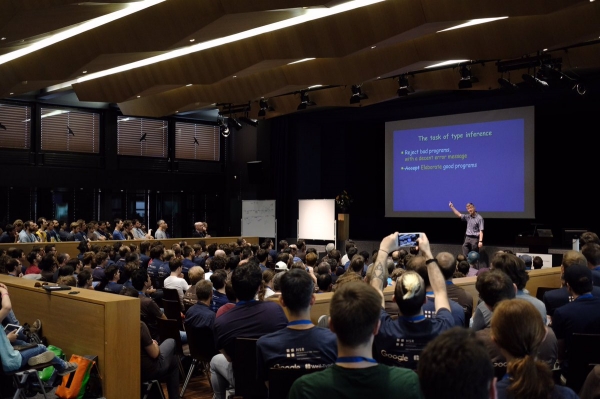
Přednáška Simona Peytona Jonese. Foto z Twitteru
Workshopy, které probíhaly během hackathonu, byly rozděleny do tří kategorií podle úrovně přípravy účastníků. Úkoly, které byly navrženy pro účastníky zapojené do vývoje projektů, měly také označení úrovně obtížnosti. Bývalé, ale soudržné společenství funkčních programátorů s radostí přijímá nováčky. Pro porozumění přednáškám Andreje Mohova a Simona Peytona Jonese nám však velmi pomohl kurz funkčního programování, který jsme absolvovali na univerzitě.
Jak pro běžné účastníky, tak pro autory projektů je registrace na akci zdarma. Přihlášky jsme podali na začátku června, po kterém jsme byli poměrně rychle převedeni z čekacího seznamu na seznam potvrzených účastníků.
A teď vám povíme o projektech, na jejichž vývoji jsme se podíleli.
Pandoc
— to je univerzální konvertor textových dokumentů, vlastně — z jakéhokoli formátu do jakéhokoli. Například z docx do pdf, nebo z Markdown do MediaWiki. Jeho autorem je John MacFarlane — profesor filozofie na Kalifornské univerzitě v Berkeley. Pandoc je obecně docela známý, a někteří naši známí byli překvapeni, když zjistili, že Pandoc je napsaný v Haskellu.
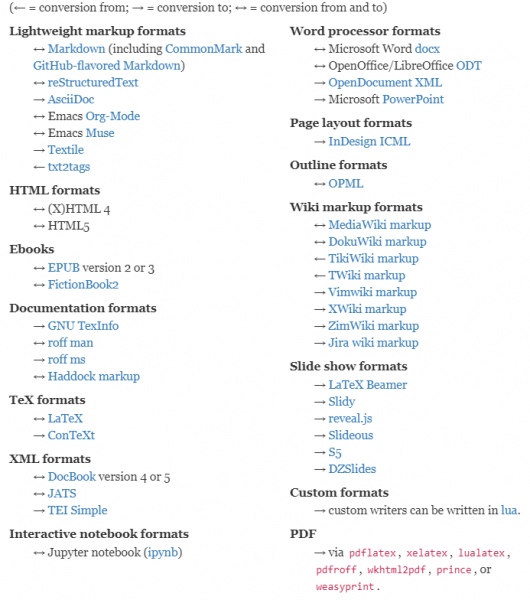
Seznam formátů dokumentů, které Pandoc podporuje. Na webu je také celá grafika, ale tento obrázek se do článku nevejde.
Samozřejmě, že v Pandoc není přímo implementována konverze pro každý pár formátů. Pro podporu tak rozsáhlého množství převodů se používá standardní architektonické řešení: nejprve je celý dokument převeden do speciálního vnitřního mezivstupu a poté se na základě tohoto vnitřního mezivstupu generuje dokument v jiném formátu. Vnitřní reprezentaci vývojáři nazývají „AST“, což je zkratka pro Abstract Syntax Tree, nebo . Na vnitřní reprezentaci se lze podívat velmi snadno: stačí zadat jako výstupní formát „native“
$ cat example.html
<h1>Hello, World!</h1>

$ pandoc -f html -t native example.html
[Header 1 ("hello-world",[],[]) [Str "Ahoj,",Space,Str "světe!"]]
Čtenáři, kteří alespoň trochu pracovali s Haskellem, už mohou z tohoto malého příkladu usoudit, že Pandoc je napsán právě v Haskellu: výstup tohoto příkazu je reprezentace vnitřních struktur Pandoc ve formě řetězce, vytvořená podle vzoru, jak se to obvykle dělá v Haskellu, například ve standardní knihovně.
Takže zde můžeme vidět, že vnitřní reprezentace je rekurzivní struktura, v každém vnitřním uzlu se nachází seznam. Například na nejvyšší úrovni je seznam jednoho prvku — nadpis první úrovně s atributy “hello-world”,[],[]. Uvnitř tohoto nadpisu je skryt seznam ze řetězce “Hello,”, mezery a řetězce “World!”.
Jak je vidět, vnitřní reprezentace se od HTML příliš neliší. Představuje si to jako strom, kde každý vnitřní uzel poskytuje nějaké informace o formátování svých potomků, a v listech se nachází samotný obsah dokumentu.
Pokud se ponoříme na úroveň konkrétní implementace, typ dat pro celý dokument je definován takto:
data Pandoc = Pandoc Meta [Block]Zde Block — to jsou právě vnitřní vrcholy, o kterých se hovořilo výše, a Meta — to je metadata o dokumentu, jako je nadpis, datum vytvoření, autoři — pro různé formáty to může být různá a Pandoc se snaží co nejvíce uchovat takové informace při převodu mezi formáty.
Skoro všichni konstruktéři typu Block — například Header nebo Para (odstavec) — přijímají jako argumenty atributy a seznam níže zasazených prvků — Inline, obvykle. Například Space nebo Str jsou konstruktéry typu Inline, také speciální Inline se vytváří z HTML tagu. Nevidíme důvod uvádět kompletní definici těchto typů, avšak poznamenáme, že si ji lze prohlédnout zde .
Zajímavé je, že typ Pandoc je monoida. To znamená, že existuje nějaký prázdný dokument a že dokumenty lze mezi sebou skládát. Tímto způsobem je to pohodlné při psaní Readerů — lze rozdělit dokument na části podle libovolné logiky, každou zpracovat odděleně a pak vše spojit do jednoho dokumentu. Přitom se metainformace sesbírají ze všech částí dokumentu najednou.
Při konverzi, řekněme, z LaTeXu do HTML, nejprve speciální modul, který se nazývá LaTeXReader, převede vstupní dokument do AST, poté další modul, který se nazývá HTMLWriter, převede AST do HTML. Díky takové architektuře není třeba psát kvadratické množství konverzí — stačí napsat Reader a Writer pro každý nový formát, a všechny možné páry konverzí budou automaticky podporovány.
Je jasné, že taková architektura má i své nevýhody, které byly dávno předpovězeny specialisty v oblasti softwarové architektury. Nejvýznamnější je cena, kterou nesou změny v syntaktickém stromu. Pokud je změna dostatečně vážná, bude třeba měnit kód ve všech Readerech a Writelech. Například jedna z úloh, které stojí před vývojáři Pandoc, je podpora složitých formátů tabulek. V současnosti Pandoc umí pouze jednoduché tabulky, se záhlavím, sloupci a hodnotou v každé buňce. Řekněme, že atribut colspan v HTML bude prostě ignorován. Jedním z důvodů tohoto chování je absence jednotné schématu prezentace tabulek ve všech nebo alespoň mnoha formátech — takže je nejasné, v jakém formátu je třeba tabulky uchovávat v interní reprezentaci. Ale i po výběru konkrétní reprezentace bude třeba změnit naprosto všechny Readery a Writeře, kteří podporují práci s tabulkami.
Jazyk Haskell byl vybrán nejen pro velkou lásku autorů k funkcionálnímu programování. Haskell je známý svými širokými možnostmi zpracování textů. Jedním z příkladů je knihovna — knihovna, která aktivně využívá koncepty funkcionálního programování — monoidy, monády, aplikativní a alternativní funktory — k psaní libovolných parserů. Veškerou sílu Parsec lze vidět na s HaskellWiki, kde je podrobně rozebrán kompletní parser jednoduchého imperativního programovacího jazyka. Samozřejmě, Parsec je aktivně používán i v Pandoc.
Pokud bychom to krátce shrnuli, monády se používají pro sekvenční parsing, kdy nejprve proběhne jedno a poté druhé. Například v takovém příkladu:
whileParser :: Parser Stmt
whileParser = whiteSpace >> statement
Nejprve je třeba přečíst bílé místo, a poté statement — který má také typ Parser Stmt.
Alternativní funktory se používají pro zpětný krok v případě, že parsing neproběhl úspěšně. Například,
statement :: Parser Stmt
statement = parens statement  sequenceOfStmt
To znamená, že se pokusíme buď přečíst statement v závorkách, nebo se postupně pokusíme přečíst několik statementů.
Aplikativní funktory se používají především jako zkratky pro monády. Například, ať už funkce tok čte nějaký token (to je skutečná funkce z LaTeXReader). Podívejme se na tuto kombinaci
const tok tokPřečte dva tokeny za sebou a vrátí z nich první.
Pro všechny tyto třídy existují v Haskellu krásné symbolické operátory, což činí programování Readerů podobným ASCII-artu. Jen se podívejte na tento úžasný kód.
Naše úkoly byly spojeny s LaTeXReaderem. Úkolem Vasila bylo podpořit příkazy mbox a hbox, užitečné při psaní balíčků v LaTeXu. Na zodpovědnost Alžběty byla podpora příkazu epigraph, který umožňuje formátovat epigrafy v LaTeX dokumentech.
Hatrace
V UNIXových operačních systémech je často implementován systémový záznam ptrace. Je užitečný při ladění a simulaci prostředí programů, což umožňuje sledovat systémové volání, které program provádí. Například velmi užitečný nástroj strace využívá uvnitř právě ptrace.
Hatrace je knihovna, která poskytuje rozhraní pro ptrace v Haskellu. Samotný ptrace je totiž velmi složitý a jeho přímé použití je poměrně obtížné, zejména u funkčních jazyků.
Hatrace při spuštění funguje jako strace a přijímá podobné argumenty. Jeho rozdíl od strace spočívá v tom, že je také knihovnou, která poskytuje jednodušší rozhraní než samotný ptrace.
Pomocí Hatrace jsme již zachytili jeden nepříjemný bug v kompilátoru Haskellu GHC — když je zabit v nevhodný okamžik, generuje neplatné objektové soubory a při restartu je znovu nepřekompiluje. Skriptování systémových volání umožnilo s jistotou reprodukovat chybu během jednoho běhu, zatímco náhodné zabíjení reprodukovalo chybu přibližně za dvě hodiny.
Do knihovny jsme přidali rozhraní pro systémová volání — Eliška přidávala brk a Vasilij přidával mmap. Výsledky naší práce umožňují jednodušší a přesnější použití argumentů těchto systémových volání při použití knihovny.
Zdroj: habr.com
