

30. listopadu – 1. prosince se v Nižním Novgorodu konal. Účastníci měli za úkol vytvořit prototyp produktového řešení za použití nástroje Intel OpenVINO. Organizátoři nabídli seznam příkladných témat, na která se mohli orientovat při výběru úkolu, ale konečné rozhodnutí zůstalo na týmech. Kromě toho bylo podporováno použití modelů, které nejsou součástí produktu.
V článku se podělíme o to, jak jsme vytvořili náš prototyp produktu, se kterým jsme nakonec získali první místo.
Hackathonu se zúčastnilo více než 10 týmů. Je potěšující, že některé z nich přijely z jiných regionů. Místem konání hackathonu se stal komplex „Kreml na Počaině“, kde byly uvnitř vyvěšeny staré fotografie Nižního Novgorodu, atmosféra byla skvělá! (připomínám, že v tuto chvíli má centrální kancelář společnosti Intel sídlo právě v Nižním Novgorodu). Účastníkům bylo poskytnuto 26 hodin na napsání kódu, na konci se museli prezentovat své řešení. Dalším pozitivem byla přítomnost demo sezení, aby bylo možné se ujistit, že vše, co bylo zamýšleno, bylo skutečně realizováno a nezůstalo jen nápady v prezentaci. Merch, snacky, jídlo, všechno bylo také!
Kromě toho společnost Intel na přání poskytovala kamery, Raspberry PI, Neural Compute Stick 2.
Výběr úkolu
Jednou z nejobtížnějších částí přípravy na hackathon s volnou tématikou je výběr úkolu. Hned jsme se rozhodli vymyslet něco, co v produktu ještě není, protože v oznámení bylo zmíněno, že to je vítáno.
Po analýze , které jsou součástí aktuální verze produktu, docházíme k závěru, že většina z nich řeší různé úkoly v oblasti počítačového vidění. Je velmi obtížné vymyslet úkol z oblasti počítačového vidění, který by nešel vyřešit pomocí OpenVINO, a pokud by něco takového bylo myšleno, tak je těžké najít předtrénované modely v otevřeném přístupu. Rozhodli jsme se dále hledat v jiném směru – směrem zpracování a analýzy řeči. Zvažujeme zajímavý úkol rozpoznávání emocí podle řeči. Je třeba říci, že v OpenVINO již existuje model, který určuje emoce člověka podle obličeje, ale:
- Teoreticky by bylo možné vytvořit kombinovaný algoritmus, který by pracoval jak se zvukem, tak s obrazem, což by mělo přinést nárůst přesnosti.
- Kamery obvykle mají úzký úhel pohledu, aby pokryly větší oblast, potřebujeme více než jednu kameru, zvuk nemá takové omezení.
Rozvíjíme myšlenku: vezmeme jako základ myšlenku pro retailový segment. Můžeme určovat spokojenost zákazníků na pokladnách obchodů. Pokud je nějaký zákazník nespokojený se službami a začne zvyšovat hlas — můžeme hned zavolat administrátora na pomoc.
V tomto případě je třeba přidat rozpoznávání člověka podle hlasu, to nám umožní rozlišovat zaměstnance obchodu od zákazníků, poskytovat analýzu pro každého jednotlivce. A kromě toho budeme moci analyzovat chování samotných zaměstnanců obchodu, hodnotit atmosféru v kolektivu, zní to dobře!
Formulujeme požadavky na naše řešení:
- Malá velikost cílového zařízení
- Práce v reálném čase
- Nízká cena
- Snadná škálovatelnost
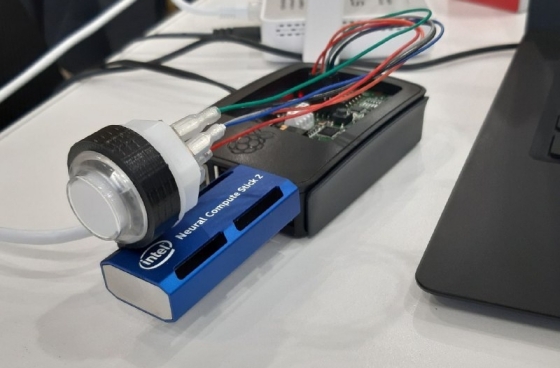
Nakonec vybíráme jako cílové zařízení Raspberry Pi 3 s .
Zde je důležité zmínit jednu důležitou vlastnost NCS — nejlépe funguje se standardními architekturami CNN, pokud bude nutné spustit na něm model s vlastními vrstvami, očekávejte nízkoúrovňovou optimalizaci.
Teď je potřeba sehnat mikrofon. Vhodný je i běžný USB mikrofon, i když nebude vypadat dobře s RPI. Ale i zde je řešení doslova „na dosah ruky“. Pro nahrávání hlasu se rozhodujeme použít desku Voice Bonnet z sady , na které je pájený stereo mikrofon.
Stahujeme Raspbian z a nahráváme na USB flash disk, testujeme, zda mikrofon funguje pomocí následující příkazu (nahráli 5 sekund audio a uloží do souboru):
arecord -d 5 -r 16000 test.wavHned podotýkám, že mikrofon je velmi citlivý a dobře zachycuje šumy. Abychom to napravili, vstoupíme do alsamixer, vybereme Capture devices a snížíme úroveň vstupního signálu na 50-60%.
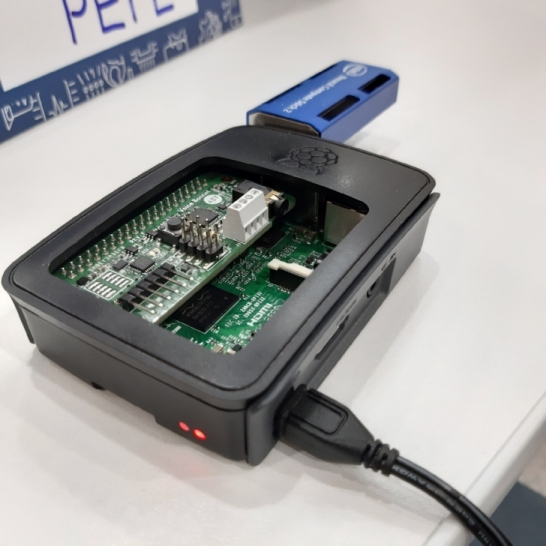
Dopracováváme skříňku pilníkem a vše se vejde, můžeme dokonce zavřít víkem.
Přidáváme indikátorové tlačítko.
Během rozebírání AIY Voice Kit na části si vzpomínáme, že tam je RGB tlačítko, jehož osvětlení lze řídit programově. Hledáme “Google AIY Led” a nacházíme dokumentaci:
Proč nepoužít toto tlačítko k zobrazení rozpoznané emoce, máme jen 7 tříd, zatímco tlačítko má 8 barev, což je přesně dost!
Připojíme tlačítko přes GPIO k Voice Bonnet, načteme potřebné knihovny (tyto jsou již nainstalovány v distribuci od AIY projects)
from aiy.leds import Leds, Color
from aiy.leds import RgbLeds
Vytvoříme dict, ve kterém každé emoci bude odpovídat barva ve formátu RGB Tuple a objekt třídy aiy.leds.Leds, přes který budeme aktualizovat barvu:
led_dict = {'neutral': (255, 255, 255), 'happy': (0, 255, 0), 'sad': (0, 255, 255), 'angry': (255, 0, 0), 'fearful': (0, 0, 0), 'disgusted':  (255, 0, 255), 'surprised':  (255, 255, 0)}
leds = Leds()
A nakonec, po každé nové predikci emoce budeme aktualizovat barvu tlačítka podle ní (podle klíče).
leds.update(Leds.rgb_on(led_dict.get(classes[prediction])))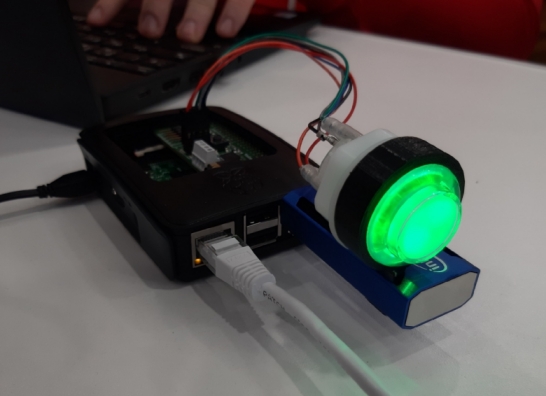
Tlačítko, hoř!
Pracujeme s hlasem
Budeme používat pyaudio pro zachycení streamu z mikrofonu a webrtcvad pro filtrování šumu a detekci hlasu. Kromě toho vytvoříme frontu, do které budeme asynchronně přidávat a odebírat úryvky s hlasem.
Jelikož webrtcvad má omezení na velikost dodávaného fragmentu – musí být 10/20/30 ms, a trénink modelu pro rozpoznání emocí (jak se později dozvíme) probíhal na datasetu 48 kHz, budeme zachycovat chunk velikosti 48000×20 ms/1000×1 (mono)=960 bytů. Webrtcvad bude vracet True/False pro každý takový chunk, což odpovídá přítomnosti nebo nepřítomnosti hlasu v chunku.
Realizujeme následující logiku:
- Budeme přidávat do listu ty chunk, kde je hlas, a pokud hlas není, inkrementujeme čítač prázdných chunků.
- Pokud čítač prázdných chunků >=30 (600 ms), podíváme se na velikost listu nahromaděných chunků, pokud je >250, přidáme do fronty, pokud ne, považujeme to za nedostatečnou délku nahrávání, abychom ji mohli poslat modelu pro identifikaci mluvčího.
- Pokud je však čítač prázdných chunků stále < 30 a velikost listu nahromaděných chunků překročila 300, přidáme úryvek do fronty pro přesnější predikci. (protože s časem mají emoce tendenci se měnit)
 def to_queue(frames):
    d = np.frombuffer(b''.join(frames), dtype=np.int16)
    return d

framesQueue = queue.Queue()
def framesThreadBody():
    CHUNK = 960
    FORMAT = pyaudio.paInt16
    CHANNELS = 1
    RATE = 48000

    p = pyaudio.PyAudio()
    vad = webrtcvad.Vad()
    vad.set_mode(2)
    stream = p.open(format=FORMAT,
                channels=CHANNELS,
                rate=RATE,
                input=True,
                frames_per_buffer=CHUNK)
    false_counter = 0
    audio_frame = []
    while process:
        data = stream.read(CHUNK)
        if not vad.is_speech(data, RATE):
            false_counter += 1
            if false_counter >= 30:
                if len(audio_frame) > 250:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
                    false_counter = 0

        if vad.is_speech(data, RATE):
            false_counter = 0
            audio_frame.append(data)
            if len(audio_frame) > 300:
                    framesQueue.put(to_queue(audio_frame,timestamp_start))
                    audio_frame = []
Přišel čas hledat předtrénované modely ve veřejných zdrojích, jdeme na github, googlíme, ale pamatujeme, že máme omezení na použitou architekturu. To je poměrně složitá část, protože je nutné testovat modely na svých vstupních datech a navíc je převádět do interního formátu OpenVINO – IR (Intermediate Representation). Zkusili jsme asi 5-7 různých řešení z githubu, a pokud model pro rozpoznávání emocí fungoval hned, pak s rozpoznáváním na základě hlasu to trvalo déle – tam se používají složitější architektury.
Zůstáváme u následujících:
- Emoce z hlasu —
Funguje to na tomto principu: audio se ořezává na úryvky určité velikosti, pro každý z těchto úryvků vyběr máme a poté je posíláme do CNN - Rozpoznávání podle hlasu —
Zde místo MFCC pracujeme se spektrogramem, po FFT posíláme signál do CNN, kde na výstupu získáváme vektorové zastoupení hlasu.
Dále se zmíníme o převodu modelů, začneme teorií. OpenVINO zahrnuje několik modulů:
- Open Model Zoo, modely z kterého lze použít a zakomponovat do vlastního produktu
- Model Optimizer, díky kterému lze přeconvertovat model z různých formátů frameworků (Tensorflow, ONNX atd.) do formátu Intermediate Representation, se kterým budeme dále pracovat
- Inference Engine umožňuje spouštět modely v IR formátu na procesorech Intel, čipech Myriad a akcelerátorech Neural Compute Stick
- Nejúčinnější verze OpenCV (s podporou Inference Engine)
Každý model ve formátu IR je popsán dvěma soubory: .xml a .bin.
Modely se převádějí do formátu IR prostřednictvím Model Optimizer následujícím způsobem:python /opt/intel/openvino/deployment_tools/model_optimizer/mo_tf.py --input_model speaker.hdf5.pb --data_type=FP16 --input_shape [1,512,1000,1]--data_typeumožňuje vybrat formát dat, se kterým bude model pracovat. Podporovány jsou FP32, FP16, INT8. Výběr optimálního typu dat může přinést značné zvýšení výkonu.
--input_shapeurčuje dimenze vstupních dat. Možnost dynamicky ji měnit je sice přítomna v C++ API, ale necítili jsme potřebu to tak podrobně zkoumat a pro jeden z modelů jsme ji jednoduše zafixovali.
Dále se pokusíme načíst již převedený model v IR formátu přes DNN modul v OpenCV a provést na něm forward.import cv2 as cv emotionsNet = cv.dnn.readNet('emotions_model.bin', 'emotions_model.xml') emotionsNet.setPreferableTarget(cv.dnn.DNN_TARGET_MYRIAD)Poslední řádek v tomto případě umožňuje přesměrovat výpočty na Neural Compute Stick, základně se výpočty provádí na procesoru, ale v případě Raspberry Pi to nebude fungovat, bude potřeba stick.
Dále je logika následující: rozdělíme naše audio na okna určité velikosti (v našem případě je to 0.4s), každé z těchto oken převedeme na MFCC, které pak předáme do sítě:
emotionsNet.setInput(MFCC_from_window)
result = emotionsNet.forward()
Poté vezmeme nejčastější třídu pro všechna okna. Jednoduché řešení, ale na hackathon a není třeba vymýšlet něco příliš složitého, pouze pokud zbývá čas. Naší práci máme ještě dost, takže jdeme dál — zabýváme se rozpoznáváním hlasu. Je třeba vytvořit nějakou databázi, ve které budou uloženy spektrogramy předem nahraných hlasů. Protože času už moc nezbývá, řešíme to, jak jen můžeme.
A sice, vytváříme skript pro nahrávání úryvků hlasu (funguje tak, jak je popsáno výše, pouze při přerušení klávesnicí bude ukládat hlas do souboru).
Zkoušíme:
python3 voice_db/record_voice.py test.wavNahráváme hlasy několika lidí (v našem případě tří členů týmu)
Dále pro každý nahraný hlas provedeme rychlou fourierovu transformaci, získáme spektrogram a uložíme ve formátu numpy array (.npy):for file in glob.glob("voice_db/*.wav"): spec = get_fft_spectrum(file) np.save(file[:-4] + '.npy', spec)Podrobnosti v souboru
create_base.py
Výsledkem při spuštění hlavního skriptu bude na začátku získání embeddingů z těchto spektrogramů:for file in glob.glob("voice_db/*.npy"): spec = np.load(file) spec = spec.astype('float32') spec_reshaped = spec.reshape(1, 1, spec.shape[0], spec.shape[1]) srNet.setInput(spec_reshaped) pred = srNet.forward() emb = np.squeeze(pred)Po získání embeddingu z přehrávaného úryvku můžeme určit, komu patří, získáním kosinové vzdálenosti od úryvku ke všem hlasům v databázi (čím menší, tím pravděpodobnější) — pro demo jsme nastavili práh 0.3):
        dist_list = cdist(emb, enroll_embs, metric="cosine")
        distances = pd.DataFrame(dist_list, columns = df.speaker)
Na závěr zmíním, že rychlost inference byla rychlá a umožňovala přidat další 1-2 modely (na vzorek dlouhý 7 sekund na inference se strávilo 2.5). Nové modely jsme již nestihli přidat a zaměřili jsme se na psaní prototypu webové aplikace.
Webová aplikace
Důležitý bod: vezměte si s sebou router z domova a nastavte si svou místní síť, pomůže to spojit zařízení a notebooky v síti.
Backend představuje průchozí kanál zpráv mezi front-endem a Raspberry Pi, založený na technologii websocket (http přes tcp protokol).
Prvním krokem je získání zpracovaných informací z Raspberry, tedy predikty zabalena v jsonu, které jsou uprostřed své cesty ukládány do databáze, aby bylo možné vytvářet statistiky o emočním pozadí uživatele za určité období. Následně je tento balík odeslán na frontend, který využívá odběr a příjem balíků z webhooku. Celý mechanismus backendu je postaven v jazyce golang, volba padla na něj, protože se dobře hodí pro asynchronní úkoly, s nimiž si gorutiny dobře poradí.
Při přístupu na endpoint se uživatel registruje a je zapsán do struktury, poté dochází k příjmu jeho zprávy. Jak uživatel, tak zpráva jsou zapsány do společného hubu, odkud jsou zprávy posílány dál (na přihlášený front-end), a pokud uživatel uzavře spojení (Raspberry nebo front-end), jeho odběr je zrušen a je odstraněn z hubu.
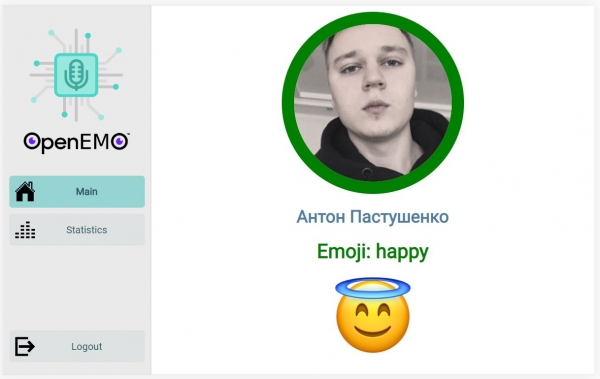
Očekáváme spojení s backendemFront-end je webová aplikace napsaná v JavaScriptu s využitím knihovny React pro urychlení a zjednodušení procesu vývoje. Cílem této aplikace je vizualizace dat získaných pomocí algoritmů spuštěných na back-endu a přímo na Raspberry Pi. Na stránce je implementováno routování sekcí pomocí react-router, avšak hlavní zájem představuje hlavní stránka, kde v reálném čase přichází nepřetržitý tok dat ze serveru pomocí technologie WebSocket. Raspberry Pi detekuje hlas, určuje příslušnost k určité osobě z registrované databáze a zasílá seznam pravděpodobnosti klientovi. Klient zobrazuje poslední aktuální data, vykresluje avatar osoby, která s největší pravděpodobností mluvila do mikrofonu, a také emoci, se kterou pronáší slova.

Hlavní stránka s aktualizovanými predikcemiZávěr
Nepodařilo se dokončit všechno podle plánu, prostě jsme to nestihli, takže hlavní naděje byla v demu, že všechno bude fungovat. Na prezentaci jsme mluvili o tom, jak to celé funguje, jaké modely jsme použili, s jakými problémy jsme se setkali. Poté byla část dema — experti se pohybovali po sále v libovolném pořadí a přicházeli k jednotlivým týmům, aby se podívali na funkční prototyp. Kladili nám otázky, každý odpovídal na svou část, na notebooku jsme nechali web a všechno opravdu fungovalo, jak se očekávalo.
Rád bych poznamenal, že celkové náklady na naše řešení činily 150$:
- Raspberry Pi 3 ~ 35$
- Google AIY Voice Bonnet (můžete použít desku respeaker) ~ 15$
- Intel NCS 2 ~ 100$
Jak zlepšit:
- Používat registraci z klienta — požádat o přečtení textu, který generujeme náhodně
- Přidat ještě několik modelů: podle hlasu lze určit pohlaví a věk
- Oddělovat současně znějící hlasy (diarizace)
Repozitář:

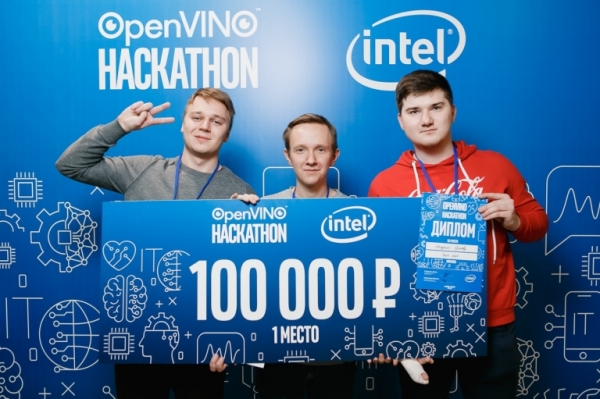
Unavení, ale šťastní jsmeNa závěr bych chtěl poděkovat organizátorům a účastníkům. Z projektů ostatních týmů se nám osobně líbilo řešení pro monitoring volných parkovacích míst. Pro nás to byla neuvěřitelně skvělá zkušenost ponoření do produktu a vývoje. Doufám, že v regionech se bude konat stále více zajímavých akcí, včetně těch na téma AI.
Zdroj: habr.com
