

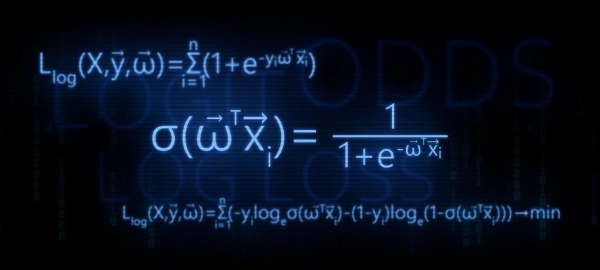
V tomto článku se budeme zabývat teoretickými základy transformace funkce lineární regrese v funkci inverzní logitní transformace (jinak také funkci logistické odezvy). Poté využijeme arsenal metody maximální věrohodnosti, v souladu s modelem logistické regrese odvodíme ztrátovou funkci Logistic Loss, neboli jinými slovy, určíme funkci, pomocí které se v modelu logistické regrese vybírají parametry vektoru vah  .
Plán článku:
- Zopakujeme si lineární závislost mezi dvěma proměnnými
- Identifikujeme potřebu transformace funkce lineární regrese
 v funkce logistické odezvy
- Provádíme transformace a odvodíme funkce logistické odezvy
- Pokud se pokusíme pochopit, čím je metoda nejmenších čtverců při odhadu parametrů špatná funkce Logistic Loss
- Používáme metoda maximální věrohodnosti za účelem určení funkce odhadu parametrů :
5.1. Případ 1: funkce Logistic Loss pro objekty s označením tříd 0 a 1:
5.2. Případ 2: funkce Logistic Loss pro objekty s označením tříd -1 a +1:
 v funkce logistické odezvy

 funkce Logistic Loss
 :


Článek bohatě obsahuje jednoduché příklady, u kterých lze všechny výpočty snadno provést ústně nebo na papíře, v některých případech může být zapotřebí kalkulačka. Připravte se 🙂
Tento článek je především určen pro datové vědce se základními znalostmi v oblasti strojového učení.
V článku bude také uveden kód pro vykreslování grafů a výpočty. Všechen kód je napsán v jazyce python 2.7. Předem vysvětlím „novost“ používané verze — to je jedno z podmínek účasti v známém kurzu od Yandexu na ne méně známé internetové platformě online vzdělávání Coursera, a jak bylo možné předpokládat, materiál byl připraven na základě tohoto kurzu.
01. Lineární závislost
Je docela rozumné položit otázku — co mají společného lineární závislost a logistická regrese?
Všechno je jednoduché! Logistická regrese je jedním z modelů, které patří k lineárnímu klasifikátoru. Jednoduše řečeno, úkolem lineárního klasifikátoru je předpovídat cílové hodnoty  z proměnných (regresorů)
 . Předpokládá se, že závislost mezi znaky
 a cílovými hodnotami
 je lineární. Odtud vlastně název klasifikátoru — lineární. Pokud bychom to velmi hrubě zjednodušili, model logistické regrese vychází z předpokladu lineární závislosti mezi znaky
 a cílovými hodnotami
 . Tady je — spojení.
V studiu je první příklad, a o přímé závislosti zkoumaných veličin. Při přípravě článku jsem narazil na příklad, který je již mnohým známý - závislost proudu na napětí. („Aplikovaná regresní analýza“, N. Draper, G. Smith). Zde se na něj také podíváme.
V souladu s Ohmův zákon:
 , kde
 — proud,
 — napětí,
 — odpor.
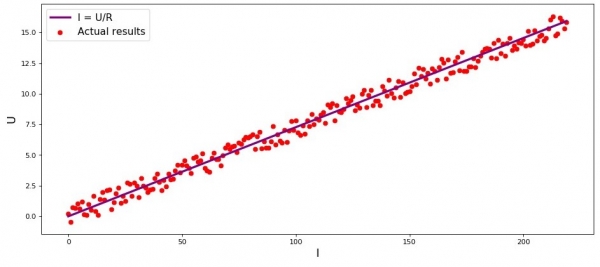
Kdybychom neznali Ohmův zákon, mohli bychom závislost nalézt empiricky, měnící  a měřící
 , přičemž
 bychom udržovali konstantní. Pak bychom viděli, že graf závislosti
 od
 vykazuje více či méně přímou čáru procházející počátkem souřadnic. Řekli jsme „více či méně“, protože ačkoli je závislost skutečně přesná, naše měření mohou obsahovat malé chyby, a proto body na grafu možná nebudou na čáře, ale budou kolem ní náhodně rozptýlené.
Graf 1 „Závislost  od
 »
Kód pro vykreslení grafu
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Skutečné výsledky')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Nezbytnost transformací rovnice lineární regrese
Podívejme se na další příklad. Představme si, že pracujeme v bance a máme za úkol určit pravděpodobnost vrácení úvěru dlužníkem v závislosti na některých faktorech. Pro zjednodušení úkolu zvažme pouze dva faktory: měsíční plat dlužníka a měsíční výši splátky úvěru.
Úkol je velmi hypotetický, ale na tomto příkladu pochopíme, proč k jeho vyřešení nestačí použít funkce lineární regrese, a také se dozvíme, které transformace s funkcí je třeba provést.
Vracíme se k příkladu. Je jasné, že čím vyšší je mzda, tím více může dlužník měsíčně směřovat na splácení úvěru. Přitom pro určité rozmezí mezd bude tato závislost zcela lineární. Například vezmeme rozpětí mezd od 60,000 Kč do 200,000 Kč a předpokládáme, že v uvedeném rozpětí mezd je závislost velikosti měsíční splátky na velikosti mzdy lineární. Předpokládejme, že bylo zjištěno, že poměr mzdy k platbě nemůže klesnout pod 3 a dlužníkovi by mělo zůstat alespoň 5,000 Kč. A pouze v takovém případě budeme považovat, že dlužník splatí úvěr bance. Pak bude rovnice lineární regrese mít tuto podobu:

kde  ,
 ,
 ,
 — mzda
 -ého dlužníka,
 — splátka úvěru
 -ého dlužníka.
Dosazením mzdy a splátky úvěru s pevnými parametry  můžeme rozhodnout o poskytnutí či zamítnutí úvěru.
Předbíháme, ale poznamenáme, že za daných parametrů  funkce lineární regrese, aplikovaná v logistické regresi bude vykazovat vysoké hodnoty, které ztíží výpočty pro určení pravděpodobností splácení úvěru. Proto navrhujeme snížit naše koeficienty, řekněme o 25,000 krát. Tato transformace v koeficientech nezmění rozhodnutí o poskytnutí úvěru. Zapamatujme si tento moment do budoucna, a nyní, aby bylo ještě jasnější, o čem je řeč, zvažme situaci se třemi potenciálními dlužníky.
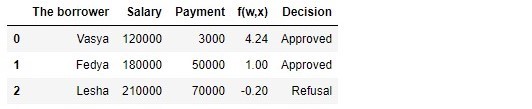
Tabulka 1 „Potenciální dlužníci“
Kód pro vytvoření tabulky
import pandas as pd

r = 25000.0
w_0 = -5000.0/r
w_1 = 1.0/r
w_2 = -3.0/r

data = {'Dlužník':np.array(['Vasya', 'Fedya', 'Lesha']),
        'Mzda':np.array([120000,180000,210000]),
       'Splátka':np.array([3000,50000,70000])}

df = pd.DataFrame(data)

df['f(w,x)'] = w_0 + df['Mzda']*w_1 + df['Splátka']*w_2

decision = []
for i in df['f(w,x)']:
    if i > 0:
        dec = 'Schváleno'
        decision.append(dec)
    else:
        dec = 'Odmítnuto'
        decision.append(dec)

df['Rozhodnutí'] = decision

df[['Dlužník', 'Mzda', 'Splátka', 'f(w,x)', 'Rozhodnutí']]
Podle údajů v tabulce, Vasya se mzdu 120,000 Kč chce získat takový úvěr, aby mohl měsíčně splácet 3,000 Kč. Bylo určeno, že pro schválení úvěru musí být výše mzdy Vasya trojnásobně vyšší než výše splátky, a také mu musí zbýt 5,000 Kč. Tuto podmínku Vasya splňuje:  . Zůstává dokonce 106.000 Kč. I když jsme při výpočtu
 snížili koeficienty
 25.000krát, výsledky jsou stejné — úvěr může být schválen. Fedia také dostane úvěr, ale Alexej, přestože vydělává nejvíc, si bude muset zmírnit své požadavky.
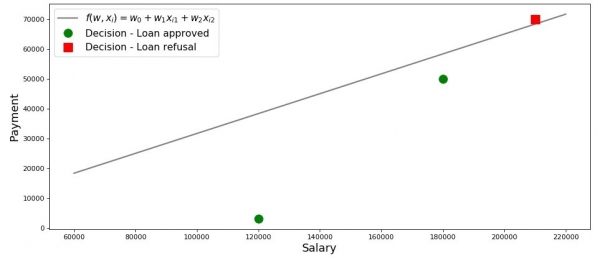
Nakreslíme graf pro tuto příležitost.
Graf 2 „Klasifikace dlužníků“
Kód pro vykreslení grafu
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'], 'o', color ='green', markersize = 12, label = 'Rozhodnutí - Úvěr schválen')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'], 's', color = 'red', markersize = 12, label = 'Rozhodnutí - Úvěr odmítnut')
plt.xlabel('Plat', size = 16)
plt.ylabel('Platba', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Takže naše přímka, postavená dle funkce  , odděluje „špatné“ dlužníky od „dobrých“. Ti dlužníci, jejichž přání se neshodují s možnostmi, jsou nad přímkou (Alexej), ti, kteří podle parametrů našeho modelu mohou splatit úvěr, jsou pod přímkou (Václav a Fedia). Jinak řečeno, naše přímka rozděluje dlužníky do dvou tříd. Označíme je následovně: do třídy
 zařadíme ty dlužníky, kteří pravděpodobně splatí úvěr, do třídy
 nebo
 zařadíme ty dlužníky, kteří pravděpodobně nebudou schopni splatit úvěr.
Shrneme závěry z tohoto jednoduchého příkladu. Vezmeme bod  a dosazením souřadnic bodu do příslušné rovnice přímky
 , prozkoumáme tři varianty:
- Pokud se bod nachází pod přímkou a my ho zařadíme do třídy , pak hodnota funkce bude kladná z do . Tedy můžeme považovat, že pravděpodobnost splácení úvěru se nachází v rozmezí . Čím větší je hodnota funkce, tím vyšší je pravděpodobnost.
- Pokud se bod nachází nad přímkou a my ho zařadíme do třídy nebo , pak hodnota funkce bude záporná z do . Pak budeme považovat, že pravděpodobnost splácení úvěru se nachází v rozmezí a čím větší je absolutní hodnota funkce, tím větší je naše jistota.
- Bod se nachází na přímce, na hranici mezi dvěma třídami. V takovém případě bude hodnota funkce rovna a pravděpodobnost splácení úvěru je rovna .
 , pak hodnota funkce
 bude kladná z
 do
 . Tedy můžeme považovat, že pravděpodobnost splácení úvěru se nachází v rozmezí
 . Čím větší je hodnota funkce, tím vyšší je pravděpodobnost.
 nebo
 , pak hodnota funkce bude záporná z
 do
 . Pak budeme považovat, že pravděpodobnost splácení úvěru se nachází v rozmezí
 a čím větší je absolutní hodnota funkce, tím větší je naše jistota.
 rovna
 a pravděpodobnost splácení úvěru je rovna
 .
Nyní si představme, že máme ne dva faktory, ale desítky, dlužníků ne tři, ale tisíce. Pak místo přímky budeme mít m-rozměrná rovina a koeficienty  budeme brát nikoli z ničeho, ale budeme je odvodit podle všech pravidel, a to na základě nasbíraných údajů o dlužnících, kteří splatili nebo nesplatili úvěr. A skutečně, uvědomte si, nyní vybíráme dlužníky na základě již známých koeficientů.
 . Ve skutečnosti úkolem modelu logistické regrese je určit parametry
 , při kterých se hodnota ztrátové funkce Logistic Loss snaží minimalizovat. O tom, jak se počítá vektor
 , se ještě dozvíme v 5. části článku. A zatím se vraťme na zaslíbenou zem — k našemu bankéři a třem jeho klientům.
Díky funkci  víme, komu můžeme poskytnout úvěr, a komu je třeba odmítnout. Ale s takovými informacemi se k řediteli jít nedá, protože chtěli získat pravděpodobnost splacení úvěru pro každého dlužníka. Co dělat? Odpověď je jednoduchá — musíme nějak přeformulovat funkci
 , jejíž hodnoty leží v rozmezí
 na funkci, jejíž hodnoty budou ležet v rozmezí
 . A taková funkce existuje, nazývá se logistickou odpovědní funkcí nebo inverzním logitovým převodem. Seznamte se:

Podívejme se krok za krokem, jak vzniká logistická odpovědní funkce. Všimněme si, že budeme kráčet zpět, tj. předpokládáme, že známe hodnotu pravděpodobnosti, která leží v rozmezí  do
 , a potom budeme "rozkrývat" tuto hodnotu na celé oblasti čísel od
 do
 .
03. Vytváříme logistickou odpovědní funkci
Krok 1. Převedeme hodnoty pravděpodobnosti do rozmezí

Na dobu transformace funkce  v funkce logistické odezvy
 zanecháme na pokoji našeho úvěrového analytika, a místo toho se podíváme na sázkové kanceláře. Ne, samozřejmě, nesázíme, vše, co nás tam zajímá, je smysl výrazu, například šance 4 k 1. Šance, které jsou známé všem hráčům, kteří sází, jsou poměrem "úspěchů" k "neúspěchům". Z pohledu pravděpodobnosti jsou šance pravděpodobností výskytu události dělenou pravděpodobností, že k události nedojde. Zapišme vzorec pro šanci výskytu události
 :

, kde  — pravděpodobnost výskytu události,
 — pravděpodobnost NE výskytu události
Například, pokud je pravděpodobnost, že mladý, silný a hbitý kůň přezdívaný "Větrník" předběhne ve závodech starou a ochablou babičku jménem "Matilda", rovna  , šance na úspěch „Veterka“ tedy budou
 k

 a naopak, pokud známe šance, nebude pro nás problém vypočítat pravděpodobnost
 :

Tímto jsme se naučili „převádět“ pravděpodobnost na šance, které nabývají hodnot od  do
 . Udělejme ještě jeden krok a naučíme se „převádět“ pravděpodobnost na celou číslicovou přímku od
 do
 .
Krok 2. Převodíme hodnoty pravděpodobnosti do rozsahu

Tento krok je velmi jednoduchý - zlogaritmujeme šance na základě čísla Euler  a dostaneme:

Nyní víme, že pokud  , pak vypočítání hodnoty
 bude velmi snadné a navíc by mělo být kladné:
 . Odpovídá tomu.
Pro zajímavost zkontrolujeme, že pokud  , pak očekáváme, že uvidíme zápornou hodnotu
 . Kontrolujeme:
 . Vše je v pořádku.
Nyní víme, jak převést hodnotu pravděpodobnosti od  do
 na celou číslicovou přímku od
 do
 . V následujícím kroku uděláme přesně opak.
A zatím si poznamenejme, že podle pravidel logaritmování, pokud známe hodnotu funkce  , lze vypočítat šance:

Tento způsob určení šancí nám přijde vhod v následujícím kroku.
Krok 3. Odvodíme vzorec pro určení

Takže jsme se naučili, že známe  , nacházet hodnoty funkce
 . Ve skutečnosti však potřebujeme všechny právě opačně - znát hodnotu
 najít
 . K tomu se obrátíme na takový pojem jako inverzní funkce šancí, podle které:

V článku nebudeme odvozovat výše uvedený vzorec, ale otestujeme na číslech z výše uvedeného příkladu. Víme, že při šancích rovných 4 k 1 ( ), pravděpodobnost nastání události je rovna 0.8 (
 ). Uděláme substituci:
 . To odpovídá našim výpočtům provedeným dříve. Pokračujeme dále.
V předchozím kroku jsme odvodili, že  , a tedy lze provést substituci v inverzní funkci šancí. Dostaneme:

Rozdělíme jak čitatel, tak jmenovatel na  , pak:

Pro všechny případy, abychom se ujistili, že jsme nikde neudělali chybu, uděláme ještě jednu malou kontrolu. V kroku 2 jsme pro  určili, že
 . Pak, pokud dosadíme hodnotu
 do funkce logistické odezvy, očekáváme, že dostaneme
 . Dosazujeme a dostáváme:

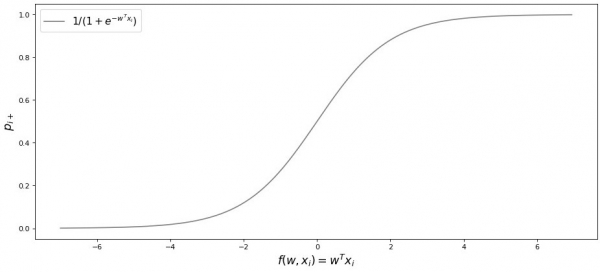
Gratuluji vám, vážený čtenáři, právě jsme odvodili a otestovali funkci logistické odezvy. Podívejme se na graf této funkce.
Graf 3 „Funkce logistické odezvy“
Kód pro vykreslení grafu
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
V literatuře se také můžete setkat s názvem této funkce jako sigmoidní funkce. Z grafu je zřejmé, že hlavní změna pravděpodobnosti příslušnosti objektu k třídě probíhá v relativně malém rozsahu  , někde od
 do
 .
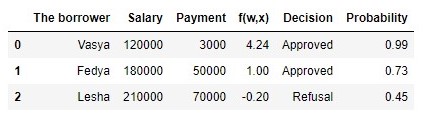
Navrhuji se vrátit k našemu úvěrovému analytikovi a pomoci mu s výpočtem pravděpodobnosti splacení úvěrů, jinak riskuje, že zůstane bez prémie 🙂
Tabulka 2 „Potenciální dlužníci“
Kód pro vytvoření tabulky
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probability'] = proba

df[['The borrower', 'Salary', 'Payment', 'f(w,x)', 'Decision', 'Probability']]
Takže pravděpodobnost vrácení úvěru jsme určili. Celkově to vypadá jako pravda.
Opravdu, pravděpodobnost, že Vašek při platu 120.000 Kč bude moci měsíčně splácet 3.000 Kč bance, se blíží 100%. Mimochodem, musíme si uvědomit, že banka může poskytnout úvěr i Leškovi, pokud je v politice banky stanoveno, že například úvěrují klienty s pravděpodobností vrácení úvěru přes 0,3. V tomto případě si banka vytvoří větší rezervy na možné ztráty.
Je také třeba poznamenat, že poměr platu k platbě nejméně 3 a s rezervou 5.000 Kč byl vzat z prstu. Proto jsme nemohli použít v původní podobě vektor vah  . Bylo nutné výrazně snížit koeficienty, a proto jsme každý koeficient rozdělili na 25.000, tedy v podstatě jsme upravili výsledek. To bylo provedeno záměrně, aby se usnadnilo pochopení materiálu v úvodní fázi. V reálném životě však budeme muset koeficienty skutečně hledat a nikoli si je vymýšlet. Právě v následujících částech článku odvodíme rovnice, pomocí kterých se vybírají parametry
 .
04. Metoda nejmenších čtverců při určování vektoru vah ve funkci logistické odpovědi
 ve funkci logistické odpovědi
Tato metoda výběru vektoru vah nám již byla známa  , jako metoda nejmenších čtverců (MNK) a vlastně, proč bychom ji nemohli použít v úlohách binární klasifikace? Opravdu, nic nebrání použití MNK, jenže tento způsob v úlohách klasifikace poskytuje méně přesné výsledky než Logistic LossTomu je teoretické zdůvodnění. Pojďme se nejprve podívat na jeden jednoduchý příklad.
Předpokládejme, že naše modely (používající MSE a Logistic Loss) již začaly optimalizaci vektoru váh  a my jsme zastavili výpočet v nějakém kroku. Nezáleží na tom, zda v polovině, na konci nebo na začátku, hlavní je, že už máme nějaké hodnoty vektoru váh a předpokládejme, že v tomto kroku, vektory váh
 pro oba modely nemají rozdíly. Pak vezmeme získané váhy a použijeme je v funkce logistické odezvy (
 ) pro nějaký objekt, který patří do třídy
 . Prozkoumejme dva případy, kdy podle optimalizovaného vektoru váh naše model značně chybí a naopak — model je velmi přesvědčen, že objekt patří do třídy
 . Podíváme se, jaké penalizace budou "uděleny" při použití MNK a Logistic Loss.
Kód pro výpočet penalizací v závislosti na použité funkci ztrát
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Případ s hrubou chybou — model přiřazuje objekt k třídě  s pravděpodobností 0,01
Penalizace při použití MNK bude:

Penalizace při použití Logistic Loss bude:

Případ s silnou jistotou — model přiřazuje objekt k třídě  s pravděpodobností 0,99
Penalizace při použití MNK bude:

Penalizace při použití Logistic Loss bude:

Tento příklad dobře ilustruje, že při hrubé chybě funkce ztrát Log Loss penalizuje model výrazně silněji než MSE. Nyní si pojďme objasnit, jaké jsou teoretické předpoklady pro použití funkce ztrát Log Loss v úlohách klasifikace.
05. Metoda maximální věrohodnosti a logistická regrese
Jak bylo slíbeno na začátku, článek je plný jednoduchých příkladů. Ve studiu další příklad a staré známé — bankovní dlužníci: Vaša, Fedia a Leša.
Na každém kroku, před tím, než rozvineme příklad, připomenu, že v životě máme na starosti tréninkovou vzorku z tisíců nebo milionů objektů s desítkami nebo stovkami znaků. Avšak zde jsou čísla zvolena tak, aby se snadno vešla do hlavy začínajícího datového vědce.
Vrátíme se k příkladu. Představme si, že ředitel banky se rozhodl poskytnout půjčku všem potřebným, i když algoritmus naznačoval, že by ji neměl poskytnout Alexovi. A tak uplynul dostatečný čas a dozvěděli jsme se, kdo ze tří hrdinů půjčku splatil a kdo ne. Což jsme očekávali: Vašek a Franta půjčku splatili, ale Alex ne. Nyní si představme, že tento výsledek bude pro nás novou tréninkovou sadou a přitom máme, jako by, všechny údaje o faktorech ovlivňujících pravděpodobnost splácení půjčky (plat dlužníka, výše měsíční splátky) jakoby zmizelé. Intuitivně bychom tedy mohli předpokládat, že každý třetí dlužník nevrací půjčku bance, jinými slovy pravděpodobnost, že další dlužník vrátí půjčku, je  . Tomuto intuitivnímu předpokladu je teoretické potvrzení a zakládá se na metodě maximální věrohodnosti, v literatuře se často nazývá principem maximální věrohodnosti.
Na začátek se seznámíme s pojmovým aparátem.
Věrohodnost vzorku je pravděpodobnost získání právě takového vzorku, získání právě takových pozorování / výsledků, tj. součin pravděpodobností získání každého jednotlivého výsledku vzorku (například splácení nebo nesplácení půjčky Vaškem, Frantou a Alexem současně).
Funkce věrohodnosti spojišťuje věrohodnost vzorku s hodnotami parametrů rozdělení.
V našem případě tréninkový vzorek představuje zobecněnou Bernoulliho schéma, ve které náhodná veličina nabývá pouze dvou hodnot:  nebo
 . Proto lze věrohodnost vzorku zapsat jako funkci věrohodnosti ohledně parametru
 následujícím způsobem:


Výše uvedený zápis lze interpretovat takto. Společná pravděpodobnost toho, že Vašek a Franta splatí půjčku, je rovna  , pravděpodobnost, že Alex půjčku NESPLATÍ, je rovna
 (protože skutečně došlo k NESPLACENÍ půjčky), proto společná pravděpodobnost všech tří událostí je rovna
 .
Metoda maximální věrohodnosti je metodou odhadu neznámého parametru pomocí maximalizace funkce věrohodnosti. V našem případě je nutné najít takovou hodnotu  , při které
 dosahuje maxima.
Odkud vlastně pochází myšlenka hledat hodnotu neznámého parametru, při které dosahuje pravděpodobnostní funkce maxima? Kořeny této myšlenky pramení z přesvědčení, že vzorek je jediným dostupným zdrojem znalostí o základním souboru. Vše, co víme o základním souboru, je prezentováno ve vzorku. Proto vše, co můžeme říci, je, že vzorek je nejpřesnější odraz základního souboru, který máme k dispozici. Takže potřebujeme najít takový parametr, při kterém se existující vzorek stává nejpravděpodobnějším.
Je zřejmé, že čelíme optimalizační úloze, ve které je třeba najít bod extrému funkce. Pro nalezení bodu extrému je nutné zvážit podmínku prvního řádu, tedy srovnat derivaci funkce s nulou a vyřešit rovnici vůči hledanému parametru. Nicméně hledání derivace výrobku velkého počtu faktorů může být zdlouhavé, takže k tomu existuje zvláštní metoda — přechod k logaritmu. funkce věrohodnosti. Proč je takový přechod možný? Všimněme si, že nehledáme samotný extrém funkce , ale bod extrému, tedy tu hodnotu neznámého parametru
 , při které
 která dosahuje maxima. Při přechodu k logaritmu se bod extrému nemění (i když samotný extrém se bude lišit), protože logaritmus je monotónní funkce.
Pojďme tedy, v souladu s výše uvedeným, pokračovat v rozvíjení našeho příkladu s půjčkami u Vaši, Fedy a Leši. Nejprve přejdeme k logaritmu pravděpodobnostní funkce:

Nyní můžeme snadno diferencovat výraz podle  :

A konečně, zvažme podmínku prvního řádu — srovnáme derivaci funkce s nulou:

Tím pádem naše intuitivní ocenění pravděpodobnosti splacení půjčky  bylo teoreticky podloženo.
Skvěle, ale co teď s takovými informacemi? Pokud budeme předpokládat, že každý třetí dlužník nevrátí bance peníze, pak banka nevyhnutelně zkrachuje. To je sice pravda, ale při ocenění pravděpodobnosti splacení půjčky jako jedné ze tří  Nepřihlédli jsme k faktorům ovlivňujícím splácení úvěru: mzda dlužníka a výše měsíční splátky. Připomeňme, že jsme dříve spočítali pravděpodobnost splácení úvěru od každého klienta s ohledem na tyto faktory. Je logické, že pravděpodobnosti se ukázaly jako odlišné od konstanty rovné
 .
Určeme pravděpodobnost vzorků:
Kód pro výpočty pravděpodobností vzorků
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Pravděpodobnost vzorku při konstantní hodnotě p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Pravděpodobnost vzorku při vypočítané hodnotě p:', round(likelihood(y,p_log_response),3)
Pravděpodobnost vzorku při konstantní hodnotě  :

Pravděpodobnost vzorku při výpočtu pravděpodobnosti splácení úvěru s ohledem na faktory  :


Pravděpodobnost vzorku s pravděpodobností vypočítanou na základě faktorů byla vyšší než pravděpodobnost při konstantní hodnotě pravděpodobnosti. Co to znamená? Znamená to, že znalosti o faktorech umožnily lépe přizpůsobit pravděpodobnost splácení úvěru pro každého klienta. Proto by při půjčování dalšího úvěru bylo správnější použít model hodnocení pravděpodobnosti splácení dluhu, který byl navržen na konci 3. části článku.
Ale pokud potřebujeme maximalizovat funkci pravděpodobnosti vzorku, proč tedy nepoužít nějaký algoritmus, který by vám vykázal pravděpodobnosti pro Vašu, Fedu a Lešu, například rovné 0.99, 0.99 a 0.01. Možná se takový algoritmus dobře osvědčí na trénovací sadě, protože přiblíží hodnotu pravděpodobnosti vzorku k  , ale za prvé, takový algoritmus pravděpodobně narazí na problémy s generalizací, a za druhé, tento algoritmus určitě nebude lineární. A pokud metody boje proti přeúčení (tedy slabá generalizační schopnost) jasně nejsou součástí plánu tohoto článku, pak bychom se k druhému bodu měli podívat podrobněji. K tomu stačí odpovědět na jednoduchou otázku. Může být pravděpodobnost splácení úvěru u Vaši a Fedy stejná s ohledem na nám známé faktory? Z hlediska zdravého rozumu samozřejmě nemůže, nemůže. Tak na splácení úvěru bude Vaša odvádět 2,5 % své mzdy měsíčně, zatímco Feda — téměř 27,8 %. Také v grafu 2 'Klasifikace klientů' vidíme, že Vaša je výrazně dál od linie, která odděluje třídy, než Feda. A nakonec víme, že funkce
 pro Vašu a Fedu přijímá různé hodnoty: 4,24 pro Vašu a 1,0 pro Fedu. Kdyby například Feda vydělával o řád více nebo si žádal o menší úvěr, pak by pravděpodobnosti splácení úvěru u Vaši a Fedy byly podobné. Jinými slovy, lineární závislost se nedá oklamat. A kdybychom skutečně spočítali koeficienty
 , a nebrali je z prstu, mohli bychom s jistotou prohlásit, že naše hodnoty
 nejlépe umožňují posoudit pravděpodobnost splácení úvěru každým dlužníkem, ale protože jsme se dohodli, že stanovení koeficientů
 bylo provedeno podle všech pravidel, budeme to tak považovat — naše koeficienty umožňují poskytnout nejlepší odhad pravděpodobnosti 🙂
Nicméně jsme se odvrátili. V této části se musíme vyjasnit, jak je určován vektor vah  , který je nezbytný pro hodnocení pravděpodobnosti návratu úvěru každým dlužníkem.
Stručně shrnujeme, s jakým arzenálem vystupujeme na hledání koeficientů  :
1. Předpokládáme, že závislost mezi cílovou proměnnou (predikovanou hodnotou) a faktorem, který ovlivňuje výsledek — je lineární. Z tohoto důvodu se používá funkce lineární regrese tvaru  , jehož čára dělí objekty (klienty) na třídy
 a
 nebo
 (klienti schopní splatit úvěr a neschopní). V našem případě má rovnice tvar
 .
2. Používáme funkci inverzního logit-transformace tvaru  pro určení pravděpodobnosti příslušnosti objektu k třídě
 .
3. Zvažujeme naši tréninkovou sadu jako realizaci generalizované Bernoulliho schémata, to znamená, že pro každý objekt se generuje náhodná veličina, která s pravděpodobností  (svou pro každý objekt) nabývá hodnoty 1 a s pravděpodobností
 – 0.
4. Víme, že je potřeba maximalizovat funkci pravděpodobnosti vzorku s ohledem na přijaté faktory, aby byla stávající vzorka co nejpravděpodobnější. Jinými slovy, musíme nalézt takové parametry, při kterých bude vzorka nejpraviपodobnější. V našem případě hledaný parametr je pravděpodobnost splacení úvěru  , která závisí na neznámých koeficientech
 . To znamená, že musíme najít takový vektor vah
 , při kterém bude pravděpodobnost vzorky maximální.
5. Víme, že pro maximalizaci funkce pravděpodobnosti vzorky může být použit metoda maximální věrohodnosti. A známe všechny chuťové triky pro práci s touto metodou.
Jedná se o takovou složitou situaci 🙂
A nyní si připomeňme, že na začátku článku jsme chtěli odvodit dva typy funkce ztrát Logistic Loss v závislosti na tom, jak jsou třídy objektů označeny. V klasifikačních úlohách se dvěma třídami se třídy označují jako  a
 nebo
 . V závislosti na označení bude vygenerována odpovídající funkce ztrát.
Případ 1. Klasifikace objektů na a
 a

Dříve, při určování pravděpodobnosti vzorky, kde byla pravděpodobnost splacení dluhu dlužníkem vypočítána na základě faktorů a zadaných koeficientů  , jsme použili vzorec:

Ve skutečnosti  — to je hodnota funkce logistické odezvy
 při daném vektoru vah

Pak nás nic nebrání zapsat funkci pravděpodobnosti vzorky takto:

Někdy je pro začínající analytiky obtížné hned chápat, jak tato funkce funguje. Podívejme se na 4 krátké příklady, které vše objasní:
1. Pokud  (tj. podle tréninkového vzorku objekt patří do třídy +1), a náš algoritmus
 určuje pravděpodobnost přiřazení objektu do třídy
 rovnou 0.9, tak tento kousek pravděpodobnosti vzorky se vypočítá takto:

2. Pokud  , a
 , pak bude výpočet takový:

3. Pokud  , a
 , pak bude výpočet takový:

4. Pokud  , a
 , pak bude výpočet takový:

Je zřejmé, že funkce pravděpodobnosti bude maximalizována v případech 1 a 3, nebo obecně při správně uhádnutých hodnotách pravděpodobnosti přiřazení objektu do třídy  .
Vzhledem k tomu, že při určení pravděpodobnosti přiřazení objektu do třídy  neznáme pouze koeficienty
 , tak je budeme hledat. Jak již bylo řečeno, jedná se o problematiku optimalizace, kde nejprve potřebujeme najít derivaci funkce pravděpodobnosti podle vektoru vah
 . Přesto má smysl nejprve si úlohu zjednodušit: derivaci budeme hledat od logaritmu funkce věrohodnosti.

Proč po logaritmizaci, v funkci logistické chyby, jsme změnili znaménko s  na
 . To je jednoduché, protože v úlohách hodnocení kvality modelu je obvyklé minimalizovat hodnotu funkce, proto jsme pravou stranu výrazu vynásobili
 a nyní místo maximalizace minimalizujeme funkci.
Vlastně, právě na vašich očích byla obtížně odvozena ztrátová funkce — Logistic Loss pro tréninkovou sadu se dvěma třídami:  a
 .
Nyní, pro nalezení koeficientů, nám stačí najít derivaci funkci logistické chyby a dále, pomocí numerických optimalizačních metod, jako je gradientní sestup nebo stochastický gradientní sestup, vyladit nejoptimálnější koeficienty  . Ale s ohledem na již nemalý objem článku se navrhuje provést diferenciaci samostatně, nebo možná to bude téma pro další článek s větším množstvím aritmetiky bez tak podrobných příkladů.
Případ 2. Klasifikace objektů na a
 a

Přístup zde bude stejný jako u tříd  a
 , ale sama cesta k odvození ztrátové funkce Logistic Loss, bude složitější. Začneme. Pro funkci pravděpodobnosti použijeme operátor „pokud…, pak…“. To znamená, že pokud
 -ý objekt patří k třídě
 , pro výpočet pravděpodobnosti vzorku použijeme pravděpodobnost
 , pokud objekt patří k třídě
 , do pravděpodobnosti dosadíme
 . Takto vypadá funkce pravděpodobnosti:

Vysvětlíme si to na prstech. Zvažme 4 případy:
1. Pokud  a
 , pak do pravděpodobnosti vzorku „půjde“

2. Pokud  a
 , pak do pravděpodobnosti vzorku „půjde“

3. Pokud  a
 , pak do pravděpodobnosti vzorku „půjde“

4. Pokud  a
 , pak do pravděpodobnosti vzorku „půjde“

Je zřejmé, že v 1. a 3. případě, kdy byly pravděpodobnosti správně určeny algoritmem, funkce pravděpodobnosti bude maximalizována, to znamená, že přesně to jsme chtěli získat. Nicméně, tento přístup je dost nepraktický a nyní se podíváme na kompaktnější zápis. Ale nejprve logaritmizujeme funkci pravděpodobnosti se změnou znaménka, protože nyní ji budeme minimalizovat.

Dosadíme místo  výraz
 :

Zjednodušíme pravý člen pod logaritmem pomocí jednoduchých aritmetických metod a získáme:

A nyní nastal čas zbavit se operátoru „pokud…, pak…“. Všimněme si, že když objekt  patří do třídy
 , pak ve výrazu pod logaritmem, ve jmenovateli,
 se umocňuje
 , pokud objekt patří k třídě
 , takže $e$ se umocňuje
 . Proto lze zápis exponentu zjednodušit - sloučit oba případy do jednoho:
 . Pak funkce logistické chyby bude mít tvar:

Podle pravidel logaritmování převrátíme zlomky a vyvedeme znak " " (mínus) za logaritmus, dostaneme:

Před vámi je funkce ztráty logistic Loss, která se používá v tréninkovém souboru s objekty patřícími do tříd:  a
 .
Což je v této chvíli vše, sbohem a končíme článek.
Předchozí práce autora - „Převádíme rovnici lineární regrese do maticového tvaru“
Doplňkové materiály
1. Literatura
1) Aplikovaná regresní analýza / N. Draper, G. Smith – 2. vyd. – M.: Finance a statistika, 1986 (překlad z angličtiny)
2) Teorie pravděpodobnosti a matematická statistika / V. E. Gmurman — 9. vyd. — M.: Vysoká škola, 2003
3) Teorie pravděpodobnosti / N. I. Černova — Novosibirsk: Novosibirská státní univerzita, 2007
4) Podniková analytika: od dat k vědomostem / Paklin N. B., Oreškov V. I. — 2. vyd. — Petrohrad: Piter, 2013
5) Data Science věda o datech od nuly / Joel Grasz — Petrohrad: BHV Petersburg, 2017
6) Praktická statistika pro specialisty Data Science / P. Bruce, E. Bruce — Petrohrad: BHV Petersburg, 2018
2. Přednášky, kurzy (video)
1)
2)
3)
4)
5)
3. Internetové zdroje
1)
2)
3)
4)
5)
6)
7)
8)
Zdroj: habr.com
