

Ahoj, Habr!
Na podzim loňského roku proběhla na Kaggle soutěž v klasifikaci ručně kreslených obrázků Quick Draw Doodle Recognition, do které se mimo jiné zapojil tým R programátorů složený z , a . Podrobně nebudeme popisovat soutěž, to už bylo uděláno v .
S farmou medailí to tentokrát nevyšlo, ale získali jsme mnoho cenných zkušeností, a proto bychom chtěli sdílet několik nejzajímavějších a užitečných věcí z Kaggle i každodenní práce. Mezi probíranými tématy: nelehký život bez OpenCV, parsování JSON-ů (v těchto příkladech se zkoumá integrace kódu v C++ do skriptů nebo balíčků v R prostřednictvím Rcpp), parametrizace skriptů a dockerizace konečného řešení. Celý kód z tohoto příspěvku je dostupný ve spustitelné podobě v .
Obsah:
1. Efektivní načítání dat z CSV do databáze MonetDB
Data v této soutěži nejsou poskytována jako hotové obrázky, ale jako 340 CSV souborů (po jednom souboru na každou třídu), které obsahují JSON s koordináty bodů. Spojením těchto bodů liniemi získáme výsledný obrázek o rozměrech 256×256 pixelů. Také pro každý záznam je uvedena značka, zda byl obrázek správně rozpoznán klasifikátorem použitým v době sběru datasetu, dvoupísmenný kód země bydliště autora kresby, unikátní identifikátor, časová značka a název třídy, který odpovídá názvu souboru. Zjednodušená verze vstupních dat má velikost 7,4 GB v archivu a přibližně 20 GB po rozbalení, plná data po rozbalení zabírají 240 GB. Organizátoři zaručili, že obě verze reprodukují stejné kresby, což znamená, že plná verze je nadbytečná. V každém případě bylo uložení 50 milionů obrázků v grafických souborech nebo ve formě polí od začátku považováno za nerentabilní, a proto jsme se rozhodli sloučit všechny CSV soubory z archivu train_simplified.zip do databáze s následnou generací obrázků požadované velikosti „na počkání“ pro každou dávku.
Jako SGBD byla vybrána dobře osvědčená MonetDB, konkrétně implementace pro R ve formě balíčku . Balíček zahrnuje embedded verzi databázového serveru a umožňuje spustit server přímo z R sezení a tam s ním pracovat. Vytvoření databáze a připojení k ní se provádí jedním příkazem:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))Budeme potřebovat vytvořit dvě tabulky: jednu pro všechna data, druhou pro provozní informace o nahraných souborech (to se hodí, když něco nepůjde podle plánu a proces bude třeba obnovit po nahrání několika souborů):
Vytváření tabulek
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
Nejrychlejším způsobem nahrávání dat do DB se ukázalo přímé kopírování CSV souborů pomocí SQL — příkaz COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',', 'n', '"' NULL AS '' BEST EFFORT, kde Uživatelsky definované funkce odkazované v pohledu musí být vytvořeny pomocí — jméno tabulky a path — cesta k souboru. Při práci s archívem jsme zjistili, že integrovaná implementace unzip v R nefunguje správně s několika soubory z archivu, proto jsme použili systémový unzip (pomocí parametru getOption("unzip")).
Funkce pro zápis do databáze
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Pokud je potřeba tabulku před zápisem do DB transformovat, stačí předat do argumentu preprocess funkci, která data transformuje.
Kód pro sekvenční nahrávání dat do databáze:
Zápis dat do databáze
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
Čas nahrávání dat se může lišit v závislosti na rychlostních charakteristikách použitého úložiště. V našem případě čtení a zápis z jednoho SSD nebo z flash disku (zdrojový soubor) na SSD (DB) zabere méně než 10 minut.
Další sekundy jsou potřeba na vytvoření sloupce s celočíselnou značkou třídy a sloupce indexu (ORDERED INDEX) s čísly řádků, podle kterého se budou vybírat pozorování při vytváření dávkování:
Vytvoření dodatečných sloupců a indexu
message("Generate lables")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Generate row numbers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)"))
Pro řešení úlohy dynamického vytváření dávky jsme museli dosáhnout maximální rychlosti extrakce náhodných řádků z tabulky. doodles. K tomu jsme použili 3 triky. První spočíval v zmenšení datového typu pro uložení ID pozorování. V původním datovém souboru je pro ukládání ID zapotřebí typ bigint, ale počet pozorování umožňuje skladovat jejich identifikátory, které odpovídají pořadovému číslu, v typu int. Vyhledávání přitom probíhá výrazně rychleji. Druhým trikem bylo použití ORDERED INDEX — k tomuto řešení jsme došli empiricky, vyzkoušením všech dostupných Třetí spočíval v použití parametrizovaných dotazů. Podstata metody spočívá v jednorázovém provedení příkazu PREPARE s následným využitím připraveného výrazu při vytváření hromady homogenních dotazů, ale v praxi byl zisk oproti jednoduchému nebude prováděn při nepravdivosti první podmínky. Opravy pomocí v oblasti statistické chyby.
Proces nahrávání dat spotřebovává maximálně 450 MB RAM. To znamená, že popsaný přístup umožňuje manipulovat s datovými soubory o hmotnosti v desítkách gigabajtů prakticky na jakémkoli rozpočtovém hardwaru, včetně některých jednočipových počítačů, což je docela úžasné.
Zbývá provést měření rychlosti extrakce (náhodných) dat a zhodnotit škálování při výběru dávek různých velikostí:
Benchmark databáze
library(ggplot2)

set.seed(0)
# Připojení k databázi
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Funkce pro přípravu dotazu na straně serveru
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Funkce pro získání dat
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Měření výkonu
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Parametry benchmarku
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("medián času, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 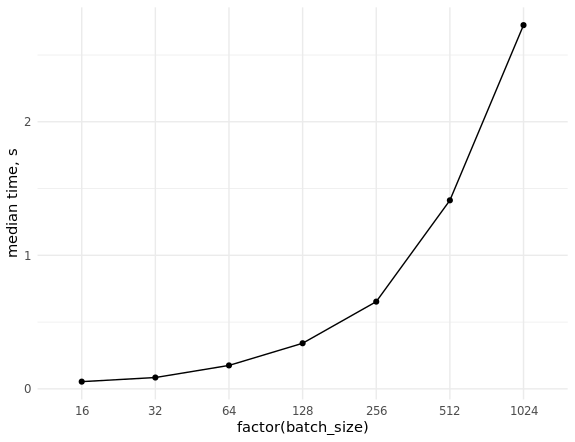
2. Příprava batchů
Celý proces přípravy batchů se skládá z následujících etap:
- Parsování několika JSONů, obsahujících vektory řetězců s koordináty bodů.
- Kreslení barevných čar podle souřadnic bodů na obrázku požadované velikosti (například 256×256 nebo 128×128).
- Transformace získaných obrázků na tenzor.
V rámci soutěže mezi kernel-y na Pythonu byla úloha řešena převážně prostředky OpenCV. Jeden z nejjednodušších a nejjasnějších analogů v R by vypadal takto:
Implementace transformace JSON na tenzor v R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # Parsing JSON
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Deleting temporary file upon function completion
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Empty plot
  plot.new()
  # Plot window size
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Line colors
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Converting image to a 3D array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Merging 3D image arrays into a 4D tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
Kreslení se provádí standardními nástroji R s uložením do dočasného PNG souboru, který je uložen v RAM (v Linuxu jsou dočasné adresáře R umístěny v adresáři /tmp, namontovaném v RAM). Poté je tento soubor přečten jako 3D pole s čísly v rozsahu od 0 do 1. To je důležité, protože běžněji používaný BMP by byl přečten jako raw pole s hex kódy barev.
Otestujme výsledek:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 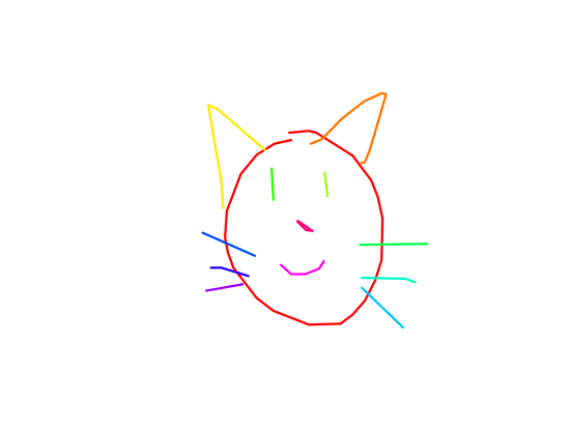
Samotná dávka bude vytvářena následujícím způsobem:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=List of 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Tato implementace nám připadala suboptimální, protože vytváření velkých dávek trvá nepřiměřeně dlouho a rozhodli jsme se využít zkušenosti kolegů a využít mocnou knihovnu OpenCV. V té době neexistoval hotový balíček pro R (a ani teď není), proto byla napsaná minimální implementace požadované funkce v C++ s integrací do kódu v R pomocí Rcpp.
K řešení úkolu byly použity následující balíčky a knihovny:
OpenCV pro práci s obrázky a kreslení čar. Použili jsme předem nainstalované systémové knihovny a hlavičkové soubory, a také dynamické linkování.
xtensor pro práci s vícerozměrnými poli a tenzory. Použili jsme hlavičkové soubory zahrnuté ve stejnojmenném R balíčku. Knihovna umožňuje práci s vícerozměrnými poli, a to jak v řádkovém, tak ve sloupcovém pořadí.
ndjson pro parsování JSON. Tato knihovna je používána v xtensor automatically when present in the project.
RcppThread pro organizaci vícetlakého zpracování vektoru z JSON. Použili jsme hlavičkové soubory poskytované tímto balíčkem. Od populárnějšího RcppParallel balíček mimo jiné vyniká integrovaným mechanismem přerušení smyčky (interrupt).
Stojí za zmínku, že xtensor se ukázal být opravdovým nálezem: kromě toho, že disponuje širokou funkcionalitou a vysokým výkonem, se jeho vývojáři ukázali jako velmi vstřícní a rychle a detailně odpovídali na vzniklé dotazy. S jejich pomocí se podařilo implementovat převody matic OpenCV na tenzory xtensor a také způsob, jak spojit 3D tenzory obrazů do 4D tenzoru správného rozměru (vlastně batch).
Materiály pro studium Rcpp, xtensor a RcppThread
Pro kompilaci souborů, které používají systémové soubory a dynamické linkování s knihovnami nainstalovanými v systému, jsme využili mechanismus pluginů implementovaný v balíčku Rcpp. Pro automatické hledání cest a příznaků jsme použili populární linuxovou utilitu pkg-config.
Implementace Rcpp pluginu pro použití knihovny OpenCV
Rcpp::registerPlugin("opencv", function() {
  # Možné názvy balíčku
  pkg_config_name <- c("opencv", "opencv4")
  # Binární soubor utility pkg-config
  pkg_config_bin <- Sys.which("pkg-config")
  # Kontrola přítomnosti utility v systému
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Kontrola přítomnosti souboru nastavení OpenCV pro pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV config for the pkg-config not found", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
V důsledku práce pluginu během kompilace budou dosazeny následující hodnoty:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
Kód pro implementaci analýzy JSON a vytvoření dávky pro odeslání do modelu je uveden pod spoilerem. Předem přidáváme lokální adresář projektu pro hledání hlavičkových souborů (potřebné pro ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementace převodu JSON na tensor v C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Tento kód by měl být umístěn do souboru src/cv_xt.cpp a kompilován příkazem Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); také pro práci bude vyžadováno nlohmann/json.hpp z . Kód je rozdělen do několika funkcí:
to_xt— šablonová funkce pro převod matice obrazu (cv::Mat) na tensorxt::xtensor;parse_json— funkce analyzuje JSON řetězec, extrahuje souřadnice bodů a balí je do vektoru;ocv_draw_lines— z získaného vektoru bodů vykresluje barevné čáry;process— kombinuje výše popsané funkce a také přidává možnost škálování získaného obrazu;cpp_process_json_str— wrapper pro funkciprocess, která exportuje výsledek do R-objektu (vícerozměrné pole);cpp_process_json_vector— wrapper pro funkcicpp_process_json_str, která umožňuje zpracovávat řetězcový vektor v multithreadovém režimu.
Pro vykreslení barevných čar byla použita barevná model HSV s následnou konverzí na RGB. Otestujme výsledek:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 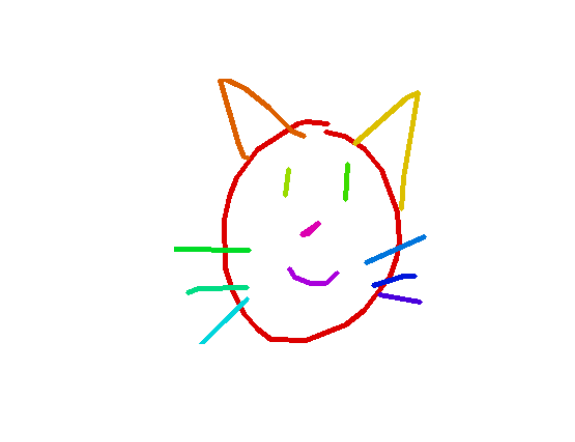
Srovnání rychlosti výkonu implementací v R a C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Parametry benchmarku
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Provádění měření
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group = expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("medián času, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 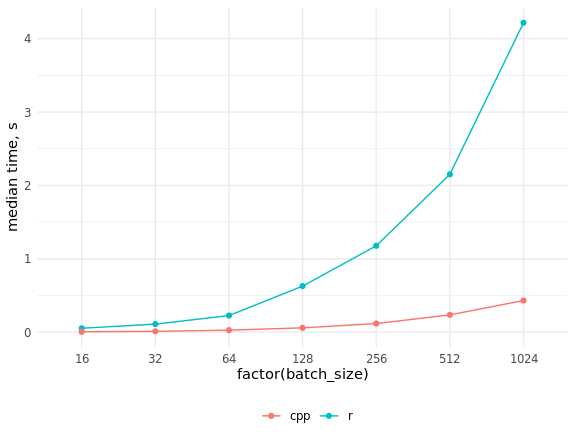
Jak vidíme, nárůst rychlosti byl velmi výrazný a nelze dosáhnout výkonu C++ pomocí paralelizace kódu v R.
3. Iterátory pro načítání dávkových dat z databáze
R má zaslouženou pověst jako jazyk pro zpracování dat uložených v RAM, zatímco Python se více zaměřuje na iterativní zpracování dat, které usnadňuje a zjednodušuje realizaci výpočtů out-of-core (výpočty s využitím externí paměti). Klasickým a aktuálním příkladem takových výpočtů, který nás zajímá v kontextu popisovaného úkolu, jsou hluboké neuronové sítě, které se trénují metodou gradientního sestupu s aproximací gradientu na každém kroku na malé množství pozorování, nebo mini-batch.
Rámce pro hluboké učení napsané v Pythonu mají speciální třídy, které implementují iterátory pro data: tabulky, obrázky ve složkách, binární formáty atd. Můžete použít hotové varianty nebo psát vlastní pro specifické úkoly. V R můžeme využít všechny možnosti Pythoní knihovny keras s jejími různými backendy pomocí stejnojmenného balíčku, který pracuje nad balíčkem reticulate. Ten si zaslouží samostatný rozsáhlý článek; nejenže umožňuje spouštět kód Pythonu z R, ale také zajišťuje přenos objektů mezi R a Python sezeními, automaticky provádějící všechny potřebné konverze typů.
Osvobodili jsme se od nutnosti uchovávat všechna data v RAM využitím MonetDBLite, veškerou "neurónovou" práci vykoná originální kód v Pythonu, nám zbývá jen napsat iterátor pro data, protože hotový pro tuto situaci není ani v R, ani v Pythonu. Požadavky na něj jsou vlastně jen dva: musí vracet batchy v nekonečné smyčce a uchovávat svůj stav mezi iteracemi (poslední se v R realizuje jednoduše pomocí uzávěrů). Dříve bylo potřeba uvnitř iterátoru explicitně převádět pole R na numpy pole, ale aktuální verze balíčku keras to dělá sama.
Iterátor pro tréninková a validační data vypadá takto:
Iterátor pro tréninková a validační data
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
Funkce přijímá jako vstup proměnnou s připojením k DB, čísla používaných řádků, počet tříd, velikost batchu, měřítko (scale = 1 odpovídá vykreslení obrázků o velikosti 256x256 pixelů, scale = 0.5 — 128x128 pixelů), indikátor barevnosti (color = FALSE určuje vykreslení v odstínech šedé při použití barva = PRAVDA každý tah je nakreslen novou barvou) a indikátor předzpracování pro sítě, které byly předtrénovány na imagenet. Ten je potřebný pro škálování hodnot pixelů z intervalu [0, 1] na interval [-1, 1], který byl použit při trénování dodávaného v rámci keras modelů.
Externí funkce obsahuje kontrolu typů argumentů, tabulku data.table s náhodně promíchanými čísly řádků z samples_index a čísly batchů, počítadlo a maximální počet batchů, stejně jako SQL výraz pro export dat z DB. Dále jsme uvnitř definovali rychlou alternativu funkce keras::to_categorical(). Pro trénink jsme použili téměř všechna data, ponechávajíc půl procenta na validaci, proto byla velikost epochy omezena parametrem steps_per_epoch při volání, takže všechny keras::fit_generator(), a podmínka if (i > max_i) se aktivovala pouze pro validační iterátor.
Ve vnitřní funkci dochází k výběru indexů řádků pro příští batch, exportu záznamů z DB s navyšováním počitadla batchů, parsování JSONů (funkce cpp_process_json_vector(), napsaná v C++) a tvorbě polí odpovídajících obrázkům. Následně se vytvářejí one-hot vektory s označeními tříd, pole s hodnotami pixelů a s označeními se spojují do seznamu, který je vracenou hodnotou. Pro urychlení byla použita tvorba indexů v tabulkách data.table a modifikace podle odkazu — bez těchto 'vychytávek' by bylo data.table docela obtížné si představit efektivní práci s jakýmikoliv významnými objemy dat v R.
Výsledky měření rychlosti na notebooku s Core i5 vypadají takto:
Benchmark iterátora
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indexes for training dataset
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indexes for validation dataset
val_ind <- ind[-train_ind]
rm(ind)
# Scaling factor
scale <- 0.5

# Conducting measurement
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmark parameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 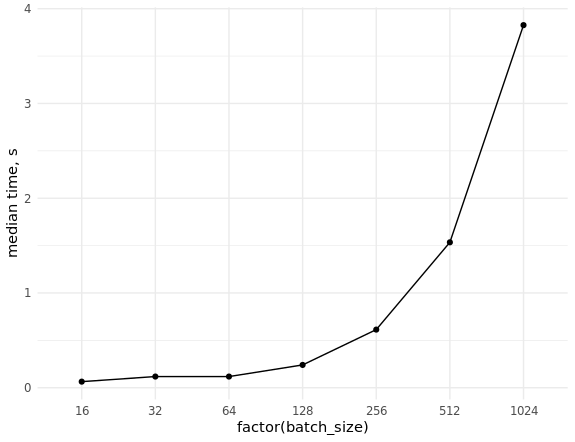
Pokud je k dispozici dostatek RAM, lze výrazně zrychlit databázi jejím přesunem do RAM (pro náš úkol stačí 32 GB). V Linuxu je ve výchozím nastavení připojená oddíl /dev/shm, zabírající až polovinu objemu RAM. Můžete vyhradit i více, úpravou /etc/fstab, aby vznikl záznam ve formátu tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Nezapomeňte restartovat a zkontrolovat výsledek provedením příkazu df -h.
Iterátor pro testovací data vypadá mnohem jednodušeji, protože testovací dataset se vejde celý do RAM:
Iterátor pro testovací data
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Výběr architektury modelu
První z použitých architektur byla , jejíž vlastnosti jsou podrobněji rozebrány v příspěvku. Je součástí standardní dodávky keras a je tedy dostupná v totožném balíčku pro R. Ale když jsme se pokusili použít ji s jednokanálovými obrázky, vyšlo najevo podivné zjištění: vstupní tensor musí mít vždy dimenzi (batch, height, width, 3), což znamená, že počet kanálů nelze změnit. V Pythonu tato omezení neexistují, a proto jsme spěchali a napsali svou implementaci této architektury podle originálního článku (bez dropout, který je v keras variantě):
Architektura mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
Nevýhody tohoto přístupu jsou zřejmé. Chceme otestovat mnoho modelů, ale nechtějí se nám jednotlivé architektury ručně přepisovat. Také jsme byli zbaveni možnosti používat váhy modelů, které byly předem natrénovány na imagenet. Jak je obvyklé, pomohlo studium dokumentace. Funkce get_config() umožňuje získat popis modelu v editovatelné podobě (base_model_conf$layers — běžný R-ovský seznam), a funkce from_config() provádí zpětnou konverzi na modelový objekt:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Nyní není problém napsat univerzální funkci pro získání jakéhokoli z dodávaných modelů s váhami trénovanými na imagenet nebo bez nich: keras Funkce pro načtení připravených architektur
get_model <- function(name = "mobilenet_v2", input_shape = NULL, weights = "imagenet", pooling = "avg", num_classes = NULL, optimizer = keras::optimizer_adam(lr = 0.002), loss = "categorical_crossentropy", metrics = NULL, color = TRUE, compile = FALSE) { # Kontrola argumentů checkmate::assert_string(name) checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3) checkmate::assert_count(num_classes) checkmate::assert_flag(color) checkmate::assert_flag(compile)# Získání objektu z balíčku keras model_fun <- get0(paste0("application_", name), envir = asNamespace("keras")) # Kontrola existence objektu v balíčku if (is.null(model_fun)) { stop("Model ", shQuote(name), " nebyl nalezen.", call. = FALSE) }base_model <- model_fun( input_shape = input_shape, include_top = FALSE, weights = weights, pooling = pooling )# Pokud není obraz barevný, změníme dimenzi vstupu if (!color) { base_model_conf <- keras::get_config(base_model) base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L base_model <- keras::from_config(base_model_conf) }predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax") model <- keras::keras_model( inputs = base_model$input, outputs = predictions )if (compile) { keras::compile( object = model, optimizer = optimizer, loss = loss, metrics = metrics ) }return(model) }
Při používání jednokanálových obrázků se předtrénované váhy nepoužívají. To by šlo opravit: pomocí funkceget_weights() získat váhy modelu jako seznam z R-ovských polí, změnit dimenzi prvního prvku tohoto seznamu (získáním nějakého jednoho barevného kanálu nebo průměrováním všech tří) a poté načíst váhy zpět do modelu funkcí set_weights() . Tento funkce jsme nakonec nepřidali, protože v této fázi už bylo jasné, že produktivnější je pracovat s barevnými obrázky.. Tento funkce jsme nakonec nepřidali, protože v této fázi už bylo jasné, že efektivnější je pracovat s barevnými obrázky.
Hlavní část experimentů jsme provedli s použitím mobilenet verzí 1 a 2, stejně jako resnet34. V této soutěži se osvědčily modernější architektury, jako je SE-ResNeXt. Bohužel jsme neměli k dispozici hotové implementace a vlastní jsme zatím nenapsali (ale určitě napíšeme).
5. Parametrizace skriptů
Pro pohodlí byl veškerý kód pro spuštění učení uspořádán do jednoho skriptu, který je parametizován pomocí následujícím způsobem:
doc <- '
Usage:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Options:
  -h --help                   Zobrazit tuto zprávu.
  -l --list-models            Zobrazit dostupné modely.
  -m --model=          Název modelu neuronové sítě [výchozí: mobilenet_v2].
  -b --batch-size=      Velikost dávky [výchozí: 32].
  -s --scale-factor=   Měrný faktor [výchozí: 0.5].
  -c --color                  Použít barevné čáry [výchozí: FALSE].
  -d --db-dir=          Cesta k adresáři databáze [výchozí: Sys.getenv("db_dir")].
  -r --validate-ratio= Procento vzorků pro validaci [výchozí: 0.995].
  -n --n-gpu=         Počet GPU [výchozí: 1].
'
args <- docopt::docopt(doc)
Balíček docopt je implementací pro R. S jeho pomocí se skripty spouštějí jednoduchými příkazy jako Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db nebo ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, pokud je soubor train_nn.R proveditelný (tento příkaz spustí trénink modelu resnet50 na trojbarevných obrázcích o rozměrech 128x128 pixelů, databáze by měla být umístěna ve složce /home/andrey/doodle_db). Do seznamu lze přidat rychlost učení, typ optimalizátoru a jakékoli další parametrizované parametry. Při přípravě publikace se ukázalo, že architekturu mobilenet_v2 z aktuální verze keras v R použít kvůli změnám, které nebyly zohledněny v R balíčku — čekáme, až to opraví.
Tento přístup umožnil výrazně urychlit experimenty s různými modely ve srovnání s tradičním spuštěním skriptů v RStudiu (jako možnou alternativu můžeme zmínit balíček ). Ale hlavní výhodou je možnost snadno řídit spuštění skriptů v dockeru nebo jednoduše na serveru, aniž bychom pro to instalovali RStudio.
6. Dockerizace skriptů
Použili jsme docker k zajištění přenositelnosti prostředí pro trénink modelů mezi členy týmu a pro rychlé nasazení v cloudu. S tímto relativně nezvyklým nástrojem pro programátory v R se můžete seznámit prostřednictvím série publikací nebo s .
Docker umožňuje vytvářet vlastní obrazy „od nuly“ a také využívat jiné obrazy jako základ pro jejich tvorbu. Při zkoumání dostupných variant jsme dospěli k závěru, že instalace ovladačů NVIDIA, CUDA+cuDNN a knihoven Pythonu je poměrně rozsáhlou částí obrazu, a rozhodli jsme se jako základ vzít oficiální obraz tensorflow/tensorflow:1.12.0-gpu, přičemž jsme k němu přidali potřebné balíčky R.
Konečný dockerfile vypadá takto:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Pro pohodlí byly používané balíčky umístěny do proměnných; většina napsaných skriptů je kopírována dovnitř kontejnerů při stavbě. Také jsme změnili příkazovou řádku na /bin/bash pro usnadnění používání obsahu /etc/os-release. To umožnilo vyhnout se nutnosti uvádět verzi OS v kódu.
Dále byl napsán malý bash skript, který umožňuje spouštět kontejner s různými příkazy. Například to mohou být skripty pro trénování neuronových sítí, které byly dříve umístěny dovnitř kontejneru, nebo příkazová řádka pro ladění a monitorování činnosti kontejneru:
Skript pro spuštění kontejneru
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Pokud tento bash skript spustíte bez parametrů, uvnitř kontejneru se spustí skript train_nn.R s výchozími hodnotami; pokud je prvním pozičním argumentem "bash", kontejner se spustí v interaktivním režimu s příkazovým řádkem. Ve všech ostatních případech dochází k dosazení hodnot pozičních argumentů: CMD="Rscript /app/train_nn.R $@".
Je třeba poznamenat, že adresáře s původními daty a databází, stejně jako adresář pro ukládání vytrénovaných modelů, jsou namontovány uvnitř kontejneru ze hostitelské systému, což umožňuje přístup k výsledkům práce skriptů bez zbytečných manipulací.
7. Použití několika GPU v cloudu Google Cloud
Jednou z charakteristik soutěže byla velmi šumová data (viz úvodní obrázek zapůjčený od @Leigh.plt z ODS Slacku). Boj proti tomu pomáhají velké dávky, a po experimentech na PC s 1 GPU jsme se rozhodli osvojit si trénování modelů na několika GPU v cloudu. Použili jsme Google Cloud () kvůli širokému výběru dostupných konfigurací, přijatelným cenám a bonusovým $300. Z chamtivosti byla objednána instance s 4x V100 SSD a spoustou RAM, a to byla velká chyba. Peníze takový stroj rychle spolkne, na experimentech bez vypracovaného pipeline se můžete zruinovat. Na vzdělávací účely je lepší brát K80. Velké množství RAM se ale hodilo — cloudový SSD neoslnil rychlostí, a proto byla databáze při každém spuštění instance přenesena na dev/shm.
Největší zájem vyvolává fragment kódu, který odpovídá za využití několika GPU. Nejdříve se model vytvoří na CPU s použitím kontextového správce, úplně jako v Pythonu:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics =(top_3_categorical_accuracy,
    compile = FALSE
  )
})
Pak se nekompilovaný (to je důležité) model zkopíruje na zadaný počet dostupných GPU, a teprve poté se kompiluje:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Klasický přístup se zmrazením všech vrstev kromě poslední, učením poslední vrstvy, rozmrazením a doladěním modelu jako celku pro několik GPU se nezdařil.
S trénováním se sledovalo bez použití tensorboard, omezením pouze na záznamy protokolů a uchovávání modelů s informativními názvy po každé epoše:
Callbacky
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. Místo závěru
Řada problémů, se kterými jsme se setkali, zatím nebyla vyřešena:
- v keras neexistuje hotová funkce pro automatické hledání optimální rychlosti učení (analog
lr_finderv knihovně fast.ai); s jistými náklady je možné portovat na R alternativní implementace, například, ; - vzhledem k předchozímu bodu se nepodařilo najít správnou rychlost učení při použití více GPU;
- chybí moderní architektury neuronových sítí, zejména předtrénované na imagenet;
- neexistuje one cycle policy a diskriminační rychlosti učení (cosine annealing na naši žádost byl , děkuji ).
Co užitečného se podařilo vyvodit z této soutěže:
- Na relativně slabém hardwaru je možné pracovat s významnými (mnohonásobně převyšujícími velikost RAM) objemy dat bez velkých potíží. Balíček data.table šetří paměť díky in-place úpravě tabulek, což umožňuje vyhnout se jejich kopírování, a při správném využití jeho možností téměř vždy vykazuje nejvyšší rychlost mezi všemi námi známými nástroji pro skriptovací jazyky. Uložení dat v DB mnohdy umožňuje vůbec nepřemýšlet o nutnosti nacpat celý dataset do RAM.
- Pomalé funkce v R lze nahradit rychlými v C++ pomocí balíčku Rcpp. Pokud navíc použijeme RcppThread nebo RcppParallel, získáme multiplatformní vícevláknové implementace, takže kód na úrovni R není třeba paralelizovat.
- Balíček Rcpp může být používán bez vážných znalostí C++, nezbytné minimum je uvedeno . Hlavičkové soubory pro řadu špičkových C knihoven, jako je xtensor , jsou dostupné na CRAN, tedy se vytváří infrastruktura pro realizaci projektů integrujících v R hotový vysoce výkonný kód v C++. Další pohodlí — zvýraznění syntaxe a statický analyzátor kódu v C++ v RStudio.
- docopt umožňuje spouštět samostatné skripty s parametry. To je pohodlné pro použití na vzdáleném serveru, včetně pod dockerem. V RStudio je obtížné provádět hodinové experimenty s učením neuronových sítí, a samotná instalace IDE na serveru není vždy odůvodněná.
- Docker zajišťuje přenositelnost kódu a reprodukovatelnost výsledků mezi vývojáři s různými verzemi OS a knihoven, a také usnadňuje spuštění na serverech. Celý pipeline pro trénink lze spustit jedním příkazem.
- Google Cloud je rozpočtový způsob, jak experimentovat na drahém hardwaru, ale je třeba pečlivě vybírat konfigurace.
- Měření rychlosti jednotlivých částí kódu je velmi užitečné, zejména při kombinaci R a C++, a s balíčkem bench to je také velmi snadné.
Celkově byla tato zkušenost velmi užitečná a pokračujeme v práci na řešení některých z uvedených problémů.
Zdroj: habr.com
