

Forskere fra Cambridge Universitet har offentliggjort en teknik til usynlig indsættelse af ondsindet kode i gennemgåede kildekoder. Den angrebmetode, der er forberedt (CVE-2021-42574), præsenteres under navnet Trojan Source og bygger på at skabe tekst, der ser forskellig ud for kompilatoren/fortolkeren og mennesket, der gennemgår koden. Eksempler på metoden er demonstreret for forskellige compiler og fortolkere, der leveres til sprog som C, C++ (gcc og clang), C#, JavaScript (Node.js), Java (OpenJDK 16), Rust, Go og Python.
Metoden er baseret på brugen af specielle Unicode-tegn i kommentarer til koden, der ændrer rækkefølgen for visning af tovejs tekst. Ved hjælp af sådanne kontroltegn kan nogle dele af teksten vises fra venstre mod højre, mens andre kan vises fra højre mod venstre. I praksis kan sådanne kontroltegn anvendes til at indsætte linjer på hebraisk eller arabisk i en kodefil. Men hvis man kombinerer linjer med forskellige tekstretninger i én linje ved hjælp af de nævnte tegn, kan tekstudsnit, der vises fra højre mod venstre, dække eksisterende normal tekst, der vises fra venstre mod højre.
Ved at anvende denne metode kan der tilføjes en ondsindet konstruktion i koden, men teksten med denne konstruktion kan derefter gøres usynlig ved gennemgang af koden, ved at tilføje i den efterfølgende kommentar eller i litteralen tegn, der vises fra højre mod venstre, hvilket vil føre til, at der overlapper helt andre tegn over den ondsindede indsættelse. Sådan kode vil forblive semantisk korrekt, men vil blive tolket og vist forskelligt.
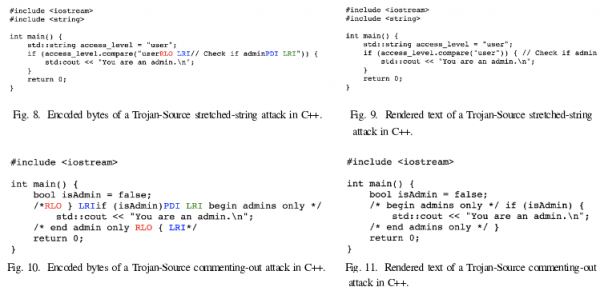
Under gennemgang af koden vil udvikleren støde på den visuelle rækkefølge af tegnene og se en uskyldig kommentar i moderne teksteditorer, webgrænseflader eller IDE, men kompilatoren og fortolkeren vil bruge den logiske rækkefølge af tegnene og behandle den ondsindede indsættelse som den er, uden at tage hensyn til den tovejs tekst i kommentaren. Problemet rammer forskellige populære kodeeditorer (VS Code, Emacs, Atom) samt grænseflader til visning af kode i repositories (GitHub, Gitlab, BitBucket og alle Atlassian-produkter).
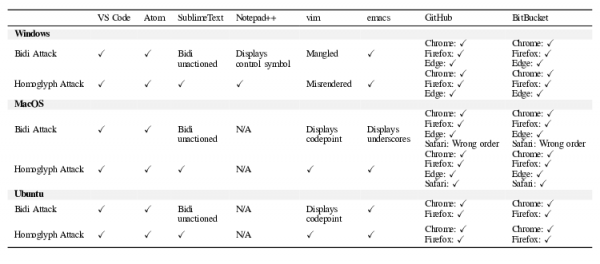
Der er fremhævet flere måder at anvende metoden til at udføre skadelige handlinger: tilføjelse af et skjult udtryk "return", der får funktionen til at afslutte for tidligt; indkapsling af udtryk i kommentarer, som normalt ville være synlige som gyldige konstruktioner (f.eks. til deaktivering af vigtige kontroller); tildeling af andre strengværdier, der får strengkontrollerne til at mislykkes.
For eksempel kan den angrebende person foreslå en ændring, der inkluderer linjen: if access_level != "user{U+202E} {U+2066}// Check if admin{U+2069} {U+2066}" {
som vil blive vist i grænsefladen til gennemgang som if access_level != "user" { // Check if admin
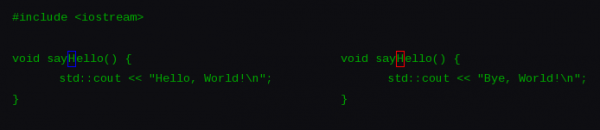
Derudover er der foreslået en anden angrebsmetode (CVE-2021-42694), relateret til brugen af homoglyphs, tegn der ligner hinanden visuelt, men har forskellige betydninger og forskellige unicode-koder (f.eks. tegnet "ɑ" ligner "a", "ɡ" ligner "g", "ɩ" ligner "l"). Sådanne tegn kan bruges i nogle sprog i funktions- og variabelnavne for at forvirre udviklere. For eksempel kan der defineres to funktioner med uadskillelige navne, der udfører forskellige handlinger. Uden en detaljeret gennemgang er det umuligt straks at se, hvilken af disse to funktioner der bliver kaldt på et givent sted.
Som en beskyttelsesforanstaltning anbefales det at implementere en fejl- eller advarselsmeddelelse i compilere, fortolkere og build-værktøjer, der understøtter Unicode-tegn, når der findes ulige kontroltegn, der ændrer outputretningen (U+202A, U+202B, U+202C, U+202D, U+202E, U+2066, U+2067, U+2068, U+2069, U+061C, U+200E og U+200F) i kommentarer, strengliteraler eller identifikatorer. Sådanne tegn skal også være eksplicit forbudt i programmeringssprogs specifikationer og skal tages højde for i kodeeditorer og interfaces til arbejde med repositories.
Tillæg 1: Rettelser til at eliminere sårbarheden er blevet forberedt til GCC, LLVM/Clang, Rust, Go, Python og binutils. Problemet er også blevet løst af GitHub, Bitbucket og Jira. Der er i gang med at forberede en rettelse til GitLab. For at identificere problematisk kode er det foreslået at bruge kommandoen: grep -r $'[\u061C\u200E\u200F\u202A\u202B\u202C\u202D\u202E\u2066\u2067\u2068\u2069]' /path/to/source
Tillæg 2: Russ Cox, en af udviklerne af OS Plan 9 og programmeringssproget Go, kritiserede den overdrevne opmærksomhed på den beskrevne angrebsmetode, som allerede er velkendt (Go, Rust, C++, Ruby) og ikke tages alvorligt. Ifølge Cox handler problemet primært om korrekt fremvisning af information i kodeeditorer og webgrænseflader og kan løses ved at anvende passende værktøjer og kodeanalyse ved gennemgang. Derfor ville det være mere korrekt at fokusere på forbedring af kodegennemgangsprocesser og afhængigheder i stedet for at tiltrække opmærksomhed til hypotetiske angreb.
Russ Cox mener også, at compilere ikke er det rette sted at løse problemet, da selv ved at forbyde farlige tegn på compilerniveau, er der stadig et stort antal værktøjer, hvor brugen af disse tegn er tilladt, såsom build-systemer, assemblere, pakkeadministratorer og forskellige konfigurations- og data-parser. For eksempel har projektet Rust forbudt behandling af LTR/RTL kode i compileren, men har ikke tilføjet en løsning i pakkeadministratoreren Cargo, hvilket muliggør et lignende angreb via Cargo.toml-filen. Tilsvarende kan filer som BUILD.bazel, CMakefile, Cargo.toml, Dockerfile, GNUmakefile, Makefile, go.mod, package.json, pom.xml og requirements.txt være kildene til sådanne angreb.
Kilde: opennet.ru
