

OpenAI-projektet, der arbejder med udviklingen af offentligt tilgængelige projekter inden for kunstig intelligens, har offentliggjort resultater relateret til talesystemet Whisper. Det hævdes, at systemet sikrer pålideligheds- og præcisionsniveauer for automatisk talegenkendelse tæt på menneskelig genkendelse for engelsk tale. Koden til den referenceimplementering, der er baseret på PyTorch-rammen, og en række forudtrænede modeller, er gjort tilgængelig. Koden er åbent licenseret under MIT-licensen.
Modelen blev trænet på 680.000 timers tale-data samlet fra flere samlinger, der dækker forskellige sprog og temaer. Omtrent 1/3 af de anvendte tale-data under træningen er fra sprog, der ikke er engelsk. Det foreslåede system håndterer situationer som akcentudtale, baggrundsstøj og anvendelse af teknisk jargon korrekt. Udover at transskribere tale til tekst kan systemet også oversætte tale fra et vilkårligt sprog til engelsk og identificere fremkomsten af tale i lydstrømmen.
Modellerne er dannet i to repræsentationer: en model til engelsk og en flersproget model, der også understøtter russisk, ukrainsk og hvidrusisk. Hver repræsentation deles igen op i 5 varianter, der adskiller sig i størrelse og antal dækget parametre i modellen. Jo større størrelsen er, desto højere er nøjagtigheden og kvaliteten af genkendelsen, men også kravene til videohukommelsesstørrelse på GPU'en er højere, og præstationen er lavere. For eksempel inkluderer den mindste variant 39 millioner parametre og kræver 1 GB videohukommelse, mens den maksimale variant inkluderer 1550 millioner parametre og kræver 10 GB videohukommelse. Den mindste variant er 32 gange hurtigere end den maksimale.
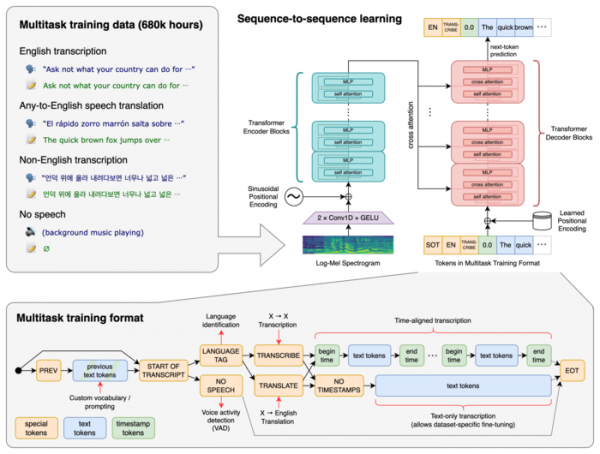
Systemet anvender en "Transformer"-neuralnetværksarkitektur, der omfatter en kodec og dekode, der interagerer med hinanden. Lyden opdeles i 30-sekunders segmenter, som omformes til log-Mel-spektrogrammer og sendes til kodec'en. Resultatet fra kodec'en sendes til dekode, som forudsiger en tekstlig repræsentation blandet med særlige tokens, der muliggør løsning af opgaver som sprogidentifikation, hensyntagen til kronologien i sætningernes udtale, tale-transkription på forskellige sprog og oversættelse til engelsk i en samlet model.
Kilde: opennet.ru
