

Google har annonceret åbningen af kildekoden til projektet Magika, der er designet til at bestemme typeindhold baseret på analyse af de data, der findes i filen. Magika kan præcist identificere de anvendte programmeringssprog, komprimeringsmetoder, installationspakker, eksekverbare kode, typer markup, lyd-, video-, dokument- og billedformater. Det tilknyttede værktøj og den færdige maskinlæringsmodel offentliggøres under Apache 2.0-licensen.
I modsætning til lignende projekter, der bestemmer MIME-typen baseret på indhold, adskiller Magika sig ved at anvende maskinlæringsmetoder, høj ydeevne og fremragende præcision i bestemmelsen. Modellen er trænet ved hjælp af Keras-rammen på 25 millioner filprøver og understøtter genkendelse af 116 datatyper med en præcision på ikke mindre end 99%. Modellen er samlet i ONNX-format og fylder kun 1 MB. Anvendelsen af dybe maskinlæringsmetoder har gjort det muligt at øge nøjagtigheden med 50% sammenlignet med det tidligere anvendte system i Google, som er baseret på håndvervede regler.
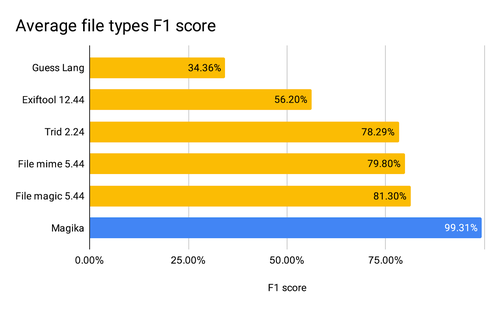
I Google-systemet anvendes det til klassificering af filer i tjenesterne Gmail, Drive, Code Insight og Safe Browsing under sikkerheds- og overholdelseskontroller. Der arbejdes på at integrere Magika i VirusTotal-platformen som et led i den indledende filtrering af filer, inden der udføres specifikke analyser. Den implementerede Magika-konfiguration i Googles infrastruktur muliggør scanning af flere millioner filer per sekund og flere hundrede milliarder filer om ugen. Efter modeloploadning er tiden til at generere output 5-6 ms, når den testes på en enkelt CPU-kerne. Tiden til bestemmelse afhænger næsten ikke af filens størrelse.
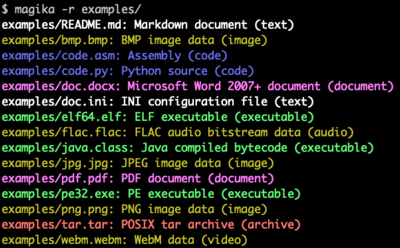
For at aktivere Magika i sine projekter er der udviklet et kommandolinjeværktøj, en pakke til Python og et JavaScript-bibliotek, der kan fungere i browseren eller i projekter baseret på Node.js. Kommandolinjegrænsefladen og API'et understøtter kørslen af operationer i batch-tilstand, hvilket betyder, at flere filer kan kontrolleres i én anmodning. Der er en tilstand for rekursiv scanning af hele indholdet i en mappe og tre forudsigelsesmodes til justering af fejltolerancen (høj sikkerhed, middel sikkerhed og bedste gæt).
Kilde: opennet.ru
