

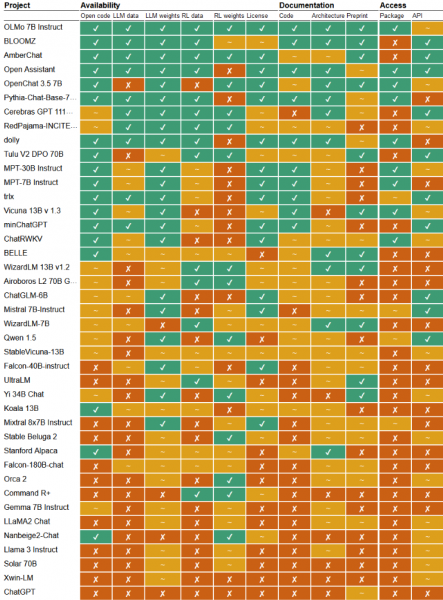
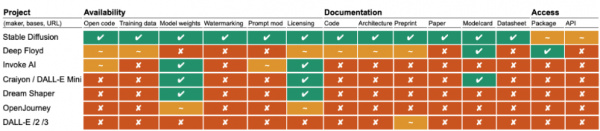
Forskere fra Nijmegen Universitet (Nederlandene) har udarbejdet en rangordning af åbenhed for 40 store sprogmodeller og 7 modeller til generering af billeder baseret på tekstbeskrivelser, som producenterne hævder er åbne. Da kriterierne for åbenhed af maskinlæringsmodeller stadig er under udvikling, er der i øjeblikket opstået en situation, hvor modeller, der markedsføres som åbne, ofte har licenser, der begrænser brugsområdet (for eksempel forbyder mange modeller anvendelse i kommercielle projekter). Ofte giver producenterne heller ikke adgang til de data, der er anvendt under træningen, afslører ikke implementeringsdetaljer, eller de åbner ikke den tilknyttede kode fuldstændigt.
De fleste modeller, der præsenteres som "åbne", bør i realiteten opfattes som "åbne vægte" eller mere præcist "tilgængelige vægte", da de distribueres under begrænsede licenser, der forbyder brug i kommercielle produkter. Uafhængige forskere kan eksperimentere med sådanne modeller, men de har ikke mulighed for at tilpasse modellen til deres behov eller inspicere implementeringen. Mere end halvdelen af modellerne giver ikke detaljerede oplysninger om de data, der anvendes til træning, og offentliggør heller ikke information om den interne opsætning og arkitektur.
De mest åbne modeller anerkendes som BloomZ, AmberChat, OLMo, Open Assistant og Stable Diffusion, som alle er offentliggjort under åbne licenser sammen med kildedata, kode og API-implementering. Modellerne fra Google (Gemma 7B), Microsoft (Orca 2) og Meta (Llama 3), der præsenteres som åbne af producenterne, er placeret længere nede i rangordningen, da de ikke giver adgang til kildeoplysninger, ikke afslører tekniske implementeringsdetaljer, og modellerne distribueres under licenser, der begrænser brugsområdet. Den populære model Mistral 7B befinder sig cirka midt i rangordningen, da den leveres under en åben licens, men kun er delvist dokumenteret, afslører ikke de data, der anvendes til træning, og har ikke en helt åben tilknyttende kode.
Forskere har fremsat 14 kriterier for åbenhed af AI-modeller, der dækker betingelserne for distribution af kode, træningsdata, vægte, datavarianter og koefficienter optimeret ved hjælp af reinforcement learning (RL), samt tilgængeligheden af anvendelige pakker, API'er, dokumentation og detaljerede beskrivelser af implementeringen.
Ifølge det udkast til definition af åben AI, der er foreslået af OSI (Open Source Initiative), er de grundlæggende kriterier for åbenhed af AI-systemet, at mulighederne for anvendelse til enhver hensigt er tilgængelige uden behov for at få særlig tilladelse; muligheden for at studere systemets funktion og inspicere dets komponenter; at foretage ændringer til enhver hensigt; og at overføre både den originale version og redaktioner efter ændringer til andre.
For at muliggøre ændringer skal AI-systemet inkludere:
- Detaljeret information om de data, der er brugt til træning, og træningsmetodologien. Oplysningerne skal være tilstrækkelige, så en professionel udvikler selv kan genskabe et tilsvarende AI-system ved at bruge de samme eller lignende data til træning.
- Tilgængeligheden af kildekoden, der gør det muligt både at køre AI-systemet og at udføre træningsprocessen (i den ovenfor nævnte tabel, i kolonnen "kode", er det angivet med "~" for mange modeller, hvilket antyder delvis tilgængelighed af koden, når koden til at køre modellen er tilgængelig, men koden til træning eller oprettelse af modellen er fraværende). Koden skal også dække områder som forbehandling, validering af data og tokenisering. Derudover skal der gives en detaljeret beskrivelse af modelarkitekturen.
- Modelparametre (vægtkoefficienter), der indebærer, at der er en klar tilstand efter træning eller en endelig optimeret version af modellen.
Kilde: opennet.ru
