

Udviklerne af OrioleDB har analyseret den nuværende tilstand af det lavniveau API, der anvendes til adgangen til udvidelsers tabeller og indekser i PostgreSQL (Table/Index Access Method (AM) API), og har foreslået måder til forbedring. Siden fremkomsten af dette API i PostgreSQL 12 har udviklerne haft mulighed for at skabe alternative datalagringsmekanismer. Dog, på trods af tilgængeligheden af dette API og de kendte begrænsninger ved den indbyggede lagermekanisme, er der endnu ikke blevet udviklet fuldt funktionelle transaktionelle lagermotorer udelukkende implementeret som udvidelser.
De mest efterspurgte funktioner for alternative tabelmotorer i PostgreSQL er:
- Alternative implementeringer af MVCC, såsom lagre baseret på UNDO-loggen.
- Indeksorganiserede tabeller, hvor indekset ikke er et valgfrit supplement til tabellen, som accelererer forespørgsler, men derimod repræsenterer den primære datastruktur, hvori tabeldataene opbevares.
Ændringerne, der er nødvendige i API Table/Index AM for at støtte alternative implementeringer af MVCC, overvejes med henblik på OrioleDB-udvidelsen, der er udviklet for at imødegå de kendte mangler ved PostgreSQLs indbyggede lagermekanisme. Problemet er, at fuld integration af OrioleDB med PostgreSQL kræver ændringer i PostgreSQL-koden, hvilket komplicerer projektets implementering og understreger behovet for modernisering af det nuværende API Table AM.
API Table AM pålægger ikke direkte, hvordan MVCC skal implementeres. Ikke desto mindre antager API Table AM og API Index AM følgende: hver TID (Tuple/row Identifier) er enten indekseret af alle indekser eller slet ikke indekseret. Selv hvis Index AM har flere referencer til en enkelt TID (f.eks. GIN), skal alle disse referencer matche den samme indekserede værdi.
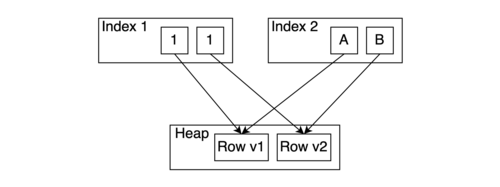
Dette princip er blevet kritiseret for at øge antallet af skriveoperationer («write amplification») — hvis en indekseret attribut opdateres, skal hver indeks i tabellen opdateres. For at drage fuld fordel af UNDO-loggen eller bygge en anden lagringsmetode uden «write amplification» (f.eks. WARM-metoden), kræves det at bryde denne antagelse.
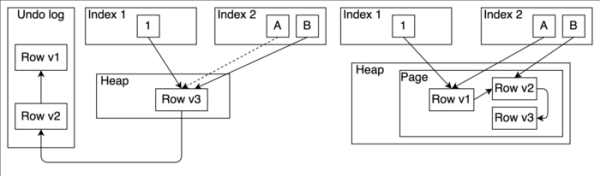
Table AM, der er baseret på UNDO, som ikke vil overtræde denne antagelse, minder om den eksisterende metode HOT (Heap-Only Tuples), bortset fra at gamle versioner af rækker gemmes i UNDO-loggen og ikke skal være på samme side. Men ifølge forfatterne er dette fordele ikke tilstrækkelige til at berettige eksistensen af en separat Table AM.
Praktiske begrænsninger i den eksisterende API:
- Under opdateringen af en tabelrække opdateres indekserne efter "alle eller ingenting" princippet.
- Mangel på mulighed for punktvis sletning af bestemte tupler i API Index AM. I øjeblikket kan tupler kun slettes fra indekser massivt ved hjælp af metoderne ambulkdelete og amvacuumcleanup. At forsøge at implementere punktvis sletning via denne API ville føre til lav effektivitet, da de fleste nuværende implementeringer skal scanne hele indekset. Desuden tillader API'et ikke at angive, hvilke af tuplerne, der refererer til den samme TID, der skal slettes. Det kan kun slette dem alle.
- Indekser henviser i øjeblikket til tabelrækker efter bloknummer (32 bit) og offsetnummer (16 bit). Og kun 11 bit af offsetnummeret kan sikkert overføres fra TID'en i tabellen til alle indeksadgangsmetoder. Derved kan alternative implementeringer af MVCC have brug for at gemme nyttelast (payload) sammen med TID. For eksempel kræver OrioleDB en eller flere bits til at implementere "delete-marking" indekser eller fuld synlighedsinformation.
To metoder er foreslået til at overvinde begrænsningerne i praksis:
Tilgang 1: API Index AM giver muligheder for alternativ implementering af MVCC.
Mens Table AM fortsat er ansvarlig for alle komponenter af MVCC, giver Index AM de nødvendige muligheder for alternativ implementering af MVCC, nemlig: opbevaring af brugerdefineret nyttelast (payload) sammen med TID, punktvis sletningsmetode og endda punktvis opdateringsmetode (hvis TID'en i indekset ikke kan ændres, kan den brugerdefinerede nyttelast ændres). Derudover, da flere tupler i indekset skal kunne referere til den samme TID, har API-metoderne, der anvendes ved scanning af indekset, også brug for opdatering.
Tilgang 2: Indekser, der understøtter MVCC.
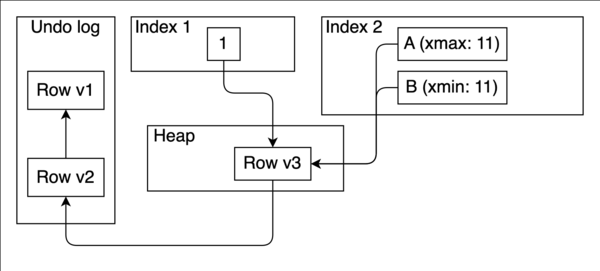
En alternativ løsning ville være at tillade indekser, der understøtter MVCC. Det vil sige, at "executor" (eller måske Table AM) blot kalder metoderne insert() og delete() i Index AM, mens Index AM giver mulighed for scanning med hensyn til MVCC. Dette ville betydeligt forenkle scanning ved udelukkende at bruge indekser (index-only). Selv hele Table AM kunne i så fald blive et mellemled, der opbevarer data i indekset.
Diagrammet nedenfor viser et eksempel. Indeksværdien 2 opdateres af transaktion 11 fra værdien "A" til værdien "B". Derfor er værdien "A" markeret som xmax == 11, mens værdien "B" er markeret som xmin == 11. På den måde kan man scanne indeks 2 og få kun synlige tupler i overensstemmelse med MVCC uden at skulle tjekke bunken (heap). Affaldsindsamling af indeks 2 kan også udføres uden at bruge bunken.
Ved implementeringen af alle de nævnte innovationer i API'et for indeksmetoder til adgang, er det usandsynligt, at det er muligt at opdatere alle indekser samtidig for at understøtte alle nye funktioner. Det er mere realistisk at tillade flere implementeringer for en tilgangsmetode til indeks. For eksempel, ud over den normale B-tree, vil udvidelsen kunne implementere en alternativ B-tree med støtte for MVCC inden for indekset og støtte for post-id'er af vilkårlig længde.
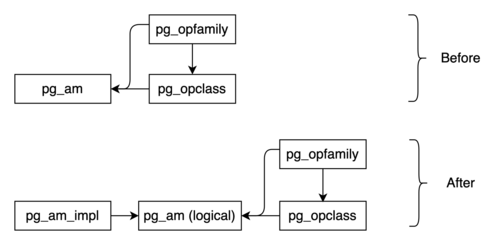
Derfor foreslås det at revurdere ikke kun API'et for Table AM, men også API'et for Index AM, som har fungeret godt for PostgreSQL-samfundet i mange år. Desuden foreslås det at opdele Index AM i et logisk lag og et implementationslag. Denne genovervejede arkitektur vil give PostgreSQL mulighed for at understøtte forskellige opbevaringsmodeller.
Kilde: opennet.ru
