

Intel Foundry har udgivet et reklamedokument, der detaljeret beskriver virksomhedens avancerede løsninger inden for udvikling og implementering af hardware til kunstig intelligens og højtydende computing. Intel har også demonstreret en "testchip til AI", som viser virksomhedens nuværende kapaciteter inden for chip-packaging.
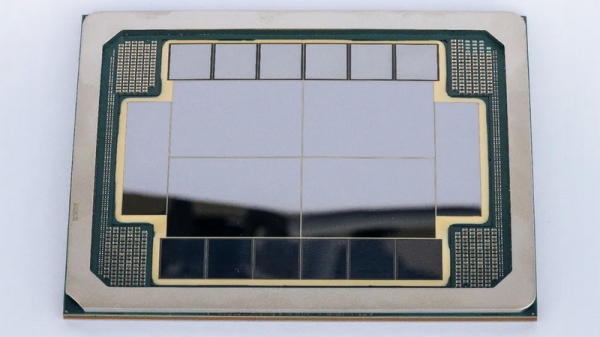
Intel viste et system i chip-package (SiP) størrelsen af otte fotomasker til standardchips, inkluderende fire logiske blokke, 12 stakke af HBM4-klasse og to input-output blokke. I modsætning til den skalerbare koncept med 16 logiske blokke og 24 stakke HBM5, præsenteret af virksomheden sidste måned, er dette system faktisk produktionsklart i dag.
Det er vigtigt at bemærke, at Intel Foundry ikke viste en fungerende AI-accelerator, men en "testchip til AI", der demonstrerer, hvordan fremtidige processorer til AI og højtydende computing kan fysisk konstrueres (eller snarere samles). Intel viser hele konstruktionsmetoden, som kombinerer store beregningsblokke, stakke af højhastighedsram, ultrahurtige chip-til-chip forbindelser og nye strømforsyningsteknologier i et enkelt teknologisk hus. Denne pakke adskiller sig markant fra hvad virksomheder som TSMC tilbyder i dag. Intel ønsker at demonstrere, at næste generations processorer til højtydende AI kan have en multi-chip design, og Intel Foundry er allerede i stand til at producere dem.
Den præsenterede platform er bygget op af fire store logiske blokke, der sandsynligvis er baseret på Intel 18A teknologi (dermed med RibbonFET transistorer med cirkulært gate og PowerVia strømsystem på bagsiden), som er omgivet af HBM4 klasse hukommelses-stakke og I/O enheder. Alle nøglekomponenter er formodentlig forbundet med EMIB-T 2.5D broforbindelser, der er integreret direkte i chipens substrate. Intel anvender EMIB-T interchip interface teknologi, som tilføjer huller i silicium inde i broerne, så strøm og signaler kan passere både vertikalt og horisontalt, for at maksimere forbindelsestæthed og strømforsyning. Platformen er designet til UCIe interkristale interfaces, der opererer ved 32 GT/s og højere, og som formodentlig også anvendes til at forbinde C-HBM4E stakke.
Testprototypen af chippen viser også Intels overgang til vertikal opbygning. Virksomhedens technology roadmap inkluderer Intel 18A-PT teknologi, der er specifikt designet til chipletter, som indebærer at placere andre logiske chips eller hukommelse ovenpå. Følgelig skal chipletterne have bagside powerforsyning og også bruge gennemgående og hybrid interconnects. I tilfælde af "testprototypen af AI-processoren" er de grundlæggende 18A-PT chips placeret under 18A/18A-P beregningschips og fungerer enten som store cache-chips eller udfører en anden støttefunktion. Til vertikal forbindelse af chipletter bruger Intel Foveros packaging teknologi familien — Foveros 2.5D, Foveros-R og Foveros Direct 3D. De muliggør en fintrinnet kobberforbindelse mellem aktive chips for at sikre maksimal båndbredde og energieffektivitet af de øverste chips. Sammen med EMIB broerne gør disse metoder det muligt for Intel at skabe en hybrid lateral-vertikal opbygning, som virksomheden positionerer som et alternativ til store silicium interposers med en højere pladeudnyttelse og udbytte.
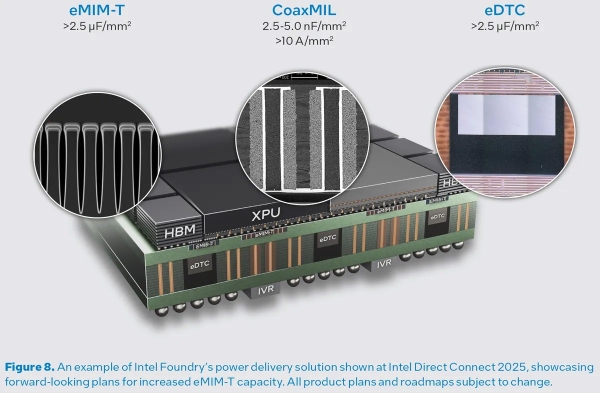
For multi-chip AI accelerators and high-performance computing, the primary design constraint is power supply. To this end, the Intel platform must integrate all of Intel's latest innovations in energy efficiency, including PowerVia, Omni MIM embedded capacitors, bridge-level isolation in EMIB-T, eDTC and eMIM-T capacitors on the base die, as well as CoaxMIL embedded inductors to support semi-integrated voltage regulators (IVR) located beneath each stack and under the housing itself (unlike IVR in TSMC's CoWoS-L, which are part of the interposer). This multi-layer network is designed to support stable current in generative AI workloads without voltage drops.
With its demonstration, Intel is clearly trying to attract customers. It remains unknown whether the next-generation AI accelerator code-named Jaguar Shores, set to launch in 2027, will utilize the architecture being showcased by Intel today.
Kilde:
Kilde: 3dnews.ru
