

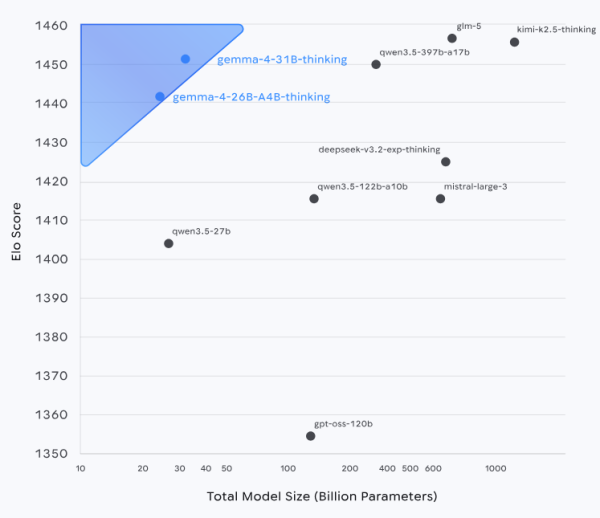
Google har offentliggjort en ny familie af store sprogmodeller, Gemma 4, baseret på Gemini 3-modellen. Gemma 4 distribueres under Apache-licensen i varianter med 2.3, 4.5, 25.2 og 30.7 milliarder parametre (E2B, E4B, 31B og 26B A4B). Varianterne E2B og E4B er velegnede til brug på mobile enheder, IoT-systemer og Raspberry Pi-boards, mens de øvrige varianter er gode til brug på arbejdsstationer og systemer med forbrugergrafikkort. Den kontekst, der tages i betragtning af modellen, er 128.000 tokens for E2B- og E4B-modellerne og 256.000 tokens for 31B- og 26B A4B-modellerne.
Modellerne er flersprogede og multimodale: de understøtter 35 sprog ud af boksen (mere end 140 sprog er brugt under træningen), og de kan på input bearbejde tekst og billeder (E2B- og E4B-modellerne understøtter desuden lydbehandling). Modellen 26B A4B er baseret på MoE-arkitekturen (Mixture-of-Experts), hvor modellen opdeles i en række ekspert-netværk (kun 3.8 milliarder parametre kan anvendes ved generering af svar, men hastigheden er betydeligt højere end klassiske store modeller), mens de øvrige varianter bruger den klassiske monolitiske arkitektur.
Modellerne understøtter ræsonnering og konfigurerbare tænkemodi, understøtter systemrolle (System Role) til behandling af instruktioner (regler, begrænsninger) adskilt fra data. Modellerne kan bruges til kodning, genkendelse af objekter på billeder, frame-for-frame analyse af video, dokument- og PDF-parsering, optisk tegngenkendelse (OCR) for trykt og håndskrevet tekst, talegenkendelse og oversættelse mellem sprog. Det er muligt at bruge dem som autonome agenter, der interagerer med forskellige værktøjer og API'er.
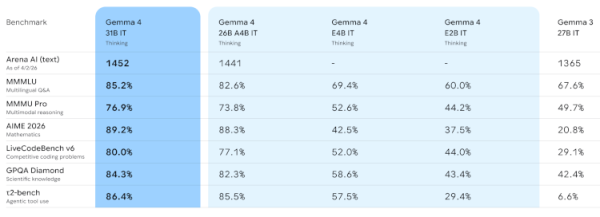
I de fleste tests har modellerne i Gemma 4-serien overgået Gemma 3-modellen med 27 milliarder parametre. Der understøttes brug af Gemma 4 med værktøjerne og bibliotekerne LiteRT-LM, vLLM, llama.cpp, MLX, Ollama, NVIDIA NIM og NeMo, LM Studio, Unsloth, SGLang, Cactus, Basetan, MaxText, Tunix og Keras.
Kilde: opennet.ru
