

Udgaven af Vortex 3.0-projektet er tilgængelig, som udvikler en åben GPGPU baseret på RISC-V instruktionsarkitekturen, designet til at udføre parallelle beregninger ved hjælp af OpenCL API og SIMT (Single Instruction, Multiple Threads) udførelsesmodellen. Projektet kan også anvendes i forskning inden for 3D-grafik og ved udvikling af nye GPU-arkitekturer. Skemaer, beskrivelser af hardwaremoduler på Verilog, simulatorer, drivere og tilhørende projektdokumentation distribueres under Apache 2.0-licensen.
GPGPU'en er baseret på en standard ISA RISC-V, udvidet med yderligere instruktioner til understøttelse af GPU-funktioner og trådstyring. Ændringer i RISC-V instruktionsarkitekturen er minimal og udnytter i videst muligt omfang de eksisterende vektor instruktioner. Blandt de ekstra instruktioner er: 'tex' til at accelerere teksturbehandling; vx_rast til at styre rasterisering, vx_rop til behandling af fragmenter, dybde og gennemsigtighed; vx_imadd til at udføre 'multiply and add' operationer; vx_wspawn, vx_split, vx_join, vx_tmc og vx_bar til at aktivere grupper af tråde (wavefronts), der udføres parallelt af SIMD Engine.
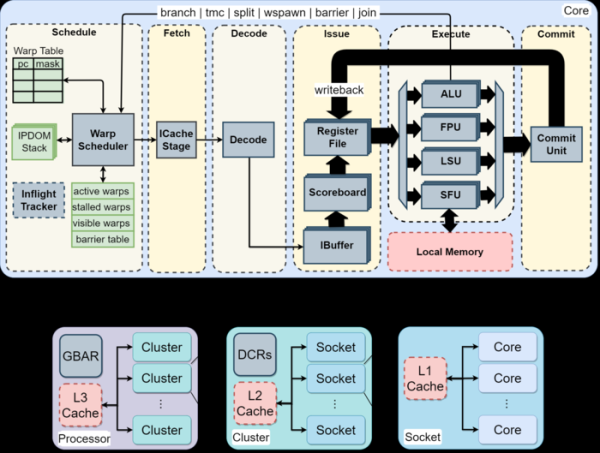
Den udviklede GPGPU understøtter 32- og 64-bit RISC-V RV32IMF og RV64IMAFD instruktionsarkitekturer og kan inkludere valgfri delt hukommelse, L1, L2 og L3 caches samt et tilpasset antal kerner, opgaveblokke (warps) og tråde. For hver kerne er der mulighed for at aktivere et tilpasset antal ALUs, FPUs, LSUs og SFUs. FPGA'er fra Xilinx og Altera kan anvendes til prototyping, mens Verilator (Verilog-simulator), RTLSIM (RTL-simulation) og SimX (software-simulation) kan anvendes til chip-simulering.
Til udvikling af applikationer tilbydes et værktøjsæt, der inkluderer varianter af PoCL (OpenCL compilator og runtime) tilpasset Vortex, LLVM/Clang, GCC og Binutils. Projektet understøtter OpenCL 1.2-specifikationen, og ved hjælp af oversættelse til OpenCL er der implementeret support for det intermediate shader-repræsentation SPIR-V.
Blandt ændringerne i Vortex 3.0:
- Der er tilføjet et hardware-grafikstack, der inkluderer blokke til rasterisering, teksturopbygning og output-sammenlægning (OM - Output Merger). Der er for Mesa, baseret på den implementerede grafikstack og den software-baserede rasterisator lavapipe, forberedt en Vulkan-driver kaldet vortexpipe.
- Mulighederne for tensorenkernen, der er designet til at accelerere udførelsen af maskinlæringsmodeller, er udvidet med support for strukturel sparsitet til komprimering af vægtmatricer.
- Operationen WGMMA (warpgroup-level matrix multiplication) er implementeret til asynkron matrixmultiplikation.
- DXA (Data Transfer Acceleration) motoren er tilføjet for at accelerere dataoverførslen fra global til lokal hukommelse.
- En ny arkitektur baseret på kommandoprocessoren (CP, Command Processor) og hardwareplanlæggeren for beregningskerner (KMU — Kernel Management Unit) er implementeret, hvilket muliggør udledning af dispatcher-operationer fra chippen.
- Et nyt runtime-bibliotek er foreslået, der arbejder i ikke-blokerende tilstand og leverer abstraktioner, der oversættes til hardware asynkrone udførte kommandoer. Der understøttes køer, hændelser, moduler og synkronisering baseret på asynkrone barrierer med semantic arrive/wait/event.
- Understøttelse af forkortede RISC-V-instruktioner (RVC) er tilføjet.
- Hardwareunderstøttelse af atomare operationer (Hardware Atomics) er implementeret.
- FPU er blevet fuldstændig redesignet, og nye multiplikatorblokke (Wallace-tree, Folded-radix) og summerblokke (Kogge-Stone) er foreslået.
- En virtuel hukommelseshukommelse baseret på hukommelsesstyringsblokken (MMU) med support for 32-bit SV32 virtuel adressering er tilføjet.
- Understøttelse af RISC-V-udvidelsen Zicond med implementering af betingede operationer.
- Kontrol af klokfrekvens (clock gating) er integreret.
- Understøttelse af HIP (Heterogeneous Interface for Portability) sprog gennem chipStar-frameworket, der oversætter HIP til SPIR-V, er implementeret.
- Der er sikret fuld integration med GEM5-simulatoren, og support for SimX simulatoren på TLM (Transaction-Level Modeling) arkitekturen er tilføjet.
- Understøttelse af Synopsys- og Yosys-værktøjer til logiksynthese til chipproduktion er tilføjet, samt støtte til brug af standardelementbiblioteker ASAP7 (7nm), SAED14 (14nm) og NanGate (15nm).
- Referenceværktøjet er blevet opdateret til LLVM 20 og POCL 7.0.
Kilde: opennet.ru
