

Som en del af Qwenputer-projektet har forskere forberedt en udvidet version af AI-modellen Qwen3.5-4B, hvor der er implementeret en indbygget simulator for en fuld 32-bit CPU baseret på RISC-V-arkitekturen (RV32IM), der understøtter Zba-udvidelsen og er udstyret med en bignum co-processor til aritmetiske operationer med store tal. Implementeringen af CPU-kernen er kompileret til et vægt-sæt og integreret i en stor sprogmodel som 11 ekstra transformer-lag, der er tilføjet før de primære lag i Qwen. Beregningerne udføres direkte under fremadrettet pas (forward pass) i neuronet, uden tilslutning af eksterne værktøjer eller plugins.
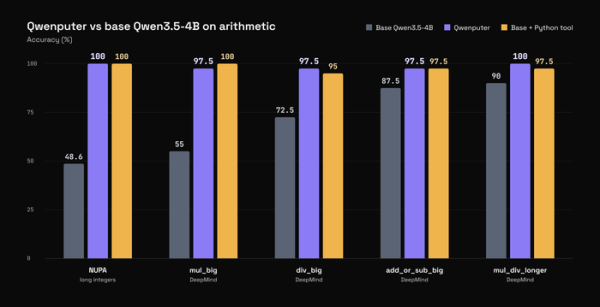
Implementeringen bestod succesfuldt alle test fra det officielle testudvalg riscv-tests og er i stand til at udføre kompilert kode i C og MicroPython. Under udførelse af aritmetiske beregninger med store tal sikrer Qwenputer en nøjagtighed på 97,5-100%, hvilket er sammenligneligt med eller overgår resultaterne fra den grundlæggende model Qwen3.5 med en tilsluttet ekstern Python-tolker.
Til simuleringen af RAM i modellen benyttes separate lag Gated DeltaNet (lineære RNN), som anvendes i den standard AI-model Qwen til at gemme ændrede tilstande, når man arbejder med store kontekstvinduer. Ved at fastlåse gate-tilstanden og anvende en unitarisk kodning (one-hot) overskriver hver skriveanmodning præcis én række i tilstands-matrixen, hvilket muliggør brugen af DeltaNet-tilstanden som adresserbar hukommelse af fast størrelse, samtidig med at man undgår lineær vækst i KV-cachen (Key-Value) ved forlængelse af konteksten. I denne hukommelse placeres CPU-registre, data og den eksekverede maskinkode.
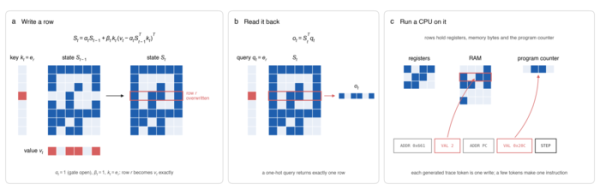
CPU-instruktioner såsom læsning af registre, aritmetiske operationer og betingede spring kompileres direkte til vægtene i transformerlagene. Hver instruktion tildeles specialtokens (ADDR, VAL, STEP), som AI-modellen fortolker som CPU-logik. Til initialisering af CPU'en og indlæsning af firmware anvendes en lille ekstern driver RvChat, men selve maskinkoden behandles helt internt i modellens vægte.
Projektets begrænsninger nævner omtrent en fordobling af størrelsen (18,8 GB) sammenlignet med den oprindelige Qwen-model, hvilket primært skyldes yderligere udfyldning af ekstra lag, der opretholder tilstandssnit (checkpoint). Derudover bemærkes en relativt lav beregningshastighed (omkring 3200 tokens per sekund på GPU L4), hvilket betyder, at komplekse beregninger kan tage sekunder i stedet for millisekunder.
Der er desuden implementeret en variant af AI-modellen med et eksperimentelt filsystem, der gør det muligt at gemme op til 512 filer med 53.000 tokens tekst inden i AI-modellens vægte. Ligesom i implementeringen af RAM er opbevaringen organiseret i forbindelse med DeltaNet-tilstande, men det adskiller sig ved, at filsystemet sikrer vedvarende opbevaring, der ikke mister tilstand mellem sessionerne.
Resultaterne fra Qwenputer har også dannet grundlag for undersøgelser af nye potentielle sikkerhedsproblemer inden for AI. Eksemplet med Qwenputer viser, hvordan en specielt modificeret AI-model kan skjule sine ræsonneringer i RNN-tilstanden og omgå overvågningsmekanismerne for modellens ræsonnering (CoT, Chain-of-Thought). Det demonstreres også
muligheden for at skabe kontrol- og overvågningsmekanismer for sikkerhed, der er indlejret i AI-modellens vægte, som modellen selv ikke kan deaktivere eller ændre.
Kilde: opennet.ru
