

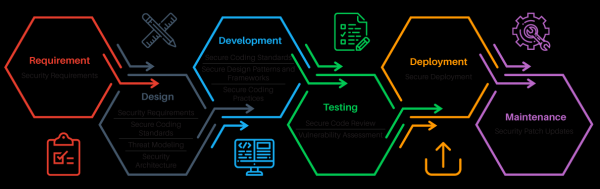
Som en del af deres professionelle arbejde skal udviklere, pentestere og sikkerhedsspecialister beskæftige sig med processer som Vulnerability Management (VM) og (Secure) SDLC.
Under disse udtryk gemmer sig forskellige sæt af praktikker og anvendte værktøjer, der er sammenflettet, selvom deres brugere varierer.
Den tekniske udvikling er endnu ikke nået dertil, hvor et enkelt værktøj kan erstatte mennesket i analysen af sikkerheden i infrastruktur og software.
Det er interessant at forstå, hvorfor det er sådan, og hvilke problemer man står overfor.
Processer
Processen Vulnerability Management („håndtering af sårbarheder“) er designet til løbende at overvåge sikkerheden i infrastruktur og patch management.
Processen Secure SDLC („sikker udviklingscyklus“) har til formål at støtte applikationens sikkerhed under udvikling og drift.
En beslægtet del af disse processer er Vulnerability Assessment-processen – evaluering af sårbarheder, scanning af sårbarheder.
Den primære forskel i scanningen inden for VM og SDLC er, at målet i første omgang er at opdage kendte sårbarheder i tredjeparts software eller i konfigurationen. For eksempel, en forældet version af Windows eller en standardcommunity-streng for SNMP.
I det andet tilfælde er målet at opdage sårbarheder ikke kun i tredjeparts komponenter (afhængigheder) men først og fremmest i koden til det nye produkt.
Dette medfører forskelle i værktøjer og tilgange. Efter min mening er opgaven med at finde nye sårbarheder i applikationen væsentligt mere interessant, da den ikke blot handler om at identificere versioner, indsamle banners, brute-force adgangskoder osv.
For kvalitetsautomatiserede scanninger af applikationers sårbarheder er der behov for algoritmer, der tager højde for applikationens semantik, formål og specifikke trusler.
En infrastrukturscanner kan ofte erstattes af et tidtagersystem, som udtrykt af Pointen er, at statistisk set kan du betragte din infrastruktur som sårbar, hvis du ikke har opdateret den, lad os sige, i en måned.
Værktøjer
Scanning, ligesom sikkerhedsanalyse, kan udføres som en black box eller white box.
Black Box
Ved blackbox-scanning skal værktøjet kunne interagere med tjenesten gennem de samme grænseflader, som brugerne arbejder med.
Infrastruktur scanner (Tenable Nessus, Qualys, MaxPatrol, Rapid7 Nexpose osv.) leder efter åbne netværksporte, indsamler 'bannere', identificerer versioner af installeret software og søger i deres vidensbase efter information om sårbarheder i disse versioner. De forsøger også at opdage konfigurationsfejl, såsom standardadgangskoder eller åben adgang til data, svage SSL-krypteringer osv.
Webapplikationsscannere (Acunetix WVS, Netsparker, Burp Suite, OWASP ZAP osv.) kan også identificere kendte komponenter og deres versioner (for eksempel CMS, frameworks, JS-biblioteker). De grundlæggende trin for scanneren er crawling og fuzzing.
Under crawling indsamler scanneren information om eksisterende grænseflader for applikationen, HTTP-parametre. Under fuzzing indtastes muterede eller genererede data i alle opdagede parametre med det formål at fremprovokere en fejl og opdage sårbarheden.
Disse applikationsscannere tilhører klasserne DAST og IAST — henholdsvis Dynamic og Interactive Application Security Testing.
White Box
Ved whitebox-scanning er der flere forskelle.
I VM-processen får scannere (Vulners, Incsecurity Couch, Vuls, Tenable Nessus osv.) ofte adgang til systemerne, hvilket involverer en autentificeret scanning. På den måde kan scanneren hente de installerede versioner af pakker og konfigurationsparametre direkte fra systemet uden at gætte dem ud fra bannere fra netværkstjenester.
Scanningen bliver mere præcis og omfattende.
Når vi taler om whitebox-scanning af applikationer (CheckMarx, HP Fortify, Coverity, RIPS, FindSecBugs osv.), handler det normalt om statisk kodeanalyse og brug af de relevante værktøjer fra klassen SAST — Static Application Security Testing.
Problemer
Der opstår mange problemer med scanning! Jeg står personligt over for de fleste af dem i løbet af mit arbejde med at etablere scanning og sikker udviklingsprocesser samt ved udførelse af opgaver relateret til sikkerhedsanalyse.
Jeg vil fremhæve 3 hovedgrupper af problemer, som bekræftes gennem samtaler med ingeniører og ledere i forskellige IT-sikkerhedstjenester i mange forskellige virksomheder.
Problemer med scanning af webapplikationer
- Sværhedsgrad i implementeringen. Scannere skal implementeres, konfigureres og tilpasses til hver applikation, der skal tildeles et testmiljø til scanningerne og integreres i CI/CD-processen for at være effektive. Ellers vil det være en meningsløs procedure, der kun giver falske positiver.
- Varighed af scanning. Scannere har i 2019 stadigvæk problemer med deduplicering af grænseflader og kan bruge dage på at scanne tusind sider med 10 parametre på hver, idet de betragter dem som forskellige, selvom den samme kode står bag. Desuden skal beslutningen om deployment til produktion træffes hurtigt i udviklingscyklussen.
- Skarpe anbefalinger. Scannere giver ofte ret generelle anbefalinger, og udvikleren kan ikke altid hurtigt forstå, hvordan han skal reducere risikoniveauet, og vigtigst, om det er nødvendigt at gøre det lige nu, eller om det kan vente.
- Destruktiv indvirkning på applikationen. Scannere kan meget vel udføre et DoS-angreb på applikationen, såvel som at kunne producere et stort antal entiteter eller ændre eksisterende (f.eks. oprette titusinder af kommentarer i en blog), så man skal ikke uden omtanke køre en scanning i produktion.
- Lav kvalitet i opdagelsen af sårbarheder. Scannere bruger normalt et fast array af nyttelaster (‘payloads’) og kan nemt overse en sårbarhed, som ikke falder ind under de kendte adfærdsscenarier, de kender.
- Manglende forståelse fra scannerens side af applikationens funktioner. Scannere ved i sig selv ikke, hvad 'internetbank', 'betaling', 'kommentar' betyder. For dem findes kun links og parametre, så en stor del af de mulige forretningslogiske sårbarheder forbliver helt dækkede; de vil ikke kunne gætte, hvordan man laver en dobbelt betaling, ser andres data via ID eller tilføjer balancen gennem afrunding.
- Manglende forståelse fra scannerens side af sidernes semantik. Scannere kan ikke læse FAQ'er, de kan ikke genkende captchas, de vil i sig selv ikke kunne gætte, hvordan man skal registrere sig, og at man derefter skal logge ind igen, at man ikke må klikke på 'logout', og hvordan man skal signere anmodninger ved ændring af parameteres værdier. Som resultat vil en stor del af applikationen forblive helt uundersøgt.
Problemer med scanning af kildekoden.
- Falske positiver. Statisk analyse er en kompleks opgave, der ofte kræver mange kompromiser. Man ender ofte med at ofre nøjagtighed, og selv dyre enterprise-scannere giver et enormt antal falske positiver.
- Sværhedsgrad i implementeringen. For at øge nøjagtigheden og fuldstændigheden af statisk analyse er det nødvendigt at forbedre scanningsreglerne, og udarbejdelsen af disse regler kan vise sig at være alt for tidskrævende. Nogle gange er det lettere at finde alle steder i koden med en fejl og rette dem, end at skrive en regel til at detektere sådanne tilfælde.
- Manglende understøttelse af afhængigheder. Store projekter er afhængige af et stort antal biblioteker og rammer, der udvider mulighederne i programmeringssproget. Hvis scannerens vidensbase ikke indeholder information om farlige steder ("sinks") i disse rammer, bliver det et blindt punkt, og scanneren vil slet ikke forstå koden.
- Varighed af scanning. At finde sårbarheder i koden er en kompleks opgave i algoritmerne. Derfor kan processen sagtens tage lang tid og kræve betydelige beregningsressourcer.
- Lav dækning. På trods af ressourceforbruget og længden af scanningerne må udviklerne af SAST-værktøjer stadig gøre kompromiser og analysere ikke alle tilstande, som programmet kan befinde sig i.
- Reproducerbarhed af fund. At angive en bestemt linje og stakken af opkald, der fører til sårbarheden, er fremragende, men i virkeligheden giver scanneren ofte ikke tilstrækkelig information til at kontrollere, om der er en sårbarhed udefra. Mangel kan også være i død kode, som er uopnåelig for angreb.
Problemer med scanning af infrastruktur.
- Utilstrækkelig opgørelse. I store infrastrukturer, især når de er geografisk adskilt, er det ofte sværest at forstå, hvilke værter der skal scannes. Med andre ord er scanningsopgaven tæt knyttet til opgaven med asset management.
- Dårlig prioritering. Netværksscannere giver ofte mange resultater med mangler, som i praksis ikke kan udnyttes, men formelt er risikoen høj. Forbrugeren modtager en rapport, der er svær at fortolke, og det er uklart, hvad der skal rettes først.
- Skarpe anbefalinger. I vidensbasen for scannere findes der ofte kun meget generel information om sårbarheder og måder at rette dem på, så administratorer må tage Google til hjælp. Situationen er lidt bedre med whitebox-scannere, som kan give en specifik kommando til at rette fejlen.
- Manuel arbejde. Der kan være mange noder i infrastrukturen, og dermed potentielt mange fejl, hvis rapporter, som man skal analysere og gennemgå manuelt ved hver iteration.
- Dårlig dækning. Kvaliteten af scanningen af infrastrukturen afhænger direkte af omfanget af vidensbasen om sårbarheder og versioner af software. Under alle omstændigheder, , selv blandt markedslederne er vidensbasen ikke udtømmende, og der findes mange oplysninger i gratis løsninger, som ikke er tilgængelige hos lederne.
- Problemer med patching. Ofte indebærer patching af sårbarheder i infrastrukturen en opdatering af pakker eller en ændring af konfigurationsfiler. Et stort problem her er, at systemet, især legacy-systemer, kan opføre sig uforudsigeligt som følge af opdateringen. I praksis må der udføres integrationstests på en live infrastruktur i produktionen.
Tilgange
Hvad skal man så gøre?
Jeg vil i de næste dele uddybe eksempler og hvordan man kan tackle mange af de nævnte problemer, men indtil da vil jeg påpege de vigtigste områder, hvor der kan arbejdes:
- Agergation af forskellige scanningværktøjer. Ved korrekt brug af flere scannere kan man opnå en betydelig forøgelse af vidensbasen og kvaliteten af detektion. Man kan finde flere sårbarheder samlet end hvad alle scannere kan finde hver for sig, samtidig med at man kan vurdere risikoniveauet mere præcist og give flere anbefalinger.
- Integration af SAST og DAST. Dækningen af DAST og præcisionen af SAST kan forbedres ved at dele information mellem dem. Fra kildekoden kan oplysninger om eksisterende ruter indsamles, mens DAST kan bruges til at kontrollere, om en sårbarhed er synlig udefra.
- Machine Learning™. I 2015 skrev jeg (og ) om anvendelsen af statistik til at give scannere hackerens intuition og fremskynde dem. Dette er bestemt en mulighed for at udvikle automatisk sikkerhedsanalyse i fremtiden.
- Integration af IAST med autotests og OpenAPI. I CI/CD-pipelines er det muligt at oprette en scanning baseret på værktøjer, der fungerer som HTTP-proxy, samt funktionelle tests, der arbejder over HTTP. Tests og OpenAPI/Swagger-kontrakter vil give scanneren den manglende information om datastreams og muliggøre scanning af applikationen i forskellige tilstande.
- Korrekt konfiguration. Der skal oprettes en passende scanningprofil for hver applikation og infrastruktur, der tager højde for antallet og arten af interfaces samt de anvendte teknologier.
- Tilpasning af scannere. Ofte er det ikke muligt at scanne applikationen uden at tilpasse scanneren. For eksempel i en betalingsgateway, hvor hver anmodning skal være underskrevet. Uden at skrive en connector til gateway-protokollen vil scannere ukritisk sende anmodninger med forkert underskrift. Derudover er det nødvendigt at skrive specialiserede scannere til specifikke typer af sårbarheder, såsom
- Risikostyring. Brugen af forskellige scannere og integration med eksterne systemer som Asset Management og Threat Management vil gøre det muligt at anvende mange parametre til at vurdere risiko niveauet, så ledelsen kan få et præcist billede af den aktuelle sikkerhedssituation for udvikling eller infrastruktur.
Hold dig opdateret, og lad os forstyrre sårbarhedsscanning!
Kilde: habr.com
