

Koden til softwareprodukter til maskinlæring kan ofte være kompleks og ret forvirrende. At opdage og løse fejl i det er en ressourcekrævende opgave. Selv de simpleste kræver en seriøs tilgang til netværksarkitektur, initialisering af vægte og optimering af netværket. En lille fejl kan føre til ubehagelige problemer.
Denne artikel beskæftiger sig med algoritmen til fejlfinding af dine neurale netværk.
Skillbox anbefaler: Praktisk kursus .
Vi minder om: til alle læsere af 'Habr' — rabat på 10.000 rubler ved tilmelding til et hvilket som helst Skillbox-kursus med rabatkoden 'Habr'.
Algoritmen består af fem trin:
- simpel start;
- bekræftelse af tab;
- kontrol af mellemliggende resultater og forbindelser;
- diagnostik af parametre;
- overvågning af arbejdet.
Hvis du finder noget mere interessant end andet, kan du straks gå videre til de afsnit.
Simpel start
Det er sværere at debugge et neuralt netværk med kompleks arkitektur, regulering og læringshastighedsplanlægger end et almindeligt. Vi er her lidt snedige, da dette punkt har en indirekte relation til fejlfinding, men det er stadig et vigtigt råd.
Simpel start indebærer at oprette en forenklet model og træne den på et enkelt datasæt (punkt).
Først opretter vi en forenklet model
For en hurtig start laver vi et lille netværk med et enkelt skjult lag og kontrollerer, at alt fungerer korrekt. Derefter komplicerer vi gradvist modellen, mens vi kontrollerer hver ny aspekt af dens struktur (ekstra lag, parameter, osv.) og fortsætter.
Vi træner modellen på et enkelt datasæt (punkt)
Som en hurtig kontrol af din projekts funktionalitet kan du bruge en eller to datapunkter til træning for at bekræfte, at systemet fungerer korrekt. Det neurale netværk skal vise 100% nøjagtighed i træningen og valideringen. Hvis ikke, så er enten modellen for lille, eller der er allerede en fejl.
Selv hvis alt ser godt ud, skal du forberede modellen til at gennemgå en eller flere epoker, før du går videre.
Evaluering af tab
Evaluering af tab er den primære måde at finjustere modelens ydeevne. Du skal sikre dig, at tabet stemmer overens med opgaven, og at tabfunktionerne vurderes på korrekt skala. Hvis du bruger mere end én type tab, skal du sikre, at de alle er af samme rækkefølge og korrekt skalerede.
Det er vigtigt at være opmærksom på de indledende tab. Tjek, hvor tæt det faktiske resultat er på det forventede, hvis modellen startede med en tilfældig antagelse. I : «Sørg for, at du får det resultat, der forventes, når du starter med et lille antal parametre. Det er bedst at tjekke datatab med det samme (med reguleringsgraden sat til nul). For eksempel, for CIFAR-10 med en Softmax-klassificerer forventer vi, at de indledende tab vil være 2.302, fordi den forventede diffuse sandsynlighed er 0,1 for hver klasse (da der er 10 klasser), og Softmax-tabet er den negative logaritmiske sandsynlighed for den korrekte klasse som -ln(0,1) = 2.302».
For et binært eksempel laves en tilsvarende beregning for hver af klasserne. Her er for eksempel data: 20% 0'ere og 80% 1'ere. Den forventede indledende tab vil være op til -0,2ln(0,5) - 0,8ln(0,5) = 0,693147. Hvis resultatet er over 1, kan det indikere, at vægtene i neuronet ikke er korrekt balanceret, eller at dataene ikke er normaliseret.
Vi tjekker mellemresultaterne og forbindelserne
For at debugge neuronet er det nødvendigt at forstå dynamikken i processerne inden i netværket og rollen af de enkelte mellem-lag, da de er sammenkoblede. Her er typiske fejl, du kan støde på:
- forkerte udtryk for gradientopdateringer;
- vægtopdateringer anvendes ikke;
- forsvindende eller eksploderende gradients (exploding gradients).
Hvis gradientværdierne er nul, betyder det, at læringshastigheden i optimizeren er for lav, eller at du er blevet mødt med et ukorrekt udtryk for gradientopdateringen.
Derudover er det nødvendigt at holde øje med værdierne af aktiveringsfunktioner, vægte og opdateringer i hvert af lagene. For eksempel bør opdateringsstørrelsen af parametrene (vægte og bias) .
Der findes et fænomen, der kaldes “Dying ReLU” eller , når ReLU-neuronerne vil returnere nul efter at have lært en stor negativ bias-værdi for deres vægte. Disse neuroner aktiveres aldrig igen i nogen af dataene.
Du kan bruge gradientkontrol til at identificere disse fejl ved at approximere gradienten ved hjælp af en numerisk tilgang. Hvis den er tæt på de beregnede gradienter, er tilbagepropageringen blevet implementeret korrekt. For at oprette en gradientkontrol kan du se på disse fremragende ressourcer fra CS231. og , samt med af Andrew Ng om dette emne.
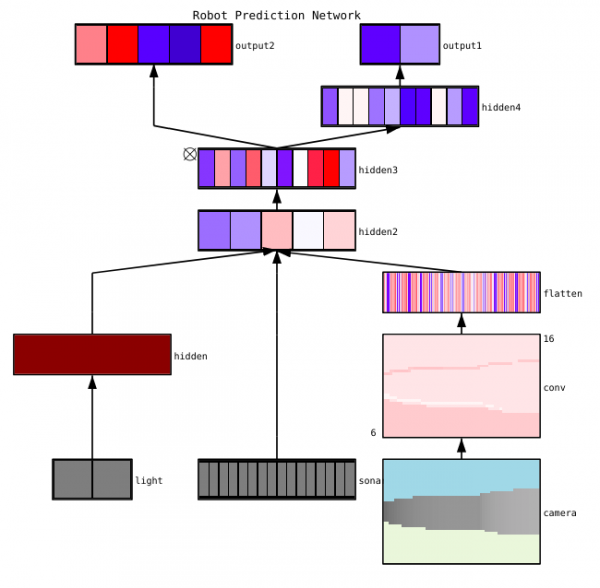
peger på tre hovedmetoder til visualisering af neurale netværk:
- Forhåndsvisninger - enkle metoder, der viser os den generelle struktur af den trænede model. De inkluderer visning af former eller filtre fra enkelte lag i det neurale netværk og parametrene i hvert lag.
- Aktiveringsbaserede metoder. Her decodes vi aktiveringerne af enkelte neuroner eller grupper af neuroner for at forstå deres funktioner.
- Gradientbaserede metoder. Disse metoder har en tendens til at manipulere med gradienterne, der dannes fra fremad- og bagudgang under modeltræning (inklusive betydningskort og aktiveringskort for klassen).
Der er flere nyttige værktøjer til visualisering af aktiveringer og forbindelser fra enkelte lag, såsom og .
Parameterdiagnostik
Neurale netværk har mange parametre, der interagerer med hinanden, hvilket komplicerer optimeringen. Egentlig er dette afsnit genstand for aktiv forskning af specialister, så de forslag nedenfor bør betragtes som råd, udgangspunkter at basere sig på.
Batch størrelse (batch size) - det er nødvendigt at have en batch størrelse, der er stor nok til at opnå præcise vurderinger af fejlgradienten, men tilstrækkelig lille, så stochastisk gradient descent (SGD) kan sortere dit netværk. Små batch størrelser vil føre til hurtig konvergens på grund af støj i læringsprocessen og i fremtiden - vanskeligheder med optimering. Dette er beskrevet nærmere .
Læringshastighed - for lav vil føre til langsom konvergens eller risiko for at sidde fast i lokale minima. Samtidig vil en høj læringshastighed forårsage divergence i optimeringen, da du risikerer at "springe" over en dyb, men smal del af tabsfunktionen. Prøv at bruge læringsplanlægning for at reducere den under træningen af det neurale netværk. I kursus CS231n. .
Gradient clipping — beskæring af gradienter af parametre under backpropagation til maksimal værdi eller grænseværdinorm. Nyttigt til at løse problemer med eventuelle eksploderende gradienter, som du kan støde på i punkt tre.
Batch normalisering — bruges til at normalisere inputdataene for hver lag, hvilket løser problemet med intern covariate shift. Hvis du bruger Dropout og Batch Normal sammen, .
Stokastisk gradientnedstigning (SGD) — der findes flere varianter af SGD, der bruger momentum, adaptive læringshastigheder og Nesterovs metode. Ingen af dem har dog en klar fordel i hverken træningseffektivitet eller generalisering ().
Regulering — er afgørende for at bygge en generaliserbar model, da det tilføjer en straf for modelkompleksitet eller ekstreme værdier af parametre. Det er en måde at reducere modelens varians uden væsentlig stigning i dens bias. Flere .
For at vurdere alt selv, skal du deaktivere regulering og kontrollere gradienten for datatab selv.
Dropout — endnu en metode til at regulere dit netværk for at forhindre overbelastning. Under træning udføres dropout kun ved at opretholde neuron's aktivitet med en given sandsynlighed p (hyperparameter) eller ved at sætte den til nul i modsat tilfælde. Som et resultat skal netværket bruge et andet subset af parametre for hver træningsparti, hvilket reducerer variationer i bestemte parametre, der bliver dominerende.
Vigtigt: hvis du bruger både dropout og batch normalisering, vær opmærksom på rækkefølgen af disse operationer eller endda deres samtidige brug. Dette er stadig under aktiv debat og supplerer hinanden. Her er to vigtige diskussioner om emnet og .
Arbejdsstyring
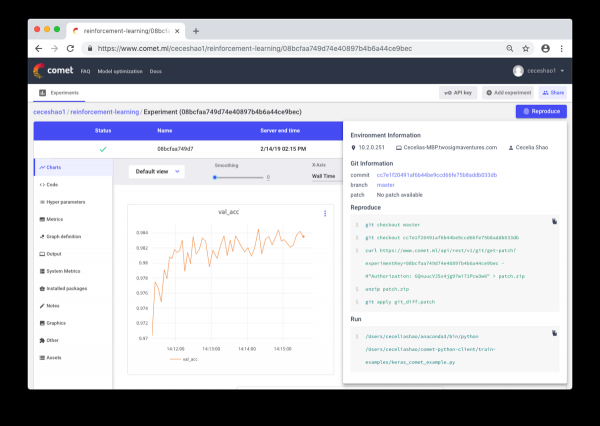
Det handler om at dokumentere arbejdsprocesser og eksperimenter. Hvis man ikke dokumenterer noget, kan man glemme, for eksempel hvilken læringshastighed eller vægt på klasser der anvendes. Takket være kontrol kan man nemt gennemse og reproducere tidligere eksperimenter. Dette gør det muligt at reducere antallet af duplikerede eksperimenter.
Sandt nok kan manuel dokumentation blive en udfordring, hvis mængden af arbejde er stor. Her kommer værktøjer som Comet.ml til hjælp, som automatisk logger datasæt, kodeændringer, historien om eksperimenter og produktionsmodeller, inklusive nøgleoplysninger om din model (hyperparametre, modelpræstationsmålinger og oplysninger om miljøet).
Neurale netværk kan være meget følsomme overfor små ændringer, hvilket kan føre til faldende modelpræstation. At overvåge og dokumentere arbejdet er det første skridt, man bør tage for at standardisere miljøet og modellere.
Jeg håber, at dette indlæg kan blive et udgangspunkt, hvorfra du kan begynde at fejlfinde dit neurale netværk.
Skillbox anbefaler:
- Toårigt praktisk kursus .
- Online kursus .
- Praktisk års kursus .
Kilde: habr.com
