

Introduktion
I denne artikel vil jeg fortælle om den velkendte Huffman-algoritme samt dens anvendelse til datakomprimering.
Som et resultat vil vi skrive en simpel arkiveringsprogram. Dette har allerede været , men uden praktisk implementering. Det teoretiske materiale i dette indlæg er taget fra skolelektioner i informatik og Robert Lafore's bog "Data Structures and Algorithms in Java". Så lad os komme i gang!
Nogle overvejelser
I en almindelig tekstfil kodes et tegn med 8 bit (ASCII-kodning) eller 16 (Unicode-kodning). Vi vil her fokusere på ASCII-kodning. Som eksempel tager vi strengen s1 = "SUSIE SAYS IT IS EASYn". I alt er der 22 tegn i strengen, inklusive mellemrum og tegn, der angiver linjeskift — 'n'. En fil, der indeholder denne streng, vil veje 22*8 = 176 bit. Spørgsmålet opstår straks: er det rationelt at bruge alle 8 bit til kodning af 1 tegn? Vi bruger jo ikke alle tegnene i ASCII-kodningen. Selv hvis vi gjorde, ville det være mere rationelt at give det mest almindelige bogstav — S — den kortest mulige kode, mens det sjældneste bogstav — T (eller U, eller 'n') — ville få en længere kode. Det er her Huffman-algoritmen kommer ind: man skal finde den optimale kodningsvariant, hvor filen vejer mindst muligt. Det er helt normalt, at længden af koden for forskellige symboler varierer — det er grundlaget for algoritmen.
Kodning
Hvorfor skulle symbolet 'S' ikke få en kode, for eksempel en længde på 1 bit: 0 eller 1. Lad os sige, at det er 1. Så skal vi give den næstmest almindelige symbol — ' ' (mellemrum) — 0. Forestil dig, at du begyndte at dekode dit budskab — den kodede streng s1 — og ser, at koden starter med 1. Så hvad skal man gøre: er det tegnet S, eller er det et andet symbol, for eksempel A? Derfor opstår der en vigtig regel:
Ingen kode skal være et præfiks for en anden
Denne regel er central i algoritmen. Derfor begynder oprettelsen af koder med en frekvenstabel, der angiver frekvensen (antal forekomster) af hvert symbol:
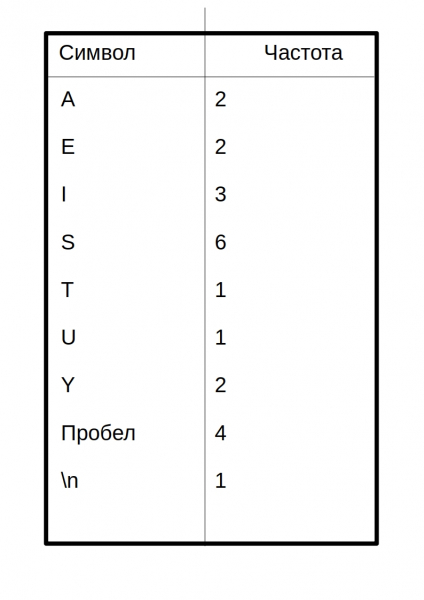 Symboler med det højeste antal forekomster skal kodes med det mindste mulige antal bits. Her er et eksempel på en mulig kodetabel:
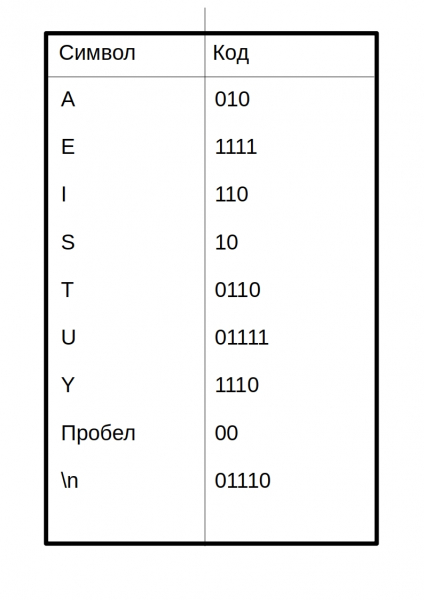 Således vil den kodede besked se sådan ud:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Koden for hvert symbol er adskilt af et mellemrum. I en komprimeret fil vil dette ikke være tilfældet!
Spørgsmålet opstår: hvordan kom denne nybegynder på idéen om at skrive en kode til at oprette kode-tabeller? Dette vil blive uddybet nedenfor.
Opbygning af Huffman-træ
Her træder binære søgetræer til hjælp. Bekymr dig ikke, her vil metoder til søgning, indsættelse og sletning ikke være nødvendige. Her er strukturen for træet i Java:
public class Node {
    private int frekvens;
    private char bogstav;
    private Node venstreBørn;
    private Node højreBørn;
    ...
}
class BinaryTree {
    private Node rod;

    public BinaryTree() {
        rod = new Node();
    }
    public BinaryTree(Node rod) {
        this.rod = rod;
    }
    ...
}
Dette er ikke hele koden, den komplette kode vil komme senere.
Her er selve algoritmen til opbygning af træet:
- Opret et Node-objekt for hvert tegn fra beskeden (streng s1). I vores tilfælde vil der være 9 noder (Node-objekter). Hver node består af to dat felter: tegn og frekvens.
- Opret et BinaryTree-objekt for hver af Node-noderne. Noden bliver rod af træet.
- Indsæt disse træer i en prioritetskø. Jo lavere frekvens, desto højere prioritet. På denne måde vælges det træ med den laveste frekvens ved udtræk.
Dernæst skal du gentagne gange udføre følgende:
- Træk to træer fra prioritetskøen og gør dem til efterkommere af en ny node (den nyoprettede node uden bogstav). Frekvensen af den nye node er summen af frekvenserne af de to efterkommertræer.
- For denne node skal du oprette et træ med roden i denne node. Indsæt dette træ tilbage i prioritetskøen. (Da træet har en ny frekvens, vil det sandsynligvis indtage en ny position i køen.)
- Fortsæt med at udføre trin 1 og 2, indtil der kun er ét træ tilbage i køen - Huffman-træet.
Lad os se på denne algoritme på strengen s1:
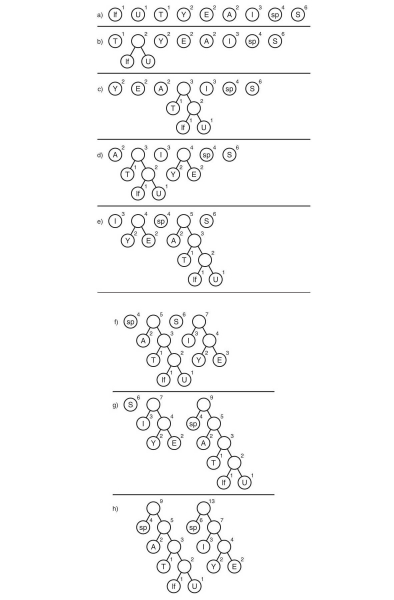
Her betyder symbolet «lf» (linjeskift) skift til en ny linje, «sp» (mellemrum) er et mellemrum.
Og hvad så?
Vi har fået Huffman-træet. Nå ok. Hvad skal vi så gøre med det? Endda det ville ikke være gratis. Derudover skal vi spore alle mulige veje fra roden til bladene af træet. Lad os være enige om at betegne en kant med 0, hvis det fører til det venstre barn, og 1 - hvis det fører til det højre. Strengt taget i denne notering, er koden for et symbol vejen fra roden af træet til bladet, der indeholder det pågældende symbol.
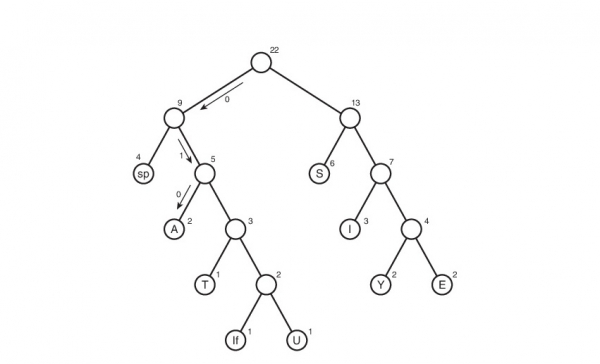
På den måde blev kode-tabellen til. Lad os bemærke, at hvis vi ser på denne tabel, kan vi konkludere om "vægten" af hvert tegn - det er længden af dets kode. Således vil den komprimerede version af den originale fil veje: 2 * 3 + 2 * 4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bits. I starten vejede den 176 bits. Derfor har vi reduceret den med 176/65 = 2.7 gange! Men det er utopi. En sådan koefficient vil næppe blive opnået. Hvorfor? Det vil vi tale om lidt senere.
Dekodning
Nå, så er det tilbage at tage fat på den simpleste opgave - dekodning. Jeg tror, mange af jer har gættet, at man ikke bare kan lave en komprimeret fil uden nogen indikation på, hvordan den blev kodet - vi vil ikke kunne dekode den! Ja, det var svært for mig at forstå, men vi må oprette en tekstfil table.txt med komprimeringstabellen:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
At nedskrive tabellen i formen 'tegn'«kode for tegn». Hvorfor 01110 uden tegn? Faktisk har den et tegn, det er bare de Java-værktøjer, jeg brugte til at skrive til filen, konverterer tegn for newline 'n' til en newline (uanset hvor dumt det lyder). Derfor er den tomme linje der, og det er tegnet for koden 01110. For koden 00 er tegnet et mellemrum i starten af linjen. Jeg må straks sige, at vores koefficient er dødsdømt - denne måde at gemme tabellen på kan anses for den mest uforholdsmæssige. Men den er let at forstå og implementere. Jeg ser frem til jeres forslag i kommentarerne vedrørende optimering.
Med denne tabel er det meget enkelt at dekode. Lad os mindes, hvilken regel vi fulgte, da vi oprettede kodningen:
Ingen kode må være et præfiks for en anden
Her spiller det en lettende rolle. Vi læser bit for bit, og så snart den resulterende streng d, bestående af de læste bits, svarer til kodningen, der svarer til tegnet character, ved vi straks, at tegnet character er blevet kodet (og kun det!). Derefter skriver vi character til den dekodede streng (strengen, der indeholder den dekodede besked), nulstiller strengen d og læser videre i den kodede fil.
Implementering
Det er tid til at ydmyge min kode og skrive en kompressor. Lad os kalde den Compressor.
Lad os starte fra begyndelsen. Først skriver vi klassen Node:
public class Node {
    private int frekvens; // frekvens
    private char bogstav; // bogstav
    private Node venstreBarn; // venstre barn
    private Node højreBarn; // højre barn

    public Node(char bogstav, int frekvens) { // konstruktør
        this.bogstav = bogstav;
        this.frekvens = frekvens;
    }

    public Node() {} // overbelastning af konstruktør til navnløse noder (se ovenfor i afsnittet om opbygning af Huffman-træet)
    public void tilføjBarn(Node nytBarn) { // tilføj barn
        if (venstreBarn == null) // hvis venstre er tom => højre også tom => tilføj i venstre
            venstreBarn = nytBarn;
        else {
            if (venstreBarn.getFrekvens() <= nytBarn.getFrekvens()) // generelt, venstre barn
                højreBarn = nytBarn; // vil blive den med lavere frekvens
            else {
                højreBarn = venstreBarn;
                venstreBarn = nytBarn;
            }
        }

        frekvens += nytBarn.getFrekvens(); // samlet frekvens
    }

    public Node getVenstreBarn() {
        return venstreBarn;
    }

    public Node getHøjreBarn() {
        return højreBarn;
    }

    public int getFrekvens() {
        return frekvens;
    }

    public char getBogstav() {
        return bogstav;
    }

    public boolean erBlad() { // kontrol af blad
        return venstreBarn == null && højreBarn == null;
    }
}
Nu træet:
class BinaryTree {
    private Node rod;

    public BinaryTree() {
        rod = new Node();
    }

    public BinaryTree(Node rod) {
        this.rod = rod;
    }

    public int getFrekvens() {
        return rod.getFrekvens();
    }

    public Node getRod() {
        return rod;
    }
}
Prioritetskø:
import java.util.ArrayList; // ja-ja, køen vil være baseret på en liste

class PriorityQueue {
    private ArrayList data; // liste over køen
    private int nElem; // antal elementer i køen

    public PriorityQueue() {
        data = new ArrayList();
        nElem = 0;
    }

    public void indsæt(BinaryTree nytTræ) { // indsættelse
        if (nElem == 0)
            data.add(nytTræ);
        else {
            for (int i = 0; i  nytTræ.getFrekvens()) { // hvis frekvensen af det indsatte træ er mindre
                    data.add(i, nytTræ); // end frekvensen af det nuværende, så flytter vi alle træer til højre med 1 position
                    break; // derefter sætter vi det nye træ på pladsen
                }
                if (i == nElem - 1)
                    data.add(nytTræ);
            }
        }
        nElem++; // øger antallet af elementer med 1
    }

    public BinaryTree fjern() { // fjernelse fra køen
        BinaryTree tmp = data.get(0); // kopierer det fjernede element
        data.remove(0); // fjerner det
        nElem--; // mindsker antallet af elementer med 1
        return tmp; // returnerer det fjernede element (elementet med den mindste frekvens)
    }
}
Klassen, der opretter Huffman-træet:
offentlig klasse HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // længde af kodningstabellen
    private String myString; // besked
    private BinaryTree huffmanTree; // Huffman-træ
    private int[] freqArray; // frekvenstabel
    private String[] encodingArray; // kodningstabel

    // ----------------constructor----------------------
    offentlig HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    // --------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    // ------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // algoritmen er beskrevet ovenfor
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // hvis symbolet eksisterer i strengen
                Node newNode = new Node((char) i, freqArray[i]); // så skal der oprettes en Node for det
                BinaryTree newTree = new BinaryTree(newNode); // og for Node skal der oprettes et BinaryTree
                pq.insert(newTree); // indsætte i køen
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // hente det første træ fra køen.

            try {
                BinaryTree tree2 = pq.remove(); // hente det andet træ fra køen

                Node newNode = new Node(); // oprette en ny Node
                newNode.addChild(tree1.getRoot()); // gøre de to hentede træer til efterkommere
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) { // der er kun et træ tilbage i køen
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    // -------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // fyld kodningstabellen
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // til debugging
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Kodningstabel====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    // -----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
Klassen, der indeholder, som kodar/afkodar:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // længde på tabellen
    private HuffmanTree mainHuffmanTree; // Huffman-træet (bruges kun til komprimering)
    private String myString; // original besked
    private int[] freqArray; // frekvenstabel
    private String[] encodingArray; // kodningstabel
    private double ratio; // komprimeringsforhold


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // til komprimering
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // til udtræk;

    // ---------------------------------------komprimering-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // mellemstreng (uden ekstra nuller)
        // System.out.println("=============================Komprimering=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // skal tilføje nuller til slutningen (kan være 1, ikke forskel)
        byte counter = 0; // antal tilføjede nuller til slutningen (1 byte er rigeligt: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta ; counter++) { // delta - antal tilføjede nuller
            intermidiate += "0";
        }

        // sammenkæd antal tilføjede nuller i binær repræsentation og mellemstrengen
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // idealiseret forhold
        setCompressionRatio();
        // System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // beregn det idealiserede forhold
        double sumA = 0, sumB = 0; // A - den originale sum
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // slutkomprimering
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    // ---------------------------------------slut på komprimering----------------------------------------------------------------
    // ------------------------------------------------------------udtræk-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        // displayEncodingArray();
        // få antal indlagte nuller
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            // i = 8, fordi den første byte indeholder antal indlagte nuller
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // hvis det stemmer
                    decompressed += (char)j; // så tilføj elementet
                    current = ""; // og nulstille den nuværende streng
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // til fejlfinding
        System.out.println("======================Kodningstabel====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            // if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            // }
        }
        System.out.println("========================================================");
    }
}
En klasse, der letter filskrivning:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Ugyldig sti, eller filen eksisterer ikke!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
En klasse, der letter fillæsning:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // hvis filen er slut
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
Og hovedklassen:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { //Angiv instruktion med kommandolinjeargumenter
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Ugyldigt indtastningsformat for argumenter ");
            System.out.println("Læs Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Ugyldig sti, eller filen eksisterer ikke!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("Den nuværende filkode understøttes ikke");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        //Opret fil med kodetabel:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Sti til den komprimerede fil: " + compressedFile.getAbsolutePath());
        System.out.println("Sti til kodetabellen " + table.getAbsolutePath());
        System.out.println("Uden tabellen vil filen være umulig at udtrække!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; //idealiseret forhold
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; //reelt forhold

        System.out.println("Det idealiserede komprimeringsforhold er " + idealRatio);
        System.out.println("Komprimeringsforholdet under hensyntagen til kodetabellen " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        //læs komprimeret fil
        //!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!kontroller her:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); //metode returnerer EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        //--------------------

        //læs kodetabel:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); //spring den første tomme streng over
        	encodingArray[(byte)'n'] = fi.readLine(); //læs kode for 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        //udtræk:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Sti til den udpakkede fil " + extractedFile.getAbsolutePath());
    }
}
Du skal selv skrive readme.txt-instruktionsfilen 🙂
Konklusion
Måske er det alt, hvad jeg ville sige. Hvis du har noget at sige om min inkompetence med forbedringer i koden, algoritmen eller generelt enhver optimering, så skriv endelig. Hvis jeg har undladt at forklare noget, så skriv også. Jeg ser frem til at høre fra dig i kommentarerne!
P.S.
Ja- ja, jeg er stadig her, for jeg har ikke glemt forholdet. For strengen s1 vejer kodningstabellen 48 byte — meget mere end den oprindelige fil, og vi har ikke glemt de ekstra nuller (antallet af tilføjede nuller er 7) => kompressionsforholdet vil være mindre end én: 176/(65 + 48*8 + 7)=0.38. Hvis du også har bemærket det, så kun ét på ansigtet, du er dygtig. Ja, denne implementering vil være ekstremt ineffektiv for små filer. Men hvad sker der med store filer? Filstørrelserne overstiger langt størrelsen af kodningstabellen. Her fungerer algoritmen som den skal! For eksempel for giver arkiveringsprogrammet en reel (ikke idealiseret) kompressionsfaktor på 1.46 — næsten halvanden gang! Og ja, det var meningen, at filen skulle være på engelsk.
Kilde: habr.com
