

Hva vi vil fortelle om:
Hvordan raskt sette opp et felles lager for to servere basert på løsninger drbd+ocfs2.
Hvem dette vil være nyttig for:
Tutorialen vil være nyttig for systemadministratorer og alle som velger en metode for å implementere lager eller ønsker å prøve løsningen.
Hvilke løsninger vi har avvist og hvorfor
Ofte står vi overfor situasjonen der vi må implementere et felles lager med god ytelse for lesing — skriving på en liten web-klynge. Vi har prøvd ulike varianter av felles lager for prosjektene våre, men lite har vært i stand til å tilfredsstille oss umiddelbart på flere kriterier. Nå vil vi fortelle hvorfor.
- Glusterfs tilfredsstilte ikke våre krav til lesing og skriving, det oppsto problemer med samtidig lesing av et stort antall filer, og det var høy belastning på CPU-en. Problemet med å lese filer kunne løses ved å gå direkte til brick-ene, men dette er ikke alltid praktisk og generelt sett feil.
- Ceph falt i utvalg på grunn av sin unødvendige kompleksitet, som kan være skadelig i prosjekter med 2-4 servere, spesielt hvis prosjektet senere skal vedlikeholdes. Igjen er det betydelige ytelsesbegrensninger som tvinger fram oppbygging av separate lagringsklynger, akkurat som med glusterfs.
- Bruk av en enkelt nfs-server for implementering av felles lager reiser spørsmål om feiltoleranse.
- s3 — en utmerket populær løsning for visse oppgaver, men det er heller ikke et filsystem, noe som begrenser bruksområdene.
- lsyncd. Hvis vi allerede har begynt å snakke om «ikke-filsystemer», bør vi også ta en gjennomgang av denne populære løsningen. Ikke bare passer den ikke for toveis utveksling (men hvis man virkelig ønsker det, kan det gjøres), men den fungerer også ustabilt med et stort antall filer. En annen ulempe er at den er entrådet. Årsaken ligger i programmets arkitektur: den bruker inotify for å overvåke objekter i drift, som den smetter inn ved oppstart og ved ny skanning. Rsync brukes som overføringsmiddel.
Tutorial: hvordan sette opp et felles lager basert på drbd+ocfs2
En av de mest praktiske løsningene for oss ble kombinasjonen ocfs2+drbd. Vi vil nu fortælle, hvordan man hurtigt kan oprette en delt lagerløsning for to servere baseret på dataløsninger. Men først lidt om komponenterne:
DRBD — en lagringssystem fra standardleverancen af Linux, der gør det muligt at replikere data mellem servere i blokke. Den primære anvendelse er i opbygningen af fejltolerante lagre.
OCFS2 — et filsystem, der muliggør deling af den samme lagerløsning mellem flere systemer. Det indgår i leverancen af Linux og består af en kernelmodul og userspace værktøj til at arbejde med filsystemet. OCFS2 kan bruges ikke kun oven på DRBD, men også oven på iSCSI med flere forbindelser. I vores eksempel bruger vi DRBD.
Alle handlinger udføres på ubuntu server 18.04 i en minimal konfiguration.
Trin 1. Konfigurer DRBD:
I filen /etc/drbd.d/drbd0.res beskriver vi vores virtuelle blokenhed /dev/drbd0:
resource drbd0 {
    syncer { rate 1000M; }
    net {
        allow-two-primaries;
        after-sb-0pri discard-zero-changes;
        after-sb-1pri discard-secondary;
        after-sb-2pri disconnect;
    }
    startup { become-primary-on both; }
    on drbd1 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.192:7789;
}
    on drbd2 {
        meta-disk internal;
        device /dev/drbd0;
        disk /dev/vdb1;
        address 10.10.10.193:7789;
}
}
meta-disk internal — bruge de samme blokenheder til at lagre metadata
device /dev/drbd0 — brug /dev/drbd0 som sti til drbd.
disk /dev/vdb1 — brug /dev/vdb1
syncer { rate 1000M; } — bruge en gigabit båndbredde på kanalen
allow-two-primaries — en vigtig mulighed, der tillader ændringer at blive accepteret på to primære servere
after-sb-0pri, after-sb-1pri, after-sb-2pri — muligheder, der beskriver nodens handlinger ved opdagelse af splitbrain. Du kan finde flere oplysninger i dokumentationen.
become-primary-on both — sætter begge noder som primære.
I vores tilfælde har vi to helt identiske VM'er, med et dedikeret virtuelt netværk med en båndbredde på 10 gigabit.
I vores eksempel er netværksnavnene for de to noden i klyngen drbd1 og drbd2. For korrekt funktion skal du matche navne og IP-adresser i /etc/hosts.
10.10.10.192 drbd1
10.10.10.193 drbd2
Trin 2. Konfigurer noderne:
På begge servere udfører vi:
drbdadm create-md drbd0 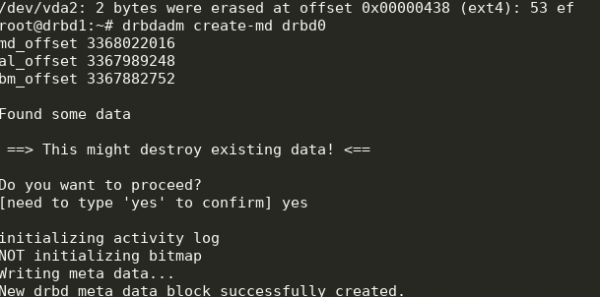
modprobe drbd
drbdadm up drbd0
cat /proc/drbd
Vi får følgende:
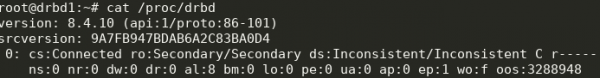
Vi kan starte synkroniseringen. På den første node skal du udføre:
drbdadm primary --force drbd0Tjek status:
cat /proc/drbd 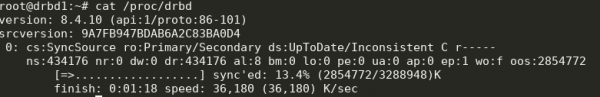
Perfekt, synkroniseringen er startet. Vi venter på, at det afsluttes, og ser resultatet:
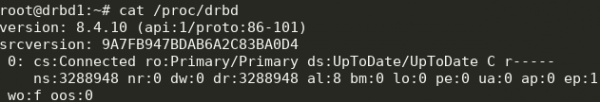
Trin 3. Starter synkronisering på den anden node:
drbdadm primary --force drbd0
Vi får følgende:
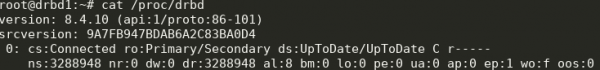
Nu kan vi skrive til drbd fra to servere.
Trin 4. Installation og konfiguration af ocfs2.
Vi bruger en ganske triviel konfiguration:
cluster:
     node_count = 2
     name = ocfs2cluster

node:
     number = 1
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.192
     name = drbd1

node:
     number = 2
     cluster = ocfs2cluster
     ip_port = 7777
     ip_address = 10.10.10.193
     name = drbd2
Den skal skrives til /etc/ocfs2/cluster.conf på begge noder.
Opretter FS på drbd0 på en hvilken som helst node:
mkfs.ocfs2 -L "testVol" /dev/drbd0
Her har vi oprettet FS med etiketten testVol på drbd0 ved at bruge standardindstillingerne.
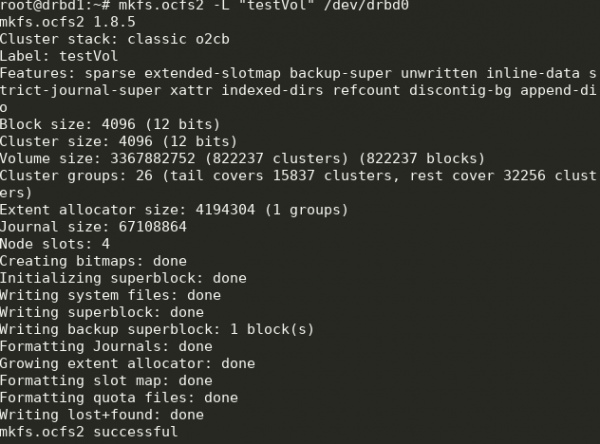
I /etc/default/o2cb skal der sættes (som i vores konfigurationsfil)
O2CB_ENABLED=true
O2CB_BOOTCLUSTER=ocfs2cluster
og udføre på hver node:
o2cb register-cluster ocfs2clusterDerefter aktiverer vi og tilføjer til automatisk opstart alle nødvendige enheder:
systemctl enable drbd o2cb ocfs2
systemctl start drbd o2cb ocfs2
En del af dette vil allerede være startet under konfigurationen.
Trin 5. Tilføjer monteringspunkter i fstab på begge noder:
/dev/drbd0 /media/shared ocfs2 defaults,noauto,heartbeat=local 0 0Biblioteket /media/shared skal oprettes på forhånd.
Her bruger vi indstillingerne noauto, hvilket betyder, at FS ikke vil blive monteret ved opstart (jeg foretrækker at montere netværksfiler gennem systemd) og heartbeat=local, hvilket betyder brugen af heartbeat-tjenesten på hver node. Der findes også en global heartbeat, som er bedre egnet til større klynger.
Derefter kan vi montere /media/shared og kontrollere synkroniseringen af indhold.
Færdig! Som resultat får vi et mere eller mindre fejltolerant lager med mulighed for skalering og anstændig ydeevne.
Kilde: habr.com
