

Filosofisk indledning
Som bekendt findes der kun to metoder til at løse opgaver:
- Analysemethodik eller deduktiv metode, fra det generelle til det specifikke.
- Syntesemetode eller induktiv metode, fra det specifikke til det generelle.
For at løse problemet 'forbedre databasens ydeevne' kan dette se således ud.
Analyse — vi analyserer problemet i separate dele og forsøger at forbedre databasens ydeevne som helhed.
I praksis ser analysen omtrent således ud:
- Der opstår et problem (ydelsesincident)
- Vi indsamler statistisk information om databasens tilstand
- Vi leder efter flaskehalse
- Vi løser problemerne ved flaskehalsene
Databasens flaskehalse — infrastruktur (CPU, Hukommelse, Diske, Netværk, OS), indstillinger (postgresql.conf), forespørgsler:
Infrastruktur: mulighederne for indvirkning og ændringer for ingeniøren — næsten nul.
Databaseindstillinger: mulighederne for ændringer er lidt større end i det foregående tilfælde, men som regel ret besværlige, især i skyen.
Anmodninger til databasen: den eneste mulighed for manøvrer.
Syntese — vi forbedrer ydeevnen af enkeltdele og forventer, at databasens ydeevne forbedres som resultat.
Lyrisk indledning eller hvorfor er dette nødvendigt
Hvordan foregår processen med at løse ydeevneproblemer, hvis databasens ydeevne ikke overvåges:
Kunden - 'vi har det dårligt, langsomt, gør det godt for os'
Ingeniøren - 'hvordan er det dårligt?'
Kunden – 'sådan er det nu (for en time siden, i går, ved sidste tilfælde), langsomt'
Ingeniøren – 'hvornår var det godt?'
Kunden – 'for en uge (to uger) siden fungerede det rimeligt.' (Det var heldigt)
Kunden – 'og jeg kan ikke huske, hvornår det var godt, men nu er det dårligt' (Almindeligt svar)
Resultatet bliver det klassiske billede:
Hvem er skyld i det, og hvad skal der gøres?
Det første spørgsmål er lettest at besvare — ingeniøren DBA har altid skylden.
Det andet spørgsmål er heller ikke for svært at besvare — vi skal implementere et system til overvågning af databasens ydeevne.
Det første spørgsmål opstår — hvad skal overvåges?
Vej 1. Vi vil overvåge ALT
CPU-belastning, antal læse-/skriveoperationer på disken, størrelse af tildelt hukommelse og en megaton forskellige tællere, som ethvert rimeligt fungerende overvågningssystem kan give.
Resultatet bliver en bunke grafer, opsummeringstabeller og uafbrudte meddelelser på mail samt 100% beskæftigelse af ingeniøren med at løse en masse ens sager, som regel med standardformuleringen — “Midlertidigt problem. Ingen handling kræves”. Men alle er optaget, og der er altid noget at vise kunden — arbejdet kører.
Vej 2. Monitorér kun det, der er nødvendigt, og det, der ikke er nødvendigt, skal ikke monitoreres.
Man kan monitorere, lidt anderledes — kun enheder og hændelser:
- Som ingeniøren DBA kan påvirke.
- For hvilke der findes en handlingsalgoritme ved opståen af hændelsen eller ændring af enhed.
Baseret på dette antagelse og i lyset af «Filosofisk indledning» for at undgå regelmæssig gentagelse af «Lyrisk indledning eller hvorfor er dette nødvendigt» vil det være hensigtsmæssigt at monitorere ydeevnen af individuelle forespørgsler, for at optimere og analysere, hvilket i sidste ende bør føre til en forbedring af hele databasens hastighed.
Men for at forbedre en tung forespørgsel, der påvirker den overordnede ydeevne af databasen, skal man først finde den.
Så der opstår to sammenkoblede spørgsmål:
- hvad betragtes som en tung forespørgsel
- hvordan man søger efter tunge forespørgsler.
Det er åbenlyst, at en tung forespørgsel er en forespørgsel, der bruger mange systemressourcer for at opnå et resultat.
Vi går videre til det andet spørgsmål — hvordan man søger efter og derefter monitorerer tunge forespørgsler?
Hvilke muligheder for monitorering af forespørgsler er der i PostgreSQL?
Sammenlignet med Oracle er mulighederne lidt begrænsede, men der er stadig noget, der kan gøres.
PG_STAT_STATEMENTS
Til at finde og monitorere tunge forespørgsler i PostgreSQL er der et standardudvidelse kaldet pg_stat_statements.
Efter installation af udvidelsen oprettes der en visning med samme navn i mål-databasen, som skal bruges til monitorering.
Målkolonnerne pg_stat_statements for at opbygge et monitoreringssystem:
- queryid Intern hash-kode beregnet ud fra syntaxtræet for operatoren
- max_time Maksimal tid, der er brugt på operatoren, i millisekunder
Ved at indsamle og bruge statistikken fra disse to kolonner kan man opbygge et monitoreringssystem.
Hvordan pg_stat_statements bruges til at monitorere ydeevnen i PostgreSQL
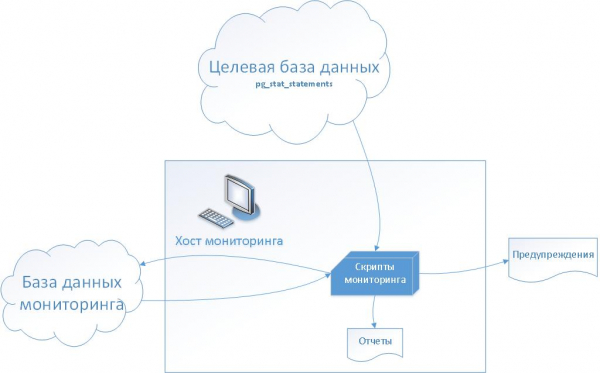
Til at monitorere ydeevnen af forespørgsler anvendes:
På siden af mål-databasen — visningen pg_stat_statements
Fra server og monitoreringsdatabasen — en række bash-scripts og service-tabeller.
Trin 1 - indsamling af statistikdata
På overvågningsværten kører et script regelmæssigt via cron, som kopierer indholdet af visningen pg_stat_statements fra den målrettede database til tabellen pg_stat_history i overvågningsdatabasen.
På denne måde dannes en historik over udførelsen af individuelle forespørgsler, som kan bruges til at generere præstationsrapporter og justere metrikker.
Trin 2 - opsætning af præstationsmetrikker
Baseret på de indsamlede data vælger vi de forespørgsler, hvis udførelse er mest kritisk/vigtig for kunden (applikationen). I samråd med kunden fastsætter vi værdierne for præstationsmetrikkerne ved hjælp af felterne queryid og max_time.
Resultat - start på præstationsovervågning
- Overvågningsscriptet kontrollerer ved opstart de konfigurerede præstationsmetrikker ved at sammenligne værdien af max_time metrikken med værdien fra visningen pg_stat_statements i den målrettede database.
- Hvis værdien i den målrettede database overstiger metrikværdien – dannes der en advarsel (en hændelse i ticket-systemet)
Yderligere mulighed 1
Historik over udførelsesplaner for forespørgsler
For senere at kunne løse præstationshændelser er det meget nyttigt at have en historik over ændringer i udførelsesplaner for forespørgsler.
Historikken gemmes i en service-tabel log_query. Tabellen udfyldes ved at analysere den indlæste PostgreSQL-logfil. Da logfilen, i modsætning til visningen pg_stat_statements, indeholder den fulde tekst med værdierne for parametre og ikke den normaliserede tekst, er der mulighed for at logge ikke kun tidspunkt og varighed af forespørgsler, men også opbevare udførelsesplaner på det nuværende tidspunkt.
Yderligere mulighed 2
Kontinuerlig forbedringsproces for ydeevne
Overvågning af individuelle forespørgsler er generelt ikke beregnet til at løse opgaven med kontinuerlig forbedring af ydelsen i databasen som helhed, da den kun kontrollerer og løser præstationsopgaver for individuelle forespørgsler. Dog kan metoden udvides og opsættes til at overvåge forespørgsler for alle databaser.
For dette skal der indføres yderligere præstationsmetrikker:
- De seneste dage
- For den grundlæggende periode
Scriptet vælger forespørgsler fra visningen pg_stat_statements i den målrettede database og sammenligner værdien af max_time med den gennemsnitlige værdi af max_time, i det første tilfælde over de seneste dage eller over den valgte tidsperiode (baseline), i det andet tilfælde.
Dermed vil en advarsel automatisk blive genereret i tilfælde af præstationsdegradering for en hvilken som helst forespørgsel, uden manuel analyse af rapporter.
Hvad har syntese at gøre med det?
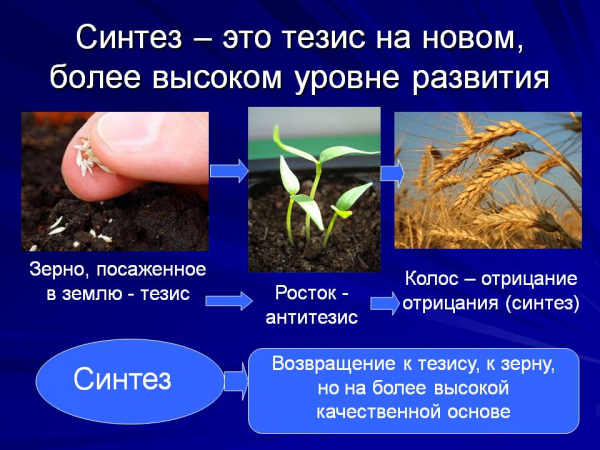
I den beskrevne tilgang, som syntesemetoden foreslår — ved at forbedre de enkelte dele af systemet, forbedrer vi systemet som helhed.
- Forespørgslen, der udføres af databasen – tese
- Den ændrede forespørgsel – antitese
- Ændringen af systemets tilstand — syntese
Systemudvikling
- Udvidelse af den indsamlede statistik ved tilføjelse af historik til det systemiske view pg_stat_activity
- Udvidelse af den indsamlede statistik ved tilføjelse af historik for de enkelte tabeller, der er involveret i forespørgslerne
- Integration med overvågningssystemet i AWS-cloud
- Og hvad mere kan man finde på...
Kilde: habr.com
