

Hvad kan få en så stor virksomhed som Lamoda med et veludviklet system og adskillige sammenkoblede tjenester til at ændre tilgang? Motivationerne kan være helt forskellige: fra lovgivningsmæssige til den iboende trang til at eksperimentere, som alle programmører har.
Men det betyder bestemt ikke, at man ikke kan forvente yderligere fordele. Hvad man konkret kan vinde ved at implementere events-driven API på Kafka, vil Sergey Zaika fortælle om (). Der vil også være omtale af de erfaringer og interessante opdagelser, som nødvendigvis følger med eksperimentet.
Disclaimer: Denne artikel er baseret på materialer fra et meetup, som Sergey afholdt i november 2018 på HighLoad++. Den praktiske erfaring fra Lamodas arbejde med Kafka tiltrak ikke mindre interesse fra deltagerne end de andre oplæg i programmet. Vi mener, det er et fremragende eksempel på, at man altid kan og bør finde ligesindede, og at arrangørerne af HighLoad++ vil fortsætte med at skabe en atmosfære, der muliggør dette.
Om processen
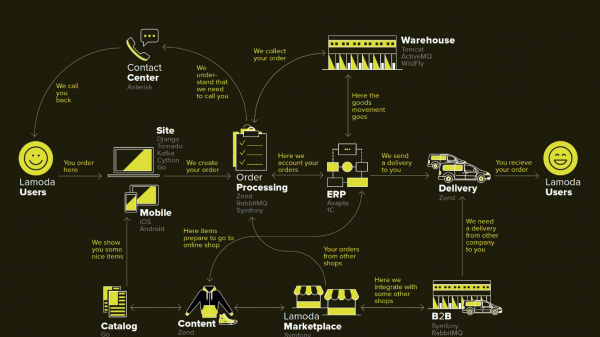
Lamoda er en stor e-handelsplatform, der har sit eget kontaktcenter, leveringsservice (og mange partnerleverandører), fotoservice, et enormt lager, og alt dette kører på sin egen software. Der er adskillige betalingsmetoder, og B2B-partnere kan benytte dele eller alle disse tjenester og ønsker at kende den aktuelle information om deres varer. Desuden opererer Lamoda i tre lande ud over Rusland, hvor tingene fungerer lidt anderledes. I alt findes der sandsynligvis over hundrede måder at konfigurere en ny ordre på, der skal behandles på en bestemt måde. Alt dette fungerer gennem adskillige tjenester, der nogle gange kommunikerer på en ikke-åbenlys måde. Der er også et centralt system, hvis hovedansvar er at holde styr på ordrestatusser. Vi kalder det BOB, og jeg arbejder med det.
Refund Tool med events-driven API
Ordet events-driven er ret udvandet, men vi vil senere definere, hvad det konkret indebærer. Jeg vil starte med konteksten, hvori vi besluttede at afprøve events-driven API-tilgangen i Kafka.
I enhver butik, udover de ordrer, som kunderne betaler for, opstår der situationer, hvor butikken skal tilbagebetale penge, fordi kunden ikke har kunne bruge produktet. Denne relativt korte proces involverer at bekræfte oplysningerne, hvis det er nødvendigt, og videreføre pengene.
Men returprocessen er blevet kompliceret på grund af ændringer i lovgivningen, og vi har været nødt til at implementere en separat mikrotjeneste til det.
Vores motivation:
- Lov FZ-54 — kort sagt kræver loven, at man rapporterer hver pengeoverførsel til skattemyndighederne, hvad enten det er retur eller indbetaling, inden for en ret kort SLA på nogle få minutter. Som e-handel udfører vi en del operationer. Teknisk set betyder det et nyt ansvar (og dermed en ny tjeneste) samt justeringer i alle involverede systemer.
- BOB split — et internt selskabsprojekt til at befri BOB fra et stort antal ikke-kerneopgaver og reducere dets kompleksitet.
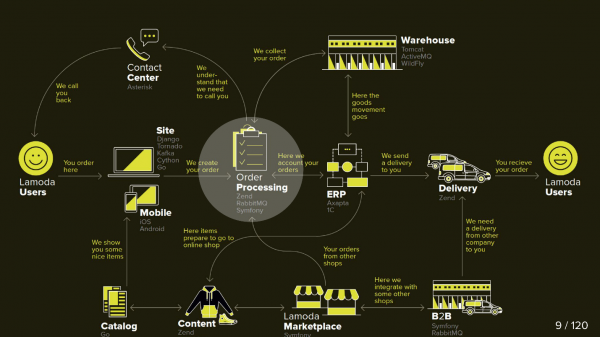
På dette diagram er de vigtigste systemer i Lamoda illustreret. I øjeblikket repræsenterer de fleste af dem nærmere et konstellation af 5-10 mikrotjenester omkring en faldende monolit.De vokser stille og roligt, men vi prøver at gøre dem mindre, fordi det er skræmmende at deployere et dedikeret midtpunkt – vi kan ikke tillade det at falde. Alle udvekslinger (pile) er vi tvunget til at reservere og antage, at enhver af dem kan blive utilgængelig.
I BOB er der også en del udvekslinger: betalingssystemer, levering, notifikationer osv.
Teknisk set er BOB:
- ~150k linjer kode + ~100k linjer tests;
- php7.2 + Zend 1 & Symfony Components 3;
- >100 API & ~50 udgående integrationer;
- 4 lande med deres egen forretningslogik.
At deployere BOB er dyrt og smertefuldt, antallet af kodelinjer og de opgaver, den løser, er sådan, at ingen kan beholde det i hovedet som helhed. Generelt er der mange grunde til at simplificere det.
Returprocessen
Oprindeligt involverer processen to systemer: BOB og Payment. Nu tilføjes der endnu to:
- Fiscalization Service, som vil tage sig af problemerne med fiscalization og kommunikationen med eksterne tjenester.
- Refund Tool, hvor nye udvekslinger simpelthen flyttes hen, så BOB ikke bliver overbelastet.
Nu ser processen således ud:
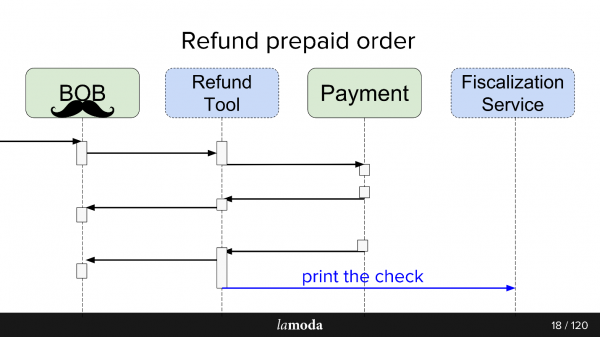
- BOB modtager en anmodning om pengene tilbage.
- BOB informerer Refund Tool om dette.
- Refund Tool siger til Payment: 'Returner pengene.'.
- Payment returnerer pengene.
- Refund Tool og BOB synkroniserer statusser, fordi de begge har behov for det i øjeblikket. Vi er ikke helt klar til at skifte fuldt til Refund Tool, da der er en UI i BOB, rapporter til regnskabsafdelingen og generelt mange data, der ikke så nemt kan overføres. Vi må sidde på to stole.
- En anmodning om fiscalization sendes.
I sidste ende har vi lavet en form for event-bus på Kafka, som alt er knyttet til. Hurra, nu har vi et enkelt fejlfunktionspunkt (sarcasme).
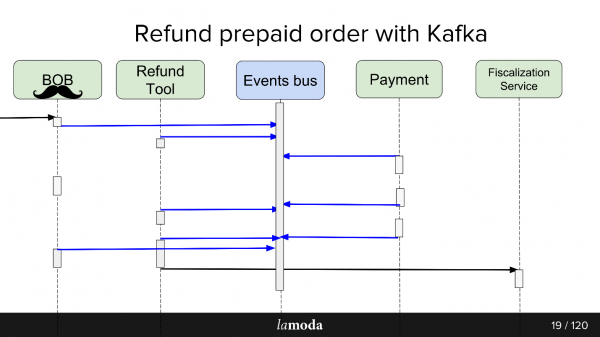
Fordele og ulemper er ret åbenlyse. Vi har lavet en bus, hvilket betyder, at alle tjenester nu er afhængige af den. Det forenkler designet, men introducerer et enkelt fejlfunktionspunkt i systemet. Hvis Kafka går ned, stopper processen.
Hvad er et events-drevet API
Et godt svar på dette spørgsmål findes i Martin Fowlers præsentation (GOTO 2017) .
Kort sagt, hvad vi har gjort:
- Vi har indkapslet al asynkron kommunikation gennem events storage. I stedet for at kommunikere over netværket til hver interesseret forbruger om statusændring, skriver vi en hændelse om statusændring i et centraliseret lager, og de interesserede forbrugere læser alt, der dukker op derfra.
- En hændelse (event) i dette tilfælde er en notifikation (notifications) om, at noget et sted er ændret. For eksempel, status for en ordre er ændret. En forbruger, som har brug for nogle ledsagende oplysninger om statusændringen, som ikke er i notifikationen, kan selv finde deres tilstand.
- Den maksimale løsning er fuld event sourcing, state transfer, hvor hændelsen indeholder al den information, der er nødvendig for behandling: hvorfra og til hvilken status det er gået, hvordan dataene er ændret osv. Spørgsmålet er kun om hensigtsmæssighed og mængden af information, som du kan tillade dig at opbevare.
I forbindelse med lanceringen af Refund Tool brugte vi den tredje mulighed. Det forenklede behandling af hændelser, da vi ikke behøvede at udvinde detaljerede oplysninger, og eliminerede scenariet, hvor hver ny hændelse medfører en bølge af opklarende get-anmodninger fra forbrugerne.
Tjenesten Refund Tool er ikke belastet, så Kafka der er mere en prøve end en nødvendighed. Jeg tror ikke, at hvis tilbagebetalingsservicen blev et high-load projekt, ville forretningen være glad.
Async exchange AS IS
Til asynkrone udvekslinger bruger PHP-afdelingen som regel RabbitMQ. Vi samlede data til anmodningen, lagde det i køen, og forbrugeren fra den samme tjeneste læste det og sendte det (eller ikke sendte det). For selve API'et bruger Lamoda aktivt Swagger. Vi designer API'et, beskriver det i Swagger, genererer klient- og serverkode. Vi bruger også en lidt udvidet version af JSON RPC 2.0.
Nogle steder bruges esb-busser, nogle lever på activeMQ, men generelt, RabbitMQ — standard.
Async exchange TO BE
Når vi designer en udveksling gennem events-bus, ses der en parallel. Vi beskriver på lignende måde den fremtidige datoudveksling gennem beskrivelser af event-strukturen. YAML-formatet og kodegenereringen måtte vi selv lave; generatoren efter specifikationen skaber DTO'er og lærer klienter og servere at arbejde med dem. Genereringen foregår på to sprog — golang og php. Det gør det muligt at holde bibliotekerne konsistente. Generatoren er skrevet i golang, hvorfor den fik navnet gogi.
Event sourcing på Kafka er en typisk ting. Der findes løsninger fra den primære enterprise-version af Kafka Confluent, og der er , en løsning fra vores "brødre" i domæneområdet Zalando. Vores motivation for at starte med vanilla Kafka er at holde løsningen gratis, indtil vi beslutter, om vi vil bruge det i stor skala, samt for at bevare rum til manøvrering og forbedringer: vi vil have støtte til vores JSON RPC 2.0, generatorer til to sprog, og vi ser på hvad mere der kan laves.
Ironisk nok, selv i så lykkelig en situation, hvor der er en nogenlunde tilsvarende virksomhed som Zalando, som har lavet en lignende løsning, kan vi ikke bruge den effektivt.
Arkitektonisk set er mønsteret ved opstart sådan: vi læser direkte fra Kafka, men skriver kun gennem events-bus. Til læsning fra Kafka er der meget færdigt: mæglere, belastningsfordelere, og det er mere eller mindre klar til horisontal skalerbarhed, noget vi ønskede at bevare. For skrivning ønskede vi at pakke det gennem én gateway, også kendt som Events-bus, og det er derfor.
Events-bus
Eller events-bussen. Det er blot en stateless HTTP-gateway, som tager flere vigtige roller:
- Validering af produktion — vi kontrollerer, at begivenhederne lever op til vores specifikation.
- Hovedsystem for begivenheder, det vil sige det er det primære og eneste system i virksomheden, som svarer på spørgsmålet om, hvilke events med hvilke strukturer der betragtes som valide. Validering inkluderer blot datatyper og enums for hård specifikation af indholdet.
- Hash-funktion til sharding — strukturen af meddelelsen i Kafka er key-value, og hash fra key beregner, hvor det skal placeres.
Hvorfor
Vi arbejder i en stor virksomhed med en veludviklet proces. Hvorfor ændre noget? Det er et eksperiment, og vi forventer at opnå nogle fordele.
1:n+1 udvekslinger (én til mange)
Det er meget nemt at tilslutte nye forbrugere til API'et med Kafka.
Lad os antage, at du har et katalog, som skal holdes ajour i flere systemer samtidig (og måske også i nogle nye). Tidligere opfandt vi et bundle, der implementerede et set-API, og vi informerede master-systemet om adressen på forbrugerne. Nu sender master-systemet opdateringer til et emne, og alle, der er interesseret, læser dem. Der er kommet et nyt system - vi har tilmeldt det emnet. Ja, stadig et bundle, men lidt enklere.
I tilfælde af refund-tool, som i bund og grund er et stykke BOB, er det praktisk for os at holde dem synkroniseret via Kafka. Betalingen erklærer, at pengene er blevet tilbageført: BOB, RT lærte om det, ændrede deres status, og Fiscalization Service fik besked og udskrev en kvittering.
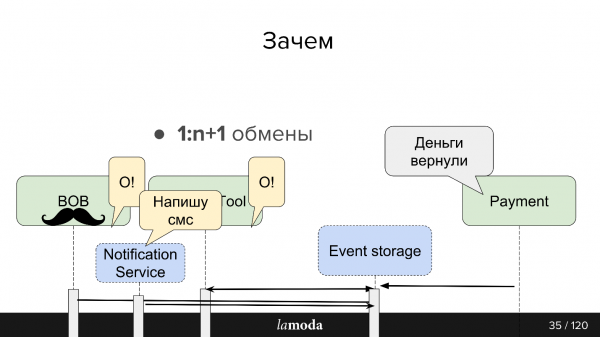
Vi har planer om at lave en samlet Notifications Service, der ville underrette kunden om nyheder vedrørende deres ordre/returneringer. I øjeblikket er dette ansvar fordelt mellem systemerne. Det vil være tilstrækkeligt at lære Notifications Service at fange relevant information fra Kafka og reagere på det (og deaktivere disse meddelelser i de andre systemer). Der kræves ingen nye direkte udvekslinger.
Data-drevet
Informationen mellem systemerne bliver gennemsigtig - uanset hvor "blodig enterprise" du har, og hvor omfattende din backlog måtte være. I Lamoda er der en afdeling for Data Analytics, som indsamler data fra systemerne og bringer dem i genanvendelig form, både for forretningen og for intelligente systemer. Kafka giver mulighed for hurtigt at give dem mange data og holde denne informationsstrøm aktuel.
Replication log
Beskeder forsvinder ikke efter læsning, som i RabbitMQ. Når et event indeholder tilstrækkelig information til behandling, får vi en historik over de seneste ændringer af objektet, og, hvis ønskes, muligheden for at anvende disse ændringer.
Opbevaringsperioden for replication log afhænger af intensiteten af skrivninger til dette emne, Kafka gør det muligt at konfigurere grænserne for opbevaringsperiode og datavolumen fleksibelt. For intensive emner er det vigtigt, at alle forbrugere har tid til at læse informationen, før den forsvinder, selv i tilfælde af kortvarige nedbrud. Det er normalt muligt at opbevare data i et antal dage, hvilket er helt tilstrækkeligt til support.
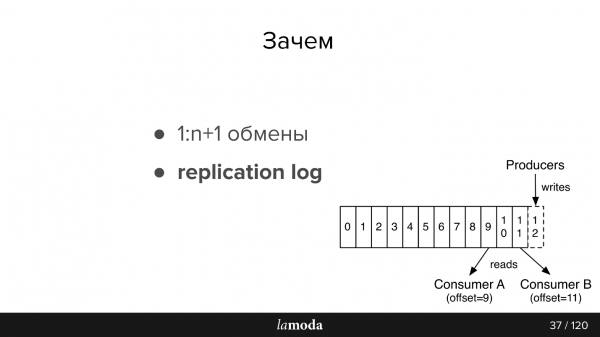
Næste er lidt om dokumentationen for dem, der ikke er bekendt med Kafka (billedet er også fra dokumentationen)
I AMQP er der køer: vi skriver beskeder i en kø til forbrugeren. Som regel behandles én kø af ét system med den samme forretningslogik. Hvis der er behov for at informere flere systemer, kan man lære applikationen at skrive til flere køer eller konfigurere en exchange med en fanout-mekanisme, som selv kloner dem.
I Kafka er der en lignende abstraktion emne, hvor du skriver beskeder, men de forsvinder ikke efter at være blevet læst. Som standard, når du forbinder til Kafka, modtager du alle beskeder, og der er samtidig mulighed for at huske det sted, hvor du stoppede. Det vil sige, at du læser rækkefølge, kan vælge ikke at markere en besked som læst, men gemme id'et, så du senere kan fortsætte læsningen. Id'et, hvor du stoppede, kaldes offset, og mekanismen er commit offset.
Derfor kan man implementere forskellig logik. For eksempel eksisterer vi BOB i 4 instanser for forskellige lande – Lamoda findes i Rusland, Kasakhstan, Ukraine og Hviderusland. Da de deployeres separat, har de lidt forskellige konfigurationer og deres egen forretningslogik. Vi angiver i beskeden, hvilket land den tilhører. Hver BOB-forbruger i hvert land læser med forskellige groupId'er, og hvis beskeden ikke vedrører dem, springer de den over, d.v.s. de committer straks offset +1. Hvis den samme emne læses af vores Payment Service, gør den det med en separat gruppe, og derfor krydser offset ikke hinanden.
Krav til begivenheder:
- Datakomplethed. Det ville være ønskeligt, at begivenheden havde tilstrækkelige data til, at den kunne blive behandlet.
- Integritet. Vi delegerer Events-bus til at kontrollere, at begivenheden er konsistent, og den kan behandle den.
- Rækkefølge er vigtigt. I tilfælde af returnering er vi nødt til at arbejde med historikken. Med notifikationer er rækkefølgen ikke vigtig, hvis det er homogene notifikationer, vil e-mailen være den samme uanset hvilken ordre der kom først. I tilfælde af returnering er der en klar proces, og hvis rækkefølgen ændres, opstår der undtagelser, refunderingen vil ikke blive oprettet eller behandlet – vi vil ende i en anden status.
- Konsistens. Vi har et lager, og nu laver vi begivenheder i stedet for en API. Vi har brug for en måde at hurtigt og billigt sende oplysninger om nye begivenheder og ændringer i eksisterende til vores tjenester. Dette opnås gennem en fælles specifikation i et separat git-repositorium og kodegenerators. Så derfor er vores klienter og servere i forskellige tjenester koordineret.
Kafka i Lamoda
Vi har tre installationer af Kafka:
- Logs;
- F&U;
- Events-bus.
I dag taler vi kun om det sidste punkt. I events-bussen har vi ikke så store installationer - 3 broker (servere) og kun 27 emner. Som regel er et emne en proces. Men det er et subtilt punkt, og det skal vi også berøre.
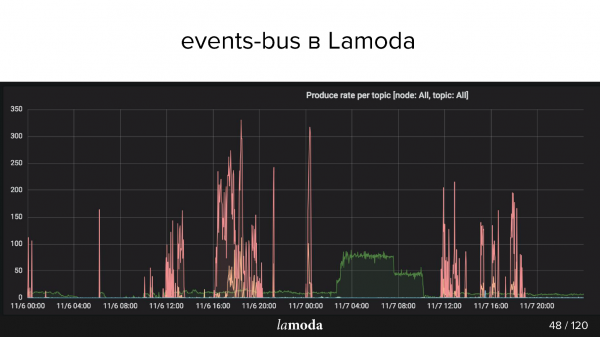
Øverst et diagram over rps. Refunds-processen er markeret med en turkis linje (ja, ja, den, der ligger på X-aksen), og den lyserøde markerer indholdsopdateringsprocessen.
Kataloget Lamoda indeholder millioner af varer, og dataene opdateres konstant. Nogle kollektioner går af mode, og nye udgives som erstatning, der kommer hele tiden nye modeller til kataloget. Vi forsøger at forudsige, hvad der vil interessere vores kunder i morgen, derfor køber vi konstant nye ting, tager billeder af dem og opdaterer udstillingen.
De lyserøde toppe er produktopdateringer, det vil sige ændringer ved varerne. Det er tydeligt, at drengene har taget billeder, taget billeder, og så pludselig! - de uploadede en bunke begivenheder.
Lamoda Events brugssager
Den opbyggede arkitektur bruger vi til sådanne operationer:
- Sporing af returneringsstatusser: call-to-action og tracking af statusser fra alle involverede systemer. Betaling, statusser, skattemæssig registrering, notifikationer. Her har vi prøvet en metode, lavet værktøjer, samlet alle fejl, skrevet dokumentation og fortalt kollegerne, hvordan man bruger det.
- Opdatering af produktkort: konfiguration, metadata, specifikationer. Én system læser (den, der viser), og flere skriver.
- Email, push og sms: ordren er samlet, ordren er ankommet, returneringen er accepteret osv., der er mange af dem.
- Lager, opdatering af lageret — kvantitativ opdatering af navne, bare tal: modtagelse på lageret, returnering. Det er nødvendigt, at alle systemer, der er relateret til reservation af varer, opererer med de mest aktuelle data. Lige nu er lageropdateringssystemet ret komplekst, Kafka vil gøre det muligt at forenkle det.
- Dataanalyse (R&D-afdeling), ML-værktøjer, analyse, statistik. Vi ønsker, at oplysningerne skal være gennemsigtige - til dette formål er Kafka velegnet.
Nu til den mere interessante del om de bumps, vi har mødt, og de spændende opdagelser, der er sket over de sidste seks måneder.
Designproblemer
Lad os sige, at vi vil lave en ny ting - for eksempel overføre hele leveringsprocessen til Kafka. Lige nu er en del af processen implementeret i Order Processing i BOB. Bag ordenes overførsel til leveringsservicen, bevægelsen til et midlertidigt lager og andet står der en statusmodel. Der er en hel monolith, faktisk to, plus en masse API'er, der er dedikeret til levering. De ved meget mere om leveringen.
Det ser ud til at være beslægtede områder, men for Order Processing i BOB og for leveringssystemet er statuserne forskellige. For eksempel sender nogle kurertjenester ikke interim-statusser, men kun de endelige: "leveret" eller "mistet". Andre oplyser derimod meget detaljeret om bevægelsen af varer. Alle har deres egne valideringsregler: for nogen er en e-mail gyldig, så den bliver behandlet; for andre er den ikke gyldig, men ordren vil stadig blive behandlet, fordi der er et telefonnummer til kontakt, og nogen vil sige, at en sådan ordre ikke vil blive behandlet overhovedet.
Datastream
I tilfælde af Kafka opstår spørgsmålet om organisering af datastreamen. Denne opgave er relateret til valget af strategi på flere punkter, lad os kigge på dem alle.
I én topic eller i forskellige?
Vi har en begivenhedsspecifikation. I BOB skriver vi, at en bestemt ordre skal leveres, og vi angiver: ordrenummer, dens indhold, nogle SKU'er og stregkoder osv. Når varerne ankommer til lageret, vil leveringen kunne få statusser, tidsstempler og alt, hvad der er nødvendigt. Men derefter ønsker vi at få opdateringer om disse data i BOB. Der opstår en omvendt proces for at hente data fra levering. Er det den samme hændelse? Eller er det en separat udveksling, der fortjener en separat topic?
Det er sandsynligvis, at de vil være meget ens, og fristelsen til at lave én topic er ikke ubegrundet, fordi en separat topic betyder separate forbrugere, separate konfigurationer, en separate generation af alt dette. Men det er ikke sikkert.
Nyt felt eller ny hændelse?
Men hvis vi bruger de samme begivenheder, opstår der et andet problem. For eksempel kan ikke alle leveringssystemer generere et sådant DTO, som BOB kan generere. Vi sender dem id, og de gemmer dem ikke, fordi de ikke har brug for dem, og set fra event-bus'ens startperspektiv er dette felt påkrævet.
Hvis vi indfører en regel for event-bus, hvor dette felt er påkrævet, er vi nødt til at indføre yderligere valideringsregler i BOB eller i behandlingen af startbegivenheden. Valideringen begynder at sprede sig i tjenesten - hvilket ikke er særlig praktisk.
Et andet problem er fristelsen til inkrementel udvikling. Vi får at vide, at vi skal tilføje noget til begivenheden, og, måske, hvis man tænker godt over det, burde det have været en separat begivenhed. Men i vores skema er en separat begivenhed et separat emne. Et separat emne er hele den proces, som jeg har beskrevet ovenfor. Udvikleren bliver fristet til bare at tilføje endnu et felt til JSON-skemaet og regenerere.
I tilfælde af refunds nåede vi på seks måneder til begivenheden for begivenheder. Vi havde én meta-begivenhed, der hedder refund update, som havde et felt type, der beskrev, hvad selve denne opdatering gik ud på. Derfra havde vi "fantastiske" switches med validere, der sagde, hvordan man skulle validere denne begivenhed med denne type.
Versionering af begivenheder
Til validering af beskeder i Kafka kan man bruge , men det var nødvendigt at planlægge dette fra starten og bruge Confluent. I vores tilfælde med versionering er vi nødt til at være forsigtige. Det vil ikke altid være muligt at læse beskeder fra replikationsloggen, fordi modellen "er kørt væk". Hovedsageligt ender vi med at bygge versioner, så modellen er bagudkompatibel: for eksempel ved at gøre feltet midlertidigt ikke-obligatorisk. Hvis forskellene er for store, begynder vi at skrive til et nyt emne, og vi flytter kunderne, når de er færdige med at læse det gamle.
Garanteret læseorden for partitioner
Emnerne inden for Kafka er opdelt i partitioner. Det er ikke så vigtigt, mens vi designer entiteter og udvekslinger, men vigtigt, når vi beslutter, hvordan vi skal forbruge det og skalere.
I de fleste tilfælde skriver du til Kafka et enkelt emne. Som standard bruges en partition, og alle meddelelser til dette emne havner i den. En consumer læser således sekventielt disse meddelelser. Antag nu, at systemet skal udvides, så meddelelserne kan læses af to forskellige consumere. Hvis du for eksempel sender en SMS, kan du få Kafka til at oprette en ekstra partition, og Kafka begynder at fordele meddelelserne på to dele - halvdelen der, halvdelen her.
Hvordan deler Kafka dem? Hver meddelelse har et indhold (hvor vi gemmer JSON) og en nøgle. Til denne nøgle kan der anvendes en hash-funktion, der bestemmer, hvilken partition meddelelsen havner i.
I vores tilfælde med refunds er dette vigtigt; hvis vi bruger to partitioner, er der en chance for, at en parallel consumer behandler den anden begivenhed før den første, hvilket kan skabe problemer. Hash-funktionen garanterer, at meddelelser med den samme nøgle havner i den samme partition.
Begivenheder vs kommandoer
Dette er endnu et problem, vi stødte på. En begivenhed er en form for hændelse: vi siger, at noget er sket (something_happened), for eksempel at en vare er blevet annulleret eller en refund er sket. Hvis nogen lytter til disse begivenheder, vil en refund-entitet blive oprettet ved 'varen blev annulleret', mens 'en refund skete' registreres et sted i opsætningen.
Men normalt, når du designer begivenheder, vil du ikke skrive dem for ingenting - du regner med, at nogen vil læse dem. Der er en stor fristelse til at skrive ikke something_happened (item_canceled, refund_refunded), men something_should_be_done. For eksempel, varen er klar til returnering.
På den ene side antyder det, hvordan begivenheden vil blive brugt. På den anden side ligner det langt mindre et normalt navn til en begivenhed. Desuden er det ikke langt herfra til kommandon do_something. Men du har ingen garanti for, at nogen har læst denne begivenhed; og hvis den er blevet læst, er der ingen garanti for, at det er sket med succes; og hvis det er sket med succes, har det gjort noget, og det noget er kommet igennem med succes. I det øjeblik, hvor en begivenhed bliver do_something, bliver der behov for feedback, og det er et problem.
I asynkron udveksling i RabbitMQ, når du har læst en meddelelse, har du været inde og tjekke via http, og du får en respons - i det mindste at meddelelsen blev modtaget. Når du har skrevet i Kafka, er der en meddelelse om, at du har skrevet i Kafka, men hvad der skete med det, ved du ikke noget om.
Derfor måtte vi i vores tilfælde indføre en responsbegivenhed og indstille overvågning på, at hvis der opstod et vist antal hændelser inden for en given tid, så skulle der komme et tilsvarende antal responsbegivenheder. Hvis dette ikke skete, ser det ud til, at noget gik galt. For eksempel, hvis vi har sendt hændelsen "item_ready_to_refund", forventer vi, at refund vil blive oprettet, pengene vil blive tilbageført til kunden, og vi får hændelsen "money_refunded". Men det er ikke sikkert, derfor er overvågning nødvendig.
Nuancer
Der er et ret åbenlyst problem: hvis du læser fra emnet sekventielt, og du har en dårlig besked, falder forbrugeren, og så kan du ikke komme videre. Du skal stoppe alle forbrugere, committe offset'en fremad for at fortsætte med at læse.
Vi vidste om dette, vi havde taget højde for det, og det skete alligevel. Og dette skete, fordi hændelsen var gyldig i forhold til events-bus, hændelsen var gyldig i forhold til applikationsvalidereren, men den var ikke gyldig i forhold til PostgreSQL, fordi vi i et system havde MySQL med UNSIGNED INT, mens det nyskrivne system havde PostgreSQL bare med INT. Dens størrelse er lidt mindre, og Id kunne ikke være plads. Symfony døde med en undtagelse. Vi fangede selvfølgelig undtagelsen, fordi vi havde taget højde for den, og vi havde planlagt at committe denne offset, men før det ville vi gerne inkrementere problemmeteret, da beskeden blev behandlet med fejl. Tællerne i dette projekt ligger også i databasen, men Symfony havde allerede afsluttet kommunikationen med databasen, og den anden undtagelse dræbte hele processen uden chancer for at committe offset.
I et stykke tid lå servicen stille — heldigvis er det ikke så alvorligt med Kafka, fordi beskederne forbliver. Når arbejdet genoptages, kan de læses igen. Det er praktisk.
Kafka har muligheden gennem tooling at sætte et vilkårligt offset. Men for at gøre dette skal alle forbrugere stoppes — i vores tilfælde forberede en separat udgivelse, hvor der ikke vil være forbrugere, redeployments. Så kan offset'en justeres i Kafka gennem tooling, og beskeden vil gå igennem.
En anden nuance — replication log vs rdkafka.so — relateret til vores projekts specifikationer. Vi bruger PHP, og i PHP kommunikerer alle biblioteker typisk med Kafka gennem rdkafka.so-repositoriet, og derefter er der en form for indpakning. Måske er det vores personlige udfordringer, men det viste sig, at det ikke er så let at genlæse en sektion, der allerede er læst. Generelt havde vi softwareproblemer.
Når man ser på særegenhederne ved arbejdet med partitions, står der direkte i dokumentationen consumers >= topic partitions. Men jeg fandt først ud af dette meget senere, end jeg gerne ville. Hvis du ønsker at skalere og have to forbrugere, skal du have mindst to partitions. Det vil sige, hvis du havde én partition, hvor der var samlet 20.000 beskeder, og du lavede en ny, vil antallet af beskeder ikke blive udlignet med det samme. Derfor, for at have to parallelle forbrugere, skal du arbejde med partitions.
Overvågning
Jeg tænker, baseret på hvordan vi overvåger, vil det blive endnu klarere, hvilke problemer der findes med den nuværende tilgang.
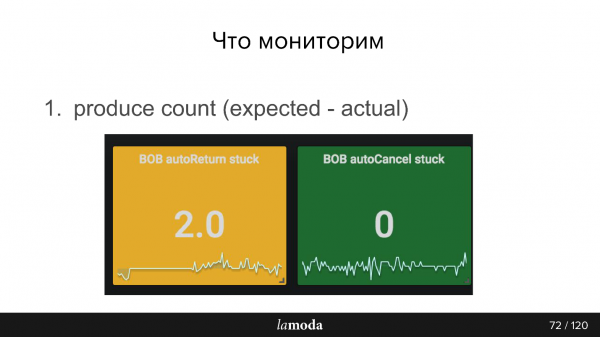
For eksempel tæller vi, hvor mange varer der for nylig har ændret status i databasen, og i overensstemmelse med disse ændringer burde der være sket begivenheder, og vi sender dette antal til vores overvågningssystem. Derefter får vi et andet tal fra Kafka, hvor mange begivenheder der faktisk blev registreret. Det er tydeligt, at forskellen mellem disse to tal altid skal være nul.
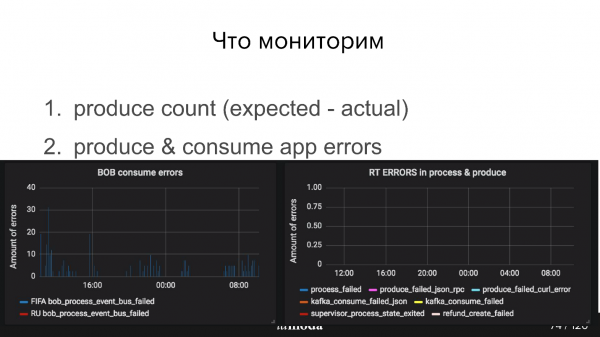
Derudover skal vi overvåge, hvordan det går med producenten, om events-bus har modtaget beskeder, og hvordan det går med forbrugeren. For eksempel ser det godt ud for Refund Tool, men BOB har tydeligvis nogle problemer (de blå toppe).
Jeg har allerede nævnt consumer-group lag. Groft sagt er det antallet af ulæste beskeder. Generelt fungerer vores forbrugere hurtigt, derfor er laget normalt 0, men der kan undertiden være en kortvarig spids. Kafka kan håndtere dette ud af boksen, men der skal angives et interval.
Der er et projekt , som giver dig mere information om Kafka. Det returnerer blot status via API for consumer-group og viser, hvordan det går med denne gruppe. Derudover er der OK og Failed, men også warning, så du kan finde ud af, at dine forbrugere ikke kan følge med tempoet for produktionen — de får ikke læst det, der skrives. Systemet er ret smart og nemt at bruge.
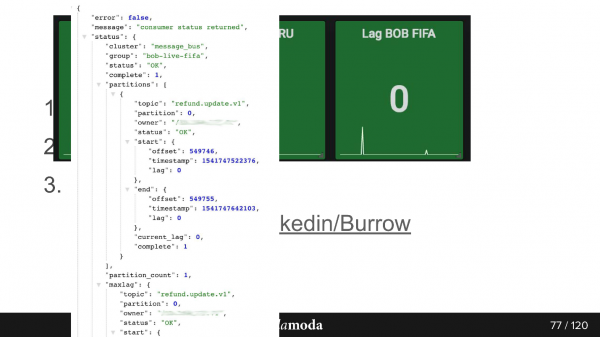
Sådan ser svaret fra API ud. Her er gruppen bob-live-fifa, partition refund.update.v1, status OK, lag 0 — den seneste endelige offset er sådan.
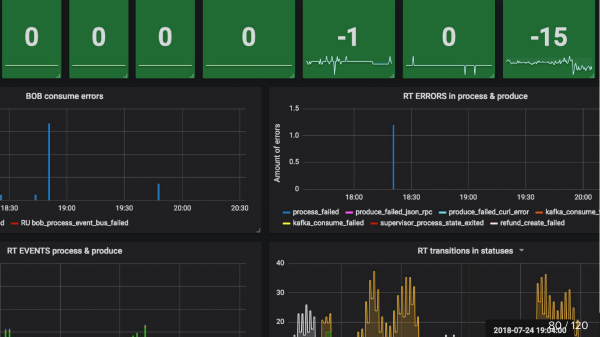
Overvågning updated_at SLA (stuck) Jeg har allerede nævnt det. For eksempel er varen gået ind i status, at den er klar til returnering. Vi sætter en Cron, der siger, at hvis denne genstand ikke er gået til refund inden for 5 minutter (vi refunderer pengene gennem betalingssystemerne meget hurtigt), så er der helt sikkert noget, der er gået galt, og det er definitivt en sag for supporten. Derfor tager vi bare Cron, som læser disse ting, og hvis de er over 0, sender den en alert.
For at opsummere er det praktisk at bruge hændelser, når:
- informationen er nødvendig for flere systemer;
- resultatet af behandlingen ikke er vigtigt;
- der er få hændelser, eller hændelserne er små.
Det kan synes, at artiklen har et ret konkret emne - asynkron API på Kafka, men i den forbindelse vil jeg straks anbefale mange ting.
For det første er den næste vi skal ikke vente til november, allerede i april vil der være en version i Sankt Petersborg, og i juni vil vi tale om høje belastninger i Novosibirsk.
For det andet indgår taleren Sergey Zayka i det programkomité for vores nye konference om vidensstyring . Konferencen er en-dags, finder sted den 26. april, men programmet er meget fyldt.
Og også i maj vil der være og (med DevOpsConf inkluderet) - der kan du stadig foreslå dit emne, dele din erfaring og klage over dine opnåede skader.
Kilde: habr.com
