

KDB+, produkt fra virksomheden — er en velkendt, ekstremt hurtig kolonne-database, der er designet til at opbevare tidsseriedata og udføre analytiske beregninger på dem. Oprindeligt blev den (og er stadig) meget populær i finansbranchen — den anvendes af alle top 10 investeringsbanker og mange kendte hedgefonde, børser og andre organisationer. For nylig har KX besluttet at udvide sin kundebase og tilbyder nu løsninger inden for andre områder, hvor der behandles store mængder data, der er tids- eller på anden måde organiseret — telekommunikation, bioinformatik, produktion osv. De er også blevet partner med Aston Martin Red Bull Racing-teamet i Formel 1, hvor de hjælper med at indsamle og behandle data fra bilens sensorer og analysere tests i vindtunnelen. I denne artikel vil jeg fortælle om de egenskaber, der gør KDB+ yderst effektiv, hvorfor virksomheder er villige til at bruge store summer på den, og endelig, hvorfor det faktisk ikke er en database.
I denne artikel vil jeg forsøge at forklare, hvad KDB+ generelt er, hvilke muligheder og begrænsninger den har, og hvilken nytte den kan have for virksomheder, der ønsker at bearbejde store datamængder. Jeg vil ikke gå i detaljer med implementeringen af KDB+ og dens programmeringssprog Q. Begge emner er meget omfattende og fortjener separate artikler. Meget information om disse emner kan findes på hjemmesiden code.kx.com, herunder en bog om Q — Q For Mortals (se linket nedenfor).
Nogle termer
- In-memory database. En database, der opbevarer data i RAM for at fremskynde adgangen. Fordelene ved en sådan database er åbenlyse, mens ulemperne omfatter risikoen for datatab og behovet for meget hukommelse på serveren.
- Kolonne-database. En database, hvor data opbevares kolonnevis snarere end post for post. Den primære fordel ved en sådan database er, at data fra én kolonne lagres sammen på disken og i hukommelsen, hvilket betydeligt fremskynder adgangen til dem. Det er ikke nødvendigt at indlæse kolonner, der ikke anvendes i forespørgslen. Den primære ulempe er, at det er svært at modificere og slette poster.
- Tidsrække. Data med en dato- eller tidskolonne. Generelt er rækkefølgen af disse data vigtig for nemt at kunne bestemme, hvilken post der kommer før eller efter den aktuelle, eller for at anvende funktioner, hvis resultater afhænger af rækkefølgen af poster. Klassiske databaser er bygget på et helt andet princip — at præsentere mængden af poster som en samling, hvor rækkefølgen af poster ikke er defineret.
- Vektor. I konteksten af KDB+ — er det en liste af elementer af én atomtype, for eksempel tal. Med andre ord, et array af elementer. Arrays kan opbevares kompakt og behandles ved hjælp af vektoriske processor-instruktioner, i modsætning til lister.
Historisk baggrund
KX blev grundlagt i 1993 af Arthur Whitney, der tidligere arbejdede hos Morgan Stanley med sproget A+, en efterfølger til APL — et meget originalt og engang populært sprog i finansverdenen. I KX fortsatte Arthur i samme ånd og skabte det vektor-funktionelle sprog K, inspireret af radikal minimalisme. Programmer skrevet i K ser ud som en kaotisk samling af tegnsætning og specialtegn, hvor betydningen af tegn og funktioner afhænger af konteksten, og hver operation bærer en meget dybere mening end hvordan det er i traditionelle programmeringssprog. Dette gør, at programmer i K fylder minimal plads — få linjer kan erstatte sider med tekst fra et omstændigt sprog som Java — og det er en superkompakt realisering af algoritmen.
En funktion på K, der implementerer størstedelen af LL1-parser generatoren baseret på den givne grammatik:
1. pp:{q:{(x;p3(),y)};r:$[-11=@x;$x;11=@x;q[`N;$*x];10=abs@@x;q[`N;x]
2.   ($)~*x;(`P;p3 x 1);(1=#x)&11=@*x;pp[{(1#x;$[2=#x;;,:]1_x)}@*x]
3.      (?)~*x;(`Q;pp[x 1]);(*)~*x;(`M;pp[x 1]);(+)~*x;(`MP;pp[x 1]);(!)~*x;(`Y;p3 x 1)
4.      (2=#x)&(@x 1)in 100 101 107 7 -7h;($[(@x 1)in 100 101 107h;`Ff;`Fi];p3 x 1;pp[*x])
5.      (|)~*x;`S,(pp'1_x);2=#x;`C,{@[@[x;-1+#x;{x,")"}];0;"(",]}({$[".s.C"~4#x;6_-2_x;x]}'pp'x);'`pp];
6.   $[@r;r;($[1<#r;".s.";""],$*r),$[1<#r;"[",(";"\/1_r),"]";""]]}
Denne filosofi om ekstrem effektivitet med minimal bevægelse har Arthur også realiseret i KDB+, der blev lanceret i 2003 (jeg tænker, det nu er klart, hvor K i navnet kommer fra), og som ikke er andet end en fortolker af den fjerde version af K-sproget. Oven på K er der tilføjet en mere brugervenlig version af K kaldet Q. I Q er der også tilføjet støtte til en specifik SQL-dialekt — QSQL, samt i fortolkeren — support for tabeller som en systemtype data, værktøjer til arbejde med tabeller i hukommelsen og på disk, osv.
Således er KDB+ set fra en brugers synspunkt blot en fortolker af Q-sproget med understøttelse af tabeller og SQL-lignende udtryk i LINQ-stil fra C#. Dette er KDB+'s vigtigste skelnen fra andre databaser og dens primære konkurrencefordel, som ofte overses. Det er ikke en database + et hjælpesprog, der er begrænset, men et fuldt funktionelt og kraftfuldt programmeringssprog + indbygget support til databasefunktioner. Denne forskel vil spille en afgørende rolle, når man oplister alle fordelene ved KDB+. For eksempel…
Størrelse
Efter nutidens standarder har KDB+ simpelthen en mikroskopisk størrelse. Det er bogstaveligt talt én udførbar fil der er mindre end en megabyte og én lille tekstfil med nogle systemfunktioner. I realiteten er det mindre end én megabyte, og for dette program betaler virksomheder titusinder af dollars om året for én processor på en server.
- En sådan størrelse gør, at KDB+ kan fungere perfekt på hvilket som helst hardware — fra mikrocomputeren Pi til servere med terabyte af hukommelse. Dette påvirker ikke funktionaliteten, tværtimod starter Q øjeblikkeligt, hvilket gør det muligt at bruge det som et scriptsprog.
- Med denne størrelse kan Q-fortolkeren være helt i processorens cache, hvilket fremskynder programudførelsen.
- Med så lille en størrelse på den udførbare fil optager Q-processen utrolig lidt plads i hukommelsen, og man kan køre dem i hundredvis. Samtidig kan Q, når det er nødvendigt, også håndtere titusinder til hundreder af gigabyte hukommelse inden for et enkelt proces.
Universelt
Q er perfekt til en bred vifte af opgaver. Q-processen kan fungere som en historisk database og give hurtig adgang til terabyte af information. For eksempel har vi dusinvis af historiske databaser, hvor en enkelt usammensat dag med data fylder over 100 gigabyte. Ikke desto mindre, med rimelige begrænsninger, vil en forespørgsel til databasen blive udført på tiere til hundredevis af millisekunder. Generelt har vi en universel timeout for brugerforespørgsler — 30 sekunder — og den aktiveres meget sjældent.
Med samme lethed kan Q fungere som en in-memory database. Tilsætning af nye data til tabellerne i hukommelsen sker så hurtigt, at den begrænsende faktor er brugerforespørgslerne. Data i tabellerne opbevares kolonnevis, hvilket betyder, at enhver operation på en kolonne vil udnytte CPU-cache fuldt ud. Derudover har KX stræbt efter at implementere alle grundlæggende operationer, såsom aritmetiske via vektorinstruktioner fra processoren, hvilket maksimerer deres hastighed. Q kan også udføre opgaver, der ikke er typiske for databaser — for eksempel behandle streamingdata og beregne i 'real tid' (med forsinkelse fra tiere millisekunder til flere sekunder afhængigt af opgaven) forskellige aggregerende funktioner for finansielle instrumenter over forskellige tidsintervaller eller opbygge en model for indflydelsen af en gennemført handel på markedet og profilere den næsten med det samme efter den er gennemført. I sådanne opgaver er det oftest ikke Q, der forårsager den største tidsforsinkelse, men nødvendigheden af at synkronisere data fra forskellige kilder. Den høje hastighed opnås ved, at dataene og funktionerne, der behandler dem, er i én proces, og behandlingen reduceres til at udføre flere QSQL-udtryk og joins, som ikke fortolkes, men udføres i binær kode.
Endelig kan man også skrive alle typer serviceprocesser på Q. For eksempel Gateway-processer, der automatisk fordeler brugerforespørgsler til de relevante databaser og servere. Programmøren har fuld frihed til at implementere enhver algoritme til belastningsfordeling, prioritering, fejltolerance, adgangsrettigheder, kvoter og hvad som helst andet, der er ønskeligt. Hovedproblemet her er, at man selv skal implementere alt dette.
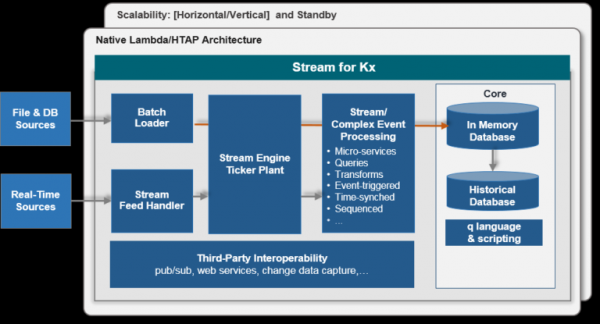
Som eksempel vil jeg nævne, hvilke typer processer vi har. Alle disse anvendes aktivt og arbejder sammen, og de sammenkobler dusinvis af forskellige databaser, behandler data fra mange kilder og serverer hundrede af brugere og applikationer.
- Forbindere (feedhandler) til datakilder. Disse processer bruger typisk eksterne biblioteker, der indlæses i Q. C-interface i Q er særligt enkelt og tillader nemt at oprette proxy-funktioner til ethvert C/C++ bibliotek. Q er hurtigt nok til at håndtere for eksempel behandling af en strøm af FIX-beskeder fra alle europæiske aktiemarkeder samtidigt.
- Datadistributører (tickerplant), der fungerer som et mellemled mellem forbindere og forbrugere. Samtidig skriver de de indgående data til et særligt binært log, hvilket sikrer stabilitet for forbrugerne i tilfælde af forbindelsestab eller genstart.
- In-memory databaser (rdb). Disse databaser giver den hurtigst mulige adgang til friske rå data ved at gemme dem i hukommelsen. Som regel akkumulerer de data i tabeller i løbet af dagen og nulstiller dem om natten.
- Persist databaser (pdb). Disse databaser sikrer bevarelsen af dagens data i en historisk database. Typisk, i modsætning til rdb, gemmer de ikke data i hukommelsen, men bruger en særlig cache på disken i løbet af dagen og kopierer data til den historiske database ved midnat.
- Historiske databaser (hdb). Disse databaser giver adgang til data fra tidligere dage, måneder og år. Deres størrelse (i dage) er kun begrænset af harddiskens kapacitet. Data kan være placeret hvor som helst, især på forskellige drev for at fremskynde adgangen. Der er mulighed for at komprimere data ved at bruge flere algoritmer efter valg. Database-strukturen er godt dokumenteret og enkel, data opbevares kolonnevis i almindelige filer, så de også kan behandles med operativsystemets værktøjer.
- Databaser med aggregeret information. Gemmer forskellige aggregationer, typisk grupperet efter navnet på instrumentet og tidsintervallet. In-memory databaser opdaterer deres tilstand ved hver indkommende besked, mens historiske databaser gemmer forudberegnede data for at fremskynde adgangen til historiske data.
- Endelig, gateway processer, der betjener applikationer og brugere. Q giver mulighed for fuldstændig asynkron behandling af indkommende beskeder, fordeling af dem til databaser, adgangsret-check og så videre. Jeg bemærker, at beskederne ikke er begrænsede og ofte ikke er SQL-udtryk, som det er tilfældet i andre databaser. Oftest er SQL-udtrykket skjult i en særlig funktion og konstrueres baseret på de parametre, brugeren anmoder om — tid konverteres, filtrering finder sted, data normaliseres (for eksempel justeres aktiekurser, hvis der er blevet udbetalt udbytte) osv.
Typisk arkitektur for én datatype:
Hastighed
Selvom Q er et tolket sprog, er det samtidig et vektorspråk. Det betyder, at mange indbyggede funktioner, især aritmetiske, accepterer argumenter i enhver form — tal, vektorer, matricer, lister, og programmøren forventes at implementere programmet som operationer på arrays. I et sådant sprog, hvis du lægger to vektorer med en million elementer sammen, spiller det allerede ingen rolle, at sproget er tolket, additionen udføres af en superoptimeret binær funktion. Da langt størstedelen af tiden i Q-programmer går til tabeller, der bruger disse grundlæggende vektorisede funktioner, opnås der en ganske anstændig hastighed, der muliggør behandling af enorme datamængder selv i én proces. Det minder om matematiske biblioteker i Python — selvom selve Python-sproget ikke er særligt hurtigt, er der mange fremragende biblioteker som numpy, der gør det muligt at behandle numeriske data med hastigheden af et kompilert sprog (forresten, numpy er ideologisk nært beslægtet med Q).
Derudover har KX lagt stor vægt på designet af tabeller og optimering af arbejdet med dem. For det første understøttes flere typer indekser, som støttes af indbyggede funktioner og kan anvendes ikke kun på tabelkolonner, men også på enhver vektor — gruppering, sortering, unikhedsattribut og særlig gruppering for historiske databaser. Indekset anvendes enkelt og justeres automatisk, når der tilføjes elementer til kolonnen/vektoren. Indekser kan med succes anvendes på tabelkolonner både i hukommelsen og på disken. Ved udførelse af en QSQL-forespørgsel anvendes indekser automatisk, når det er muligt. For det andet er arbejdet med historiske data udført gennem mekanismen til kortlægning af OS-filer (memory map). Store tabeller indlæses aldrig i hukommelsen, i stedet kortlægges de nødvendige kolonner direkte i hukommelsen, og kun den del af dem, der er nødvendig (hvor indekserne også hjælper), indlæses faktisk. For programmøren er der ingen forskel på, om dataene er i hukommelsen eller ej; arbejdsmekanismen med mmap er fuldstændig skjult i Q's indre.
KDB+ er en ikke-relationel database, hvor tabeller kan indeholde vilkårlige data, og rækkefølgen af rækker i tabellen ændres ikke, når der tilføjes nye elementer, og kan og skal anvendes ved skrivning af forespørgsler. Dette er en essentiel egenskab for arbejde med tidsserier (data fra børsen, telemetri, begivenhedslogs), fordi hvis dataene er sorteret efter tid, så behøver brugeren ikke at anvende nogen SQL-tricks for at finde den første eller den sidste række i tid eller de N rækker, bestemme hvilken række der følger efter den N-te række osv. Jo mere forenkles join-forespørgslerne; for eksempel tager det omkring et sekund på disken og ti millisekunder i hukommelsen at finde den seneste kurs for 16000 handler VOD.L (Vodafone) i en tabel med 500 millioner elementer.
Et eksempel på et tidsmæssigt join — quote-tabellen kortlægges til hukommelsen, så der er ikke behov for at angive VOD.L i where-klausulen, indekset på sym-kolonnen anvendes implicit, og det faktum, at dataene er sorteret efter tid. Næsten alle joins i Q er almindelige funktioner og ikke en del af select-udtrykket:
1. aj[`sym`time;select from trade where date=2019.03.26, sym=`VOD.L;select from quote where date=2019.03.26]
Det skal endelig nævnes, at ingeniører hos KX, lige fra Arthur Whitney, er reelt besatte af effektivitet og gør alt for at maksimere de standardfunktioner, Q tilbyder, samt optimere de mest almindelige brugsmetoder.
Resultat
KDB+ er populært blandt virksomheder primært på grund af sin exceptionelle alsidighed — det fungerer lige godt som in-memory database, som en database til opbevaring af terabyte historiske data, og som en platform til dataanalyse. Da databehandling sker direkte i databasen, opnås der høj hastighed og ressourcebesparelse. Et fuldgyldigt programmeringssprog integreret med databasedesigns funktioner gør det muligt at implementere hele den nødvendige processtack på én platform — fra datainnhentning til behandling af brugerforespørgsler.
Yderligere oplysninger
Ulemper
En væsentlig ulempe ved KDB+/Q er den høje indgangsbarriere. Sproget har en mærkelig syntaks, og nogle funktioner er stærkt overbelastede (value har eksempelvis omtrent 11 anvendelsesmuligheder). Mest afgørende er, at det kræver en radikalt anderledes tilgang til programmering. I det vektorbasserede sprog skal man konstant tænke i termer af array-transformationer, og alle loop-strukturere vil blive implementeret gennem forskellige versioner af map/reduce funktioner (der kaldes adverbs i Q), man må aldrig forsøge at spare ved at erstatte vektoroperationer med atomare.
For at finde indekset for det N-te forekomst af et element i et array bør man skrive:
1. (where element=vector)[N] selvom dette virker skræmmende ineffektivt i forhold til C/Java (= skaber en boolesk vektor, hvor where returnerer indekserne for 'true' elementer i den). Men denne notation gør betydningen af udtrykket mere forståelig, og man bruger hurtige vektoroperationer i stedet for langsomme atomare. Den konceptuelle forskel mellem et vektorsprog og andre er sammenlignelig med forskellen mellem imperativ og funktionel programmeringsmetodologi, og man skal være forberedt på dette.
Nogle brugere er også utilfredse med QSQL. Det skyldes, at det kun ligner ægte SQL. I virkeligheden er det blot en fortolker af SQL-lignende udtryk, som ikke understøtter optimering af forespørgsler. Brugeren skal selv skrive optimale forespørgsler, og det er på Q, hvilket mange ikke er klar til. På den anden side kan man selvfølgelig altid skrive en optimal forespørgsel selv i stedet for at stole på en sort boks-optimerer.
Som en fordel er bogen om Q — Q For Mortals tilgængelig gratis på , derudover er der samlet mange andre nyttige materialer.
En stor ulempe er licensomkostningerne. Det koster titusindvis af dollars om året pr. CPU. Kun store virksomheder har råd til sådanne udgifter. For nylig har KX gjort licenspolitikken mere fleksibel og tilbyder muligheden for kun at betale for brugen eller leje KDB+ i Googles og Amazons cloud. KX tilbyder også en (32-bit version eller 64-bit version på forespørgsel).
Konkurrenter
Der findes en række specialiserede databaser, der er opbygget efter lignende principper - kolonnebaserede, in-memory, og rettet mod meget store datamængder. Problemet er, at disse netop er specialiserede databaser. Et klart eksempel er Clickhouse. Denne database har en datalagrings- og indeksopbygningsmetode, der ligner KDB+, og den udfører nogle forespørgsler hurtigere end KDB+, omend ikke væsentligt. Men selv som database er Clickhouse mere specialiseret end KDB+ - webanalyse kontra vilkårlige tidsserier (denne forskel er meget vigtig - på grund af den findes der for eksempel ikke mulighed for at bruge rækkefølgen af poster i Clickhouse). Det vigtigste er dog, at Clickhouse ikke har den alsidighed, som KDB+ tilbyder, hvilket betyder, at man kan behandle data direkte i databasen, uden at skulle indlæse dem i en separat applikation, samt bygge vilkårlige SQL-udtryk og anvende vilkårlige funktioner i forespørgslen, og skabe processer, der ikke er knyttet til udførelsen af funktionerne i den historiske database. Derfor er det svært at sammenligne KDB+ med andre databaser; de kan være bedre i specifikke brugsscenarier eller bare bedre, når man taler om opgaver fra klassiske databaser, men jeg kender ikke noget andet så effektivt og alsidigt værktøj til behandling af tidsdata.
Integration med Python
For at forenkle arbejdet med KDB+ for folk, der ikke er bekendt med teknologien, har KX skabt biblioteker til tæt integration med Python inden for én proces. Man kan både kalde enhver Python-funktion fra Q og omvendt - kalde enhver Q-funktion fra Python (herunder QSQL-udtryk). Bibliotekerne konverterer data fra det ene sprogformat til det andet efter behov (ikke altid for effektivitetens skyld). Resultatet er, at Q og Python lever i et så tæt symbiose, at grænserne mellem dem udviskes. Som resultat har programmøren, på den ene side, fuld adgang til adskillige nyttige Python-biblioteker, og på den anden side, får han en hurtig database integreret i Python til arbejde med store datamængder, hvilket er særligt nyttigt for dem, der beskæftiger sig med maskinlæring eller modellering.
Arbejder med Q i Python:
1. >>> q()
2. q)trade:([]date:();sym:();qty:())
3. q)
4. >>> q.insert('trade', (date(2006,10,6), 'IBM', 200))
5. k(',0')
6. >>> q.insert('trade', (date(2006,10,6), 'MSFT', 100))
7. k(',1')
Links
Virksomhedens websted -
Websted for udviklere -
Bogen Q For Mortals (på engelsk) —
Artikler om anvendelser af KDB+/Q fra ansatte hos kx —
Kilde: habr.com
