

Nogle virksomheder, herunder vores kunde, udvikler produktet gennem et partnernetværk. For eksempel er store online butikker integreret med en leveringsservice - du bestiller en vare og modtager snart et trackingnummer på pakken. Et andet eksempel er, når du køber en flybillet, køber du forsikring eller en billet til ekspresflybussen.
Dette kræver én API, som skal udleveres til partnerne gennem API Gateway. Denne opgave har vi løst. I denne artikel vil vi dele detaljerne.
Givet: et økosystem og en API-portal med et interface, hvor brugerne er registreret, modtager information osv. Vi skal lave en brugervenlig og pålidelig API Gateway. I processen skulle vi sikre
- registrering,
- kontrol af tilslutning til API,
- overvågning af, hvordan brugere anvender det endelige system,
- opgørelse over forretningsparametre.
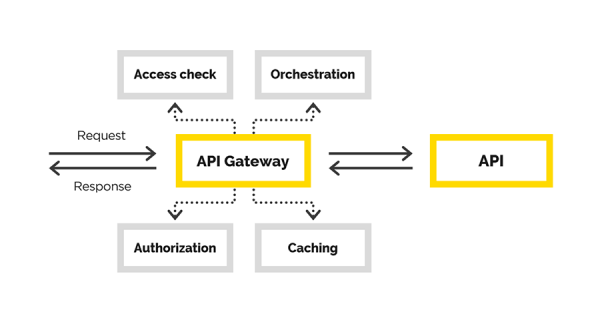
I artiklen vil vi fortælle om vores erfaring med at skabe API Gateway, hvor vi har løst følgende opgaver:
- autentificering af bruger,
- autorisation af bruger,
- modifikation af den oprindelige forespørgsel,
- proxyering af forespørgsel,
- efterbehandling af svaret.
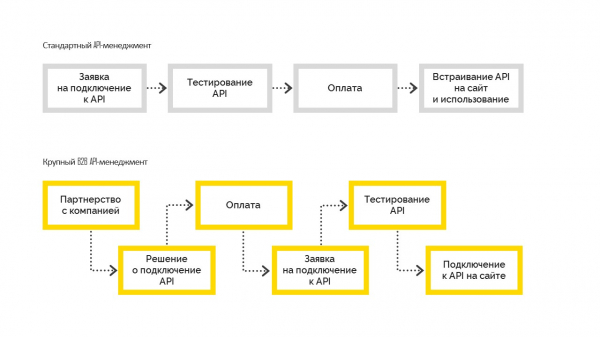
Der er to former for API-management:
1. Standard, der fungerer på følgende måde: Før tilslutning tester brugeren mulighederne, derefter betaler de og integrerer på deres hjemmeside. Det anvendes oftest i små og mellemstore virksomheder.
2. Stor B2B API Management, hvor virksomheden først træffer en forretningsbeslutning om tilslutning, bliver partner med virksomheden med kontraktforpligtelser og tilslutter sig derefter API'en. Og først efter at have fået alle formaliteterne på plads, får virksomheden testadgang, gennemgår testning og går i produktion. Men dette er umuligt uden en ledelsesmæssig beslutning om tilslutning.
Vores løsning
I denne del vil vi fortælle om oprettelsen af API Gateway.
De endelige brugere af den oprettede API Gateway er partnere til vores kunde. For hver af dem har vi allerede de nødvendige kontrakter gemt. Vi skal blot udvide funktionaliteten ved at angive den tildelte adgang til gatewayen. Derfor er der behov for en kontrolleret proces til tilslutning og styring.
Selvfølgelig kunne man have valgt en færdig løsning til at løse opgaven med API Management og oprettelse af API Gateway specifikt. For eksempel kunne det væreDet passede os ikke, fordi vi allerede havde en API-portal og et stort økosystem bygget omkring den. Alle brugere var allerede registreret, og de forstod allerede, hvor og hvordan de kunne få de nødvendige oplysninger. De nødvendige grænseflader var allerede til stede i API-portalen, vi havde kun brug for API Gateway. Det var faktisk udviklingen af den, vi gik i gang med.
Det, vi kalder API Gateway, er en slags proxy. Her havde vi igen et valg — vi kunne enten skrive vores egen proxy, eller vælge noget, der allerede var klar. I dette tilfælde valgte vi den anden vej og valgte en kombination af nginx+Lua. Hvorfor? Vi havde brug for pålidelig, testet software, der understøttede skalerbarhed. Vi ønskede ikke at skulle kontrollere både forretningslogikkens korrekthed og proxyens funktionalitet efter implementeringen.
Enhver webserver har en procespipeline til håndtering af anmodninger. I tilfælde af nginx ser den sådan ud:
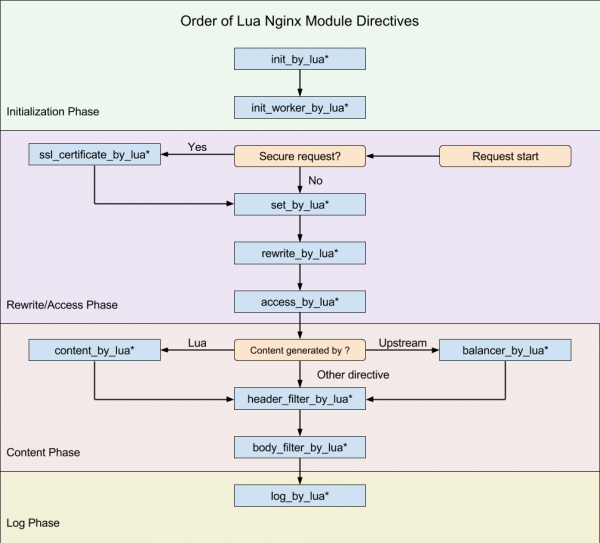
(diagram fra )
Vores mål var at integrere os i denne pipeline på det tidspunkt, hvor vi kunne modificere den oprindelige anmodning.
Vi ønsker at skabe en transparent proxy, så anmodningen funktionelt forbliver, som den kom. Vi kontrollerer blot adgangen til den endelige API og hjælper anmodningen med at nå frem til den. Hvis anmodningen var forkert, skal den endelige API vise fejlen, men ikke vi. Den eneste grund til, at vi kan afvise anmodningen, er manglende adgang for klienten.
Der findes allerede og få en fungerende kommando. . Lua er et scriptsprog, som er meget letvægtigt og nemt at lære. På den måde gennemførte vi den nødvendige logik med hjælp fra Lua.
Konfigurationen af nginx (analogi til ruten i applikationen), hvor alt arbejdet udføres, er ganske forståelig. Bemærk her den sidste direktiv — post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Lad os se på, hvad der sker i denne konfiguration:
more_clear_input_headers — renser værdien af de angivne headere efter direktivet.
lua_need_request_body — regulerer, om det er nødvendigt at læse den oprindelige anmodningslegeme, før der udføres direktiverne rewrite/access/access_by_lua. Som standard læser nginx ikke legemet af klientanmodningen, og hvis du har brug for at få adgang til det, skal denne direktiv have værdien on.
rewrite_by_lua_file — sti til scripts, som beskriver logikken for modificering af anmodningen
access_by_lua_file — sti til scriptet, som beskriver logikken for at kontrollere adgangen til ressourcen.
proxy_pass — url, hvortil anmodningen vil blive proxied.
body_filter_by_lua_file — sti til scriptet, som beskriver logikken for at filtrere anmodningen, inden den returneres til klienten.
Og til sidst, post_action — en officielt uofficiel direktiv, som gør det muligt at udføre yderligere handlinger efter at svaret er givet til klienten.
Vi vil nu fortælle i rækkefølge, hvordan vi løste vores opgaver.
Autorisation/authentifikation og modificering af anmodningen
Godkendelse
Vi har etableret autorisation og autentifikation ved hjælp af adgang baseret på certifikat. Der er et rodcertifikat. Hver ny kunde til bestilleren får genereret sit eget personlige certifikat, som giver adgang til API'et. Dette certifikat konfigureres i serversektionen af nginx-indstillingerne.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Modificering
Der kan opstå et legitimt spørgsmål: hvad skal man gøre med en certificeret klient, hvis vi pludselig ønsker at frakoble ham fra systemet? Det ville ikke være rimeligt at genudstede certifikater til alle andre kunder.
Så vi har blødt landet til den næste opgave — modificering af den oprindelige anmodning. Den oprindelige anmodning fra klienten er generelt ikke gyldig for det endelige system. En af opgaverne er at tilføje de manglende elementer i anmodningen for at gøre den gyldig. Det særlige er, at de manglende data varierer for hver klient. Vi ved, at klienten henvender sig til os med et certifikat, hvorfra vi kan tage et fingeraftryk og trække de nødvendige data fra databasen.
Hvis der på et tidspunkt bliver behov for at frakoble klienten fra vores service, vil hans data forsvinde fra databasen, og han vil ikke kunne gøre noget.
Arbejde med klientdata
Vi havde brug for at sikre høj tilgængelighed af løsningen, især når det gælder, hvordan vi får klientdata. Problemet er, at kilden til disse data er en tredjepartstjeneste, som ikke garanterer uafbrudt og tilstrækkelig høj hastighed.
Derfor var vi nødt til at sikre høj tilgængelighed af klientdata. Som værktøj valgte vi , som giver os:
- hurtig adgang til data,
- muligheden for at organisere et cluster af flere noder med replikerede data på forskellige noder.
Vi valgte den enkleste strategi til at levere data til cachen:
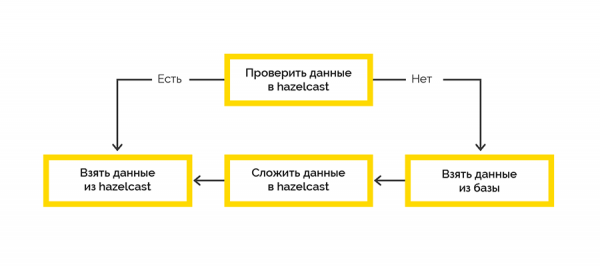
Arbejdet med det endelige system foregår i sessioner, og der er en grænse for det maksimale antal. Hvis kunden ikke lukker sessionen, må vi gøre det.
Data om den åbne session kommer fra det endelige system og bliver oprindeligt behandlet på Lua-siden. Vi besluttede at bruge Hazelcast til at gemme disse data med en job, der er skrevet i .NET. Derefter tjekker vi med jævne mellemrum retten til at forblive åbne sessioner og lukker de udløbne.
Adgang til Hazelcast både fra Lua og fra .NET
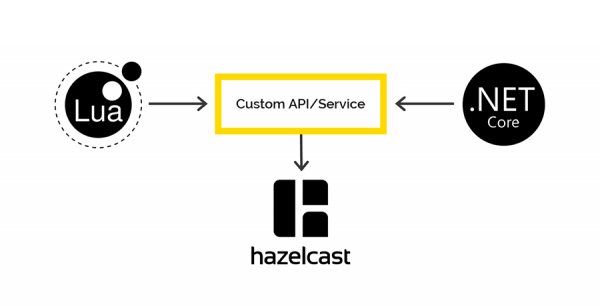
Der findes ikke klienter til Lua for at arbejde med Hazelcast, men Hazelcast har et REST API, som vi valgte at benytte. For .NET er der , som vi planlagde at få adgang til data fra Hazelcast på .NET-siden. Men ikke så hurtigt.
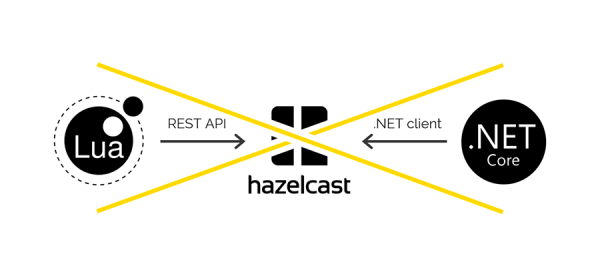
Når data gemmes via REST og hentes gennem .NET-klienten, bruges forskellige serialisatorer deserialisatorer. Derfor er det umuligt at lagre data via REST og hente dem gennem .NET-klienten og omvendt.
Hvis der er interesserede, vil vi fortælle mere om dette problem i en separat artikel. Spoiler - på diagrammet.
Logging og overvågning
Vores virksomhedstandard for logging gennem .NET er Serilog, alle logs havner til sidst i Elasticsearch, og vi analyserer dem via Kibana. Vi ønskede at gøre noget lignende i dette tilfælde. Den eneste til at arbejde med Elastic på Lua, der blev fundet, brød sammen på den første require. Og vi brugte Fluentd.
— en open source-løsning til at levere et enhedslag af applikationslogging. Giver mulighed for at samle logs fra forskellige lag af applikationen og derefter sende dem til en samlet kilde.
API Gateway kører i K8S, så vi besluttede at tilføje en container med fluentd til den samme pod for at skrive logs til den eksisterende åbne TCP-port fluentd.
Vi undersøgte også, hvordan fluentd ville fungere, hvis den ikke havde forbindelse til Elasticsearch. I to dage modtog gatewayen kontinuerligt forespørgsler, logs blev sendt til fluentd, men IP-adressen til Elastic blev blokeret for fluentd. Efter genoprettelsen af forbindelsen sendte fluentd alle logs perfekt til Elastic.
Konklusion
Den valgte tilgang til implementering gjorde det muligt for os at levere et reelt fungerende produkt til driftsmiljøet på blot 2,5 måneder.
Hvis du nogensinde skulle beskæftige dig med lignende opgaver, anbefaler vi først at forstå klart, hvilken opgave du løser, og hvilke ressourcer du allerede har. Vær opmærksom på udfordringerne ved integration med eksisterende API-styringssystemer.
Forstå for dig selv, hvad præcist du har tænkt dig at udvikle - kun forretningslogikken til behandling af anmodninger eller, som det kunne være i vores tilfælde, en fuld proxy. Glem ikke, at alt det, du laver selv, skal testes grundigt senere.
Kilde: habr.com
