

Vi fortsætter med at præsentere dig for Cisco HyperFlex hyperkonvergerende system.
I april 2019 afholder Cisco endnu en række demonstrationer af det nye hyperkonvergerende løsning, Cisco HyperFlex, i Rusland og Kasakhstan. Du kan tilmelde dig demonstrationerne via kontaktformularen ved at følge linket. Deltag!
Tidligere har vi offentliggjort en artikel om belastningstest udført af det uafhængige laboratorium ESG Lab i 2017. I 2018 forbedredes egenskaberne for Cisco HyperFlex-løsningen (version HX 3.0) betydeligt. Derudover fortsætter konkurrenceprægede løsninger også med at forbedre sig. Derfor offentliggør vi en ny og mere opdateret version af de komparative belastningstest fra ESG.
I sommeren 2018 udførte ESG-laboratoriet en ny sammenligning af Cisco HyperFlex med konkurrenterne. I lyset af den moderne tendens til at anvende softwaredefinerede løsninger blev producenter af sådanne platforme også inkluderet i den komparative analyse.
Testkonfigurationer
I forbindelse med testningen blev HyperFlex sammenlignet med to fuldt softwarebaserede hyperkonvergerende systemer, som kan installeres på standard x86-servere, samt med én software-hardwareløsning. Testningen blev udført ved hjælp af det standardiserede software til hyperkonvergerende systemer - HCIBench, der bruger Oracle Vdbench-værktøjet og automatiserer testprocessen. HCIBench opretter automatisk virtuelle maskiner, koordinerer belastningen mellem dem og genererer brugervenlige og klare rapporter.
Der blev oprettet 140 virtuelle maskiner på klusteret (35 på node i klusteret). Hver virtuel maskine brugte 4 vCPU, 4 GB RAM. Den lokale disk for VM var 16 GB og en ekstra disk på 40 GB.
De følgende klusterkonfigurationer deltog i testningen:
- kluster bestående af fire noder med Cisco HyperFlex 220C 1 x 400 GB SSD til cache og 6 x 1,2 TB SAS HDD til data;
- kluster fra konkurrenten Vendor A bestående af fire noder med 2 x 400 GB SSD til cache og 4 x 1 TB SATA HDD til data;
- kluster fra konkurrenten Vendor B bestående af fire noder med 2 x 400 GB SSD til cache og 12 x 1,2 TB SAS HDD til data;
- kluster fra konkurrenten Vendor C bestående af fire noder med 4 x 480 GB SSD til cache og 12 x 900 GB SAS HDD til data.
Processorerne og RAM-memoerne for alle løsninger var identiske.
Test af antallet af virtuelle maskiner
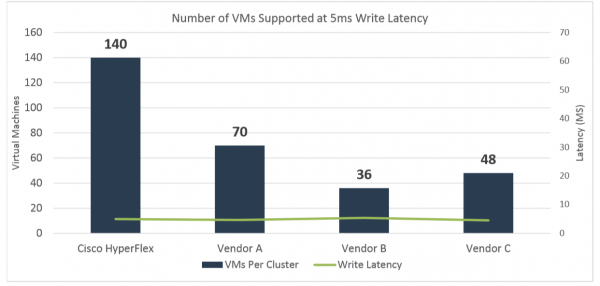
Testen begyndte med en arbejdsbyrde designet til at emulere en standard OLTP-test: læsning/skrivning (RW) 70%/30%, 100% FullRandom med et målværdi på 800 IOPS pr. virtuel maskine (VM). Testen blev udført på 140 VM'er i hver klynge i løbet af tre til fire timer. Målet med testen var at opretholde skriveforsinkelser på det maksimale antal VM'er på 5 millisekunder eller derunder.
Som resultat af testen (se grafen nedenfor) var HyperFlex den eneste platform, der gennemførte denne test med de oprindelige 140 VM'er og med forsinkelser på under 5 ms (4,95 ms). For hver af de andre klynger blev testen genstartet for at justere antallet af VM'er til den ønskede forsinkelse på 5 ms gennem flere iterationer.
Leverandør A klarede sig succesfuldt med 70 VM'er med en gennemsnitlig svartid på 4,65 ms.
Leverandør B opnåede de krævede forsinkelser på 5,37 ms med kun 36 VM'er.
Leverandør C kunne håndtere 48 virtuelle maskiner med en svartid på 5,02 ms.
Emulering af SQL Server-belastning
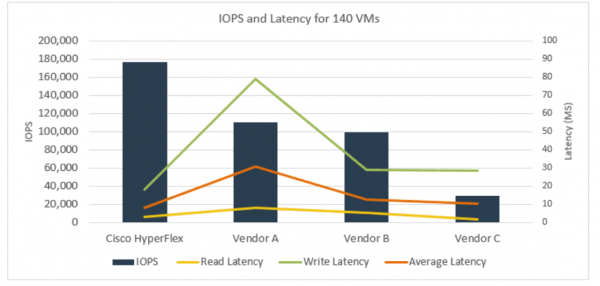
Dernæst emulerede ESG Lab SQL Server-belastningen. Testen brugte forskellige block størrelser og læse/skrive-forhold. Testen blev også kørt på 140 virtuelle maskiner.
Som vist på figuren nedenfor overgik Cisco HyperFlex næsten dobbelt så mange IOPS som leverandør A og B, og leverandør C med mere end fem gange. Gennemsnitlig svartid for Cisco HyperFlex var 8,2 ms. Til sammenligning var den gennemsnitlige svartid for leverandør A 30,6 ms, for leverandør B 12,8 ms, og for leverandør C 10,33 ms.
Et interessant observation blev gjort under alle testene. Leverandør B viste en betydelig variation i den gennemsnitlige ydeevne i IOPS på tværs af forskellige VM'er. Det vil sige, at belastningen blev distribueret ekstremt ujævnt, nogle VM'er arbejdede med et gennemsnit på 1000 IOPS+, mens andre arbejdede med 64 IOPS. Cisco HyperFlex så i denne sammenhæng betydeligt mere stabil ud; alle 140 VM'er fik i gennemsnit 600 IOPS fra lagersystemet, hvilket betød, at belastningen mellem de virtuelle maskiner var distribueret meget jævnt.
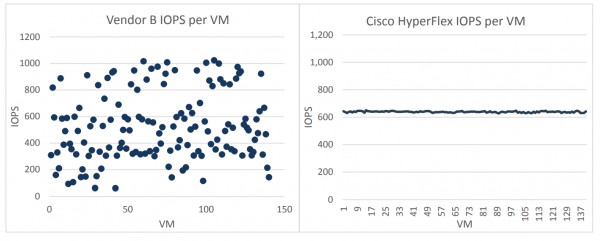
Det er vigtigt at bemærke, at denne ujævne fordeling af IOPS på de virtuelle maskiner hos leverandør B blev observeret i hver testiteration.
I et reelt produktionsmiljø kan denne adfærd fra systemet være et stort problem for administratorer, da enkelte virtuelle maskiner tilfældigt begynder at "låse sig fast", og der stort set ikke er nogen måde at kontrollere denne proces på. Den eneste, ikke særligt effektive metode til at udligne belastningen, når man bruger en løsning fra leverandør B, er at anvende en eller anden implementering af QoS eller belastningsbalancering.
Output
Lad os overveje, hvad 140 virtuelle maskiner hos Cisco Hyperflex på én fysisk node betyder i forhold til 70 eller færre hos andre løsninger? Det betyder for virksomheden, at man har brug for færre noder for at opretholde det samme antal applikationer på Hyperflex, altså halvdelen af, hvad konkurrenternes løsninger kræver, hvilket gør den samlede systemomkostning betydeligt lavere. Hvis man tillader sig at lægge et automatiseringslag ovenpå alle netværksdrift, servere og HX Data Platform, bliver det klart, hvorfor Cisco Hyperflex-løsninger hurtigt vinder indpas på markedet.
Generelt har ESG-laboratoriet bekræftet, at de hybride Cisco HyperFlex-versioner HX 3.0 leverer en højere og mere stabil ydeevne end andre tilsvarende løsninger.
Desuden har de hybride HyperFlex-klynger overgået konkurrenterne i IOPS og latenstid. Ikke mindre vigtigt er det, at HyperFlex' ydeevne blev opretholdt ved en meget godt distribueret belastning over hele lageret.
Lad os minde om, at du allerede nu kan se Cisco Hyperflex-løsningen og bekræfte dens kapaciteter. Systemet er tilgængeligt for demonstration for alle interesserede:
Kilde: habr.com
