

I den forrige Vi har dækket de teoretiske grundlag for reaktiv arkitektur. Det er tid til at tale om datastrømme, implementeringsveje for reaktive Erlang/Elixir systemer og meddelelsesmønstre i dem:
- Request-response
- Request-Chunked Response
- Response with Request
- Publish-subscribe
- Inverted Publish-subscribe
- Task distribution
SOA, MSA og meddelelser
SOA, MSA - systemarkitekturer, der definerer reglerne for opbygning af systemer, mens messaging giver primitivtilgange til deres implementering.
Jeg ønsker ikke at fremme en bestemt arkitektur til systemopbygning. Jeg er tilhænger af at anvende de mest effektive og nyttige praksisser for det specifikke projekt og forretning. Uanset hvilken paradygme vi vælger, er det bedst at skabe systemkomponenter med hensyn til Unix-principperne: komponenter med minimal sammenhæng, der er ansvarlige for individuelle enheder. API-metoderne udfører så enkle handlinger som muligt med enheder.
Messaging - som navnet antyder - er en meddelelsesbroker. Dens primære formål er at modtage og sende meddelelser. Den håndterer grænseflader til informationsafsendelse, opbygning af logiske informationskanaler inden for systemet, routing og belastningsbalancering, samt fejlhåndtering på systemniveau.
Det udviklede messaging forsøger ikke at konkurrere med rabbitmq eller erstatte det. Dets primære egenskaber er:
- Distribution.
Udvekslingspunkter kan oprettes på alle noder i klyngen, så tæt som muligt på koden, der bruger dem. - Simplicity.
Fokus på at minimere skabelonkode og brugervenlighed. - Bedste ydeevne.
Vi forsøger ikke at gentage funktionaliteten af rabbitmq, men fremhæver blot den arkitektoniske og transportlag, som vi nemt integrerer i OTP, og dermed minimerer omkostningerne. - Fleksibilitet.
Hver service kan kombinere flere meddelelsesmønstre. - Fejltolerance indbygget i designet.
- Skalerbarhed.
Messaging vokser sammen med applikationen. Efterhånden som belastningen stiger, kan udvekslingspunkter flyttes til separate maskiner.
Bemærkning. Når det kommer til organisering af kode, er meta-projekter velegnede til komplekse systemer i Erlang/Elixir. Al kode for projektet findes i et enkelt repository - et overprojekt. Mikroservices er samtidig maksimalt isolerede og udfører enkle operationer, der svarer til en enkelt enhed. Med denne tilgang er det nemt at vedligeholde API'et for hele systemet, foretage ændringer og skrive enheds- og integrationstest.
Systemkomponenter interagerer direkte eller via en broker. Fra et messaging-perspektiv har hver service flere livsfaser:
- Initialisering af service.
På dette trin sker konfiguration og opstart af den udførende serviceproces samt afhængigheder. - Oprettelse af en exchange point.
Servicen kan bruge et statisk exchange point, der er angivet i nodens konfiguration, eller den kan oprette exchange points dynamisk. - Registrering af service.
For at en service kan betjene anmodninger, skal den registreres på exchange point. - Normal drift.
Servicen udfører nyttigt arbejde. - Afslutning af drift.
Der er 2 former for afslutning: planmæssig og nødstop. Ved planmæssig afslutning frakobles servicen fra exchange point og stoppes. I nødssituationer udfører messaging et af nedbrudshåndteringsscenarierne.
Det ser ret kompliceret ud, men i koden er det ikke så skræmmende. Eksempler på kode med kommentarer vil blive præsenteret i gennemgangen af skabeloner lidt senere.
Exchanges
Et exchange point er en messaging-proces, der implementerer logikken for interaktion med komponenter inden for rammerne af messaging skabelonen. I alle de nedenstående eksempler interagerer komponenterne gennem exchange points, og kombinationen af dem danner messaging.
Message exchange patterns (MEPs)
Globalt kan mønstre for udveksling opdeles i to-vejs og én-vejs. De første indebærer et svar på den modtagne besked, de sidstnævnte gør ikke. Et klassisk eksempel på et to-vejs mønster i klient-server-arkitektur er Request-response mønsteret. Lad os se på mønsteret og dets modifikationer.
Request–response eller RPC
RPC anvendes, når vi har brug for et svar fra en anden proces. Denne proces kan være startet på den samme node eller være placeret på en anden kontinent. Nedenfor er et skema for interaktionen mellem klienten og server gennem messaging.
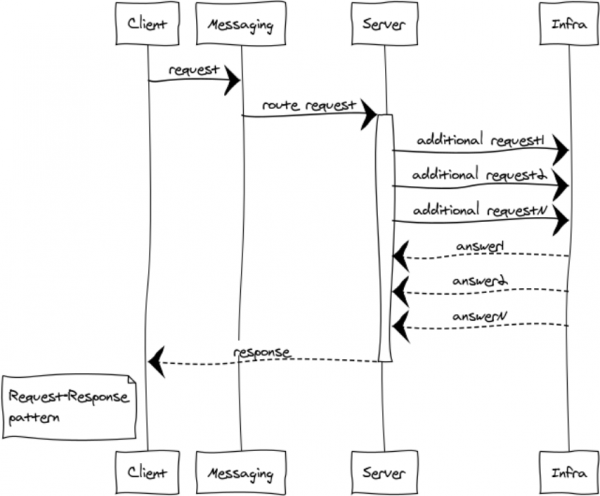
Da messaging er helt asynkron, opdeles udvekslingen for klienten i 2 faser:
Afsendelse af anmodning
messaging:request(Exchange, ResponseMatchingTag, RequestDefinition, HandlerProcess).Exchange ‒ et unikt navn på udvekslingspunktet
ResponseMatchingTag ‒ en lokal mærkat til behandling af svaret. For eksempel ved sending af flere ens anmodninger, der tilhører forskellige brugere.
RequestDefinition ‒ anmodningens krop
HandlerProcess ‒ PID for handleren. Denne proces vil modtage svaret fra serveren.Behandling af svaret
handle_info(#'$msg'{exchange = EXCHANGE, tag = ResponseMatchingTag,message = ResponsePayload}, State)ResponsePayload ‒ serverens svar.
For serveren består processen også af 2 faser:
- Initialisering af udvekslingspunktet
- Behandling af modtagne anmodninger
Lad os illustrere denne skabelon med kode. Antag, at vi skal implementere en simpel tjeneste, der giver et enkelt præcist tidspunkt.
Serverkode
Lad os flytte API-definitionen til tjenesten til api.hrl:
%% =====================================================
%%  entities
%% =====================================================
-record(time, {
  unixtime :: non_neg_integer(),
  datetime :: binary()
}).

-record(time_error, {
  code :: non_neg_integer(),
  error :: term()
}).

%% =====================================================
%%  methods
%% =====================================================
-record(time_req, {
  opts :: term()
}).
-record(time_resp, {
  result :: #time{} | #time_error{}
}).
Definér tjenestens controller i time_controller.erl
%% Eksemplet viser kun den meningsfulde kode. Ved at indsætte det i skabelonen gen_server kan vi få en fungerende tjeneste.

%% initialisering af gen_server
init(Args) ->
  %% forbindelse til udvekslingspunktet
  messaging:monitor_exchange(req_resp, ?EXCHANGE, default, self())
  {ok, #{}}.

%% behandling af begivenheden for tab af forbindelse til udvekslingspunktet. Den samme begivenhed opstår, hvis udvekslingspunktet ikke er startet endnu.
handle_info(#exchange_die{exchange = ?EXCHANGE}, State) ->
  erlang:send(self(), monitor_exchange),
  {noreply, State};

%% behandling af API
handle_info(#time_req{opts = _Opts}, State) ->
  messaging:response_once(Client, #time_resp{
result = #time{ unixtime = time_utils:unixtime(now()), datetime = time_utils:iso8601_fmt(now())}
  });
  {noreply, State};

%% afslutning af gen_server
terminate(_Reason, _State) ->
  messaging:demonitor_exchange(req_resp, ?EXCHANGE, default, self()),
  ok.
Klientkode
For at sende en anmodning til tjenesten kan vi kalde messaging request API'et hvor som helst i klienten:
case messaging:request(?EXCHANGE, tag, #time_req{opts = #{}}, self()) of
    ok -> ok;
    _ -> %% gentag eller fejllogik
end
I et distribueret system kan komponentkonfigurationen være meget forskellig, og på tidspunktet for anmodningen kan messaging muligvis ikke være startet, eller tjenestens controller vil ikke være klar til at håndtere anmodningen. Derfor skal vi kontrollere svaret fra messaging og håndtere tilfellet for afvisning.
Efter at klienten har sendt anmodningen, vil svaret eller en fejl komme fra tjenesten.
Lad os håndtere begge tilfælde i handle_info:
handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time{unixtime = Utime}}}, State) ->
  ?debugVal(Utime),
  {noreply, State};

handle_info(#'$msg'{exchange = ?EXCHANGE, tag = tag, message = #time_resp{result = #time_error{code = ErrorCode}}}, State) ->
  ?debugVal({error, ErrorCode}),
  {noreply, State};
Request-Chunked Response
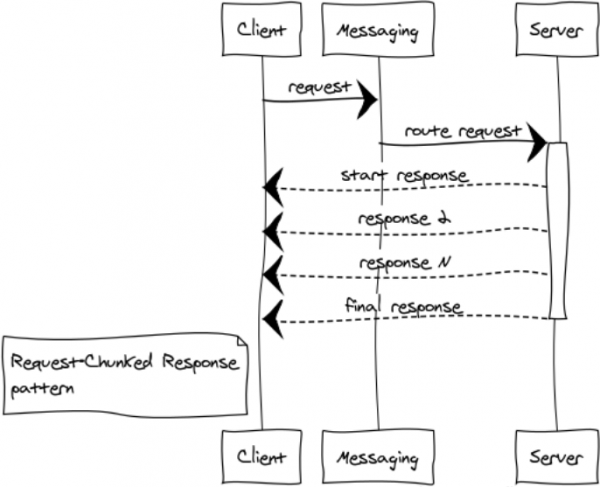
Det er bedre ikke at tillade overførsel af store beskeder. Dette afhænger af reaktionshastigheden og den stabile drift af hele systemet. Hvis svar på en anmodning kræver meget hukommelse, er det nødvendigt at opdele det i dele.
Her er et par eksempler på sådanne tilfælde:
- Komponenter udveksler binære data, for eksempel filer. At opdele svaret i mindre dele hjælper med effektivt at arbejde med filer af enhver størrelse og undgå hukommelsesoverløb.
- Lister. For eksempel skal vi vælge alle poster fra en kæmpestor tabel i databasen og sende den til en anden komponent.
Jeg kalder sådanne svar for en lokomotiv. Under alle omstændigheder er 1024 beskeder på 1 MB bedre end en enkelt besked på 1 GB.
I et Erlang-kluster opnår vi ekstra gevinst ‒ reduktion af belastningen på udvekslingspunktet og netværket, da svarene sendes direkte til modtageren, omgås udvekslingspunktet.
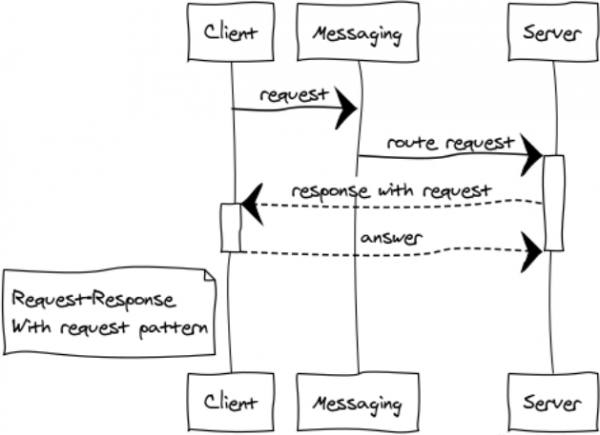
Response with Request
Dette er en ret sjælden modifikation af RPC-mønsteret til opbygning af dialogsystemer.
Publish-subscribe (data distribution tree)
Begivenhedsorienterede systemer leverer data til forbrugere, efterhånden som de er klar. Således er systemerne mere tilbøjelige til en push-model snarere end pull eller poll. Denne egenskab forhindrer unødvendig ressourceforbrug ved konstant at anmode om og vente på data.
Illustrationen viser processen med at distribuere meddelelser til forbrugere, der er tilmeldt et bestemt emne.
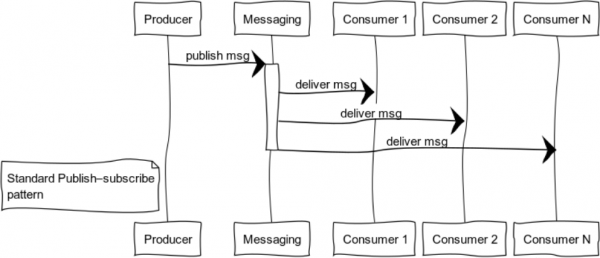
Klassiske eksempler på brug af dette mønster er distribution af tilstand: den virtuelle verden i computerspil, markedsdata på børser, nyttige oplysninger i datafeeds.
Lad os overveje abonnentens kode:
init(_Args) ->
  %% vi tilmelder os udvekslingen, nøgle = key
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {ok, #{}}.

handle_info(#exchange_die{exchange = ?SUBSCRIPTION}, State) ->
  %% hvis udvekslingspunktet ikke er tilgængeligt, så prøver vi at genoprette forbindelsen
  messaging:subscribe(?SUBSCRIPTION, key, tag, self()),
  {noreply, State};

%% behandler de modtagne beskeder
handle_info(#'$msg'{exchange = ?SUBSCRIPTION, message = Msg}, State) ->
  ?debugVal(Msg),
  {noreply, State};

%% ved forbrugeren standses - afmelder vi os fra udvekslingspunktet
terminate(_Reason, _State) ->
  messaging:unsubscribe(?SUBSCRIPTION, key, tag, self()),
  ok.
Kilden kan udløse meddelelsespublikationsfunktionen hvor som helst det er praktisk:
messaging:publish_message(Exchange, Key, Message).Exchange ‒ navnet på udvekslingspunktet,
Nøgle ‒ routingnøglen
Meddelelse ‒ nyttelasten
Inverted Publish-subscribe
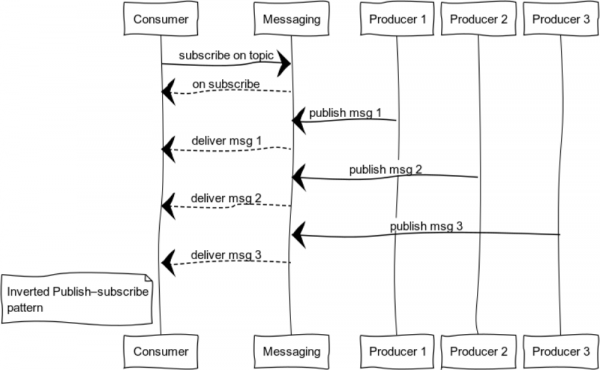
Ved at implementere pub-sub kan man opnå et mønster, der er praktisk til logning. Sættet af kilder og forbrugere kan være helt forskelligt. I diagrammet ses et tilfælde med én forbruger og mange kilder.
Opgavedistributionsmønster
I næsten hvert projekt opstår der opgaver til forsinket behandling, såsom rapportgenerering, levering af notifikationer, indhentning af data fra tredjepartssystemer. Systemets kapacitet til at udføre disse opgaver kan let skaleres ved at tilføje behandlere. Det vi skal gøre, er at danne et cluster af behandlere og jævnt fordele opgaverne mellem dem.
Lad os overveje de opståede situationer med tre behandlere som eksempel. Allerede under opgavefordelingen opstår spørgsmålet om retfærdig fordeling og overbelastning af behandlere. Retfærdigheden vil blive sikret af round-robin fordeling, og for at undgå overbelastning af behandlere vil vi indføre en begrænsning prefetch_limit. I overgangstilstande prefetch_limit vil det forhindre én behandler i at få alle opgaver.
Messaging styrer køer og behandlingsprioritet. Behandlere modtager opgaver, efterhånden som de kommer ind. Udførelsen af en opgave kan enten være vellykket eller mislykkes:
messaging:ack(Tack)‒ kaldes ved vellykket behandling af meddelelsenmessaging:nack(Tack)‒ kaldes i alle unormale situationer. Efter tilbagesendelsen vil messaging videresende opgaven til en anden behandler.
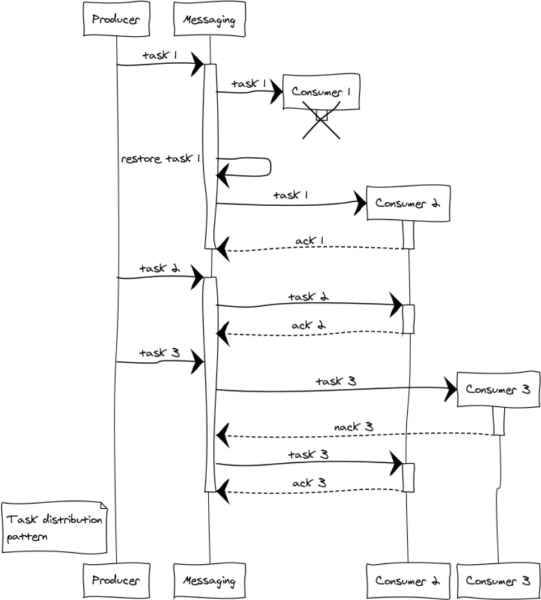
Lad os antage, at der opstod en kompleks fejl under behandlingen af tre opgaver: behandler 1 faldt efter at have modtaget opgaven, uden at have sendt noget til udvekslingspunktet. I dette tilfælde vil udvekslingspunktet efter udløbet af ack timeout sende opgaven til en anden behandler. Behandler 3 forkastede opgaven af en eller anden grund og sendte nack, så opgaven gik også til en anden behandler, som lykkedes med at udføre den.
Foreløbigt resultat
Vi har gennemgået de grundlæggende byggesten i distribuerede systemer og fået en grundlæggende forståelse af deres anvendelse i Erlang/Elixir.
Ved at kombinere de grundlæggende skabeloner kan man konstruere komplekse paradigmer til at løse de opstående opgaver.
I den afsluttende del af cyklussen vil vi se på generelle spørgsmål om organisering af tjenester, routing og load balancing, samt tale om de praktiske aspekter af skalerbarhed og fejltolerance i systemerne.
Slutningen på anden del.
Foto
Illustrationer er forberedt ved hjælp af websequencediagrams.com
Kilde: habr.com
