

Annonce
Kollegaer, midt på sommeren planlægger jeg at udgive endnu en række artikler om design af systemer til massebetjening: “Eksperiment VTrade” — et forsøg på at skrive et framework til handelssystemer. I serien vil teorien og praksis for opbygning af en børs, auktion og butik blive drøftet. I slutningen af artiklen foreslår jeg at stemme om de emner, der interesserer jer mest.
Dette er den afsluttende artikel i rækken om distribuerede reaktive applikationer på Erlang/Elixir. I kan man finde de teoretiske grundlag for reaktiv arkitektur. illustrerer de grundlæggende mønstre og mekanismer til opbygning af sådanne systemer.
I dag vil vi tage fat på spørgsmål angående udviklingen af kodebasen og projekterne generelt.
Organisering af tjenester
I det virkelige liv, når man udvikler en tjeneste, må man ofte forene flere interaktionsmønstre i én controller. For eksempel skal tjenesten users, som løser opgaver med at administrere brugerprofiler for projektet, håndtere forespørgsler req-resp og informere om opdateringer af profiler gennem pub-sub. Denne situation er ret simpel: for messaging står der én controller, som implementerer logikken for tjenesten og offentliggør opdateringer.
Situationen bliver mere kompliceret, når vi skal implementere en fejltolerant distribueret tjeneste. Antag, at kravene til users er ændret:
- nu skal tjenesten håndtere forespørgsler på 5 noder i klyngen,
- have mulighed for at udføre baggrundsbehandlingsopgaver,
- samt være i stand til dynamisk at administrere lister over abonnementer på opdateringer af profiler.
Bemærk: Spørgsmålet om konsistent lagring og replikering af data vil vi ikke behandle. Antag, at disse spørgsmål er blevet løst tidligere, og at systemet allerede har et pålideligt og skalerbart lag for lagring, og at handlere har mekanismer til interaktion med det.
Det formelle beskrivelser af tjenesten users er blevet mere kompliceret. Set fra programmørens perspektiv, takket være brugen af messaging, er ændringerne minimale. For at imødekomme det første krav skal vi konfigurere belastningsbalancering ved udvekslingspunktet req-resp.
Kravet for behandling af baggrundsopgaver opstår ofte. I users kan dette være kontrol af brugerens dokumenter, behandling af uploadet multimedie, eller synkronisering af data med sociale medier. Disse opgaver skal på en eller anden måde fordeles inden for klyngen og kontroleres. Derfor har vi to løsningsmuligheder: enten bruge skabelonen til opgavefordeling fra den tidligere artikel, eller, hvis den ikke passer, skrive en brugerdefineret opgavestyrer, der på den nødvendige måde skal håndtere puljen af behandlere.
Punkt 3 kræver en udvidelse af pub-sub skabelonen. Og for at implementere dette, efter oprettelsen af pub-sub udvekslingspunktet, skal vi yderligere starte controllere for dette punkt inden for vores service. Sådan set tager vi som om logikken for behandling af abonnementer og afmeldinger ud af messaging-laget og ind i implementationen af users.
Som et resultat viste dekompositionen af opgaven, at for at opfylde kravene skal vi køre 5 instanser af servicen på forskellige noder og oprette en ekstra enhed – en pub-sub controller, der er ansvarlig for abonnementet.
For at starte 5 behandlere kræves der ikke ændringer i servicekoden. Den eneste yderligere handling er at konfigurere balanceringsreglerne på udvekslingspunktet, hvilket vi vil tale mere om lidt senere.
Der opstod også en ekstra kompleksitet: pub-sub controllere og den brugerdefinerede opgavestyrer skal køre i en enkelt instans. Igen, messaging servicen, som det fundamentale element, skal levere en mekanisme til valg af leder.
Valg af leder
I distribuerede systemer er valg af leder – proceduren for udnævnelse af en enkelt proces, der er ansvarlig for planlægning af distribueret behandling af en eller anden belastning.
I systemer, der ikke er tilbøjelige til centralisering, anvendes universelle algoritmer og konsensusbaserede algoritmer, såsom Paxos eller Raft.
Da messaging er broker og det centrale element, kender det til alle controllere af servicen – kandidater til lederskab. Messaging kan udnævne en leder uden afholdelse af afstemning.
Alle tjenester efter start og tilslutning til udvekslingspunktet modtager en systemmeddelelse #'$leader'{exchange = ?EXCHANGE, pid = LeaderPid, servers = Servers}. I tilfælde af at LeaderPid stemmer overens med pid den nuværende proces, udnævnes han som leder, og listen over Servers inkluderer alle noder og deres parametre.
Når en ny node opstår eller en fungerende node i klyngen deaktiveres, modtager alle servicekontrollere #'$slave_up'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} og #'$slave_down'{exchange = ?EXCHANGE, pid = SlavePid, options = SlaveOpts} henholdsvis.
Dermed er alle komponenter informeret om alle ændringer, og der er altid én leder i klyngen på ethvert givent tidspunkt.
Mellemled
For at implementere komplekse distribuerede behandlingsprocesser samt ved optimering af allerede eksisterende arkitektur kan det være praktisk at anvende mellemled.
For at undgå at ændre services koden og for at løse f.eks. opgaver som yderligere behandling, routing eller logning af beskeder, kan man aktivere en proxybehandler før servicen, som udfører alt det ekstra arbejde.
Et klassisk eksempel på optimalisering af pub-sub er en distribueret applikation med et forretningskerne, der genererer opdateringsbegivenheder, som f.eks. ændring af pris på markedet, og et adgangslag - N servere, der tilbyder websocket API til webklienter.
Hvis man ser på det direkte, ser betjeningen af klienten således ud:
- klienten opretter forbindelse til platformen. På serversiden, hvor trafikken termineres, startes en proces, der håndterer denne forbindelse.
- i konteksten af den betjente proces finder autorisation og tilmelding til opdateringer sted. Processen kalder metoden subscribe for emnerne.
- efter generering af en begivenhed i kernen leveres den til processerne, der betjener forbindelserne.
Lad os forestille os, at vi har 50000 abonnenter på emnet "nyheder". Abonnenterne er jævnt fordelt på 5 servere. I sidste ende vil hver opdatering, der når frem til udvekslingspunktet, blive replikeret 50000 gange: 10000 gange på hver server, afhængigt af antallet af abonnenter der.
For at forbedre situationen, lad os introducere en proxy, der har det samme navn som udvekslingspunktet. Registratoren for globale navne skal kunne returnere den nærmeste proces efter navn, hvilket er vigtigt.
Lad os starte denne proxy på serverne i adgangslaget, og alle vores processer, der betjener websocket api, vil tilmelde sig den, og ikke det oprindelige pub-sub udvekslingspunkt i kernen. Proxyen tilmelder sig kernen kun ved unik tilmelding og replikerer de indkommende beskeder til alle sine abonnenter.
I sidste ende vil der blive sendt 5 beskeder mellem kernen og adgangsserverne i stedet for 50000.
Routing og belastningsfordeling
Req-Resp
I den nuværende implementering af messaging findes der 7 strategier til fordeling af anmodninger:
default. Anmodningen sendes til alle controllere.rundt-rundt. Der foretages en iteration og cyklisk fordeling af anmodninger mellem controllere.konsensus. Der er kontrollere, der betjener tjenesten, opdelt i leder og tilhængere. Anmodninger sendes kun til lederen.konsensus & rundt-rundt. Gruppen har en leder, men anmodninger fordeles mellem alle medlemmer.sticky. En hashfunktion beregnes og fastlægges for en bestemt behandler. Efterfølgende anmodninger med denne signatur går til den samme behandler.sticky-fun. Ved initialisering af udvekslingspunktet overføres der desuden en hashberegningsfunktion tilstickybalancering.sjov. Ligner sticky-fun, men herudover kan du omdirigere, afvise eller forbehandle det.
Fordelingsstrategien angives ved initialisering af udvekslingspunktet.
Udover balancering tillader messaging at tagge entiteter. Lad os se på typerne af tags i systemet:
- Forbindelsestag. Gør det muligt at forstå, gennem hvilken forbindelse hændelserne kom. Anvendes, når controllerprocessen forbinder til et enkelt udvekslingspunkt, men med forskellige routing-nøgler.
- Servicetag. Gør det muligt at gruppere behandlere for en enkelt service og udvide mulighederne for routing og balancing. For req-resp mønsteret er routing lineær. Vi sender en anmodning til udvekslingspunktet, som derefter sender den til tjenesten. Men hvis vi har brug for at opdele behandlere i logiske grupper, så sker opdelingen ved hjælp af tags. Når du angiver et tag, vil anmodningen blive dirigeret til en specifik gruppe controllere.
- Anmodningstag. Gør det muligt at skelne mellem svar. Da vores system er asynkront, skal svarene fra tjenesten have mulighed for at angive RequestTag ved afsendelse af anmodningen. Ved dette kan vi forstå, hvilket svar vi har modtaget på vores anmodning.
Pub-sub
For pub-sub er det lidt lettere. Vi har et udvekslingspunkt, hvor meddelelser offentliggøres. Udvekslingspunktet fordeler meddelelser mellem abonnenterne, der har tilmeldt sig de ønskede routing-nøgler (man kan sige, at det svarer til emner).
Skalérbarhed og fejlmodstand
Systemets samlede skalérbarhed afhænger af graden af skalérbarhed i systemets lag og komponenter:
- Tjenester skaleres ved at tilføje ekstra noder med behandlere af denne tjeneste til klyngen. I løbet af praktisk brug kan den optimale balanceringspolitik vælges.
- Selve messaging-tjenesten inden for en separat klynge skaleres generelt enten ved at flytte særligt belastede udvekslingspunkter til separate noder i klyngen eller ved at tilføje proxy-processer i særligt belastede områder af klyngen.
- Skalerbarheden af hele systemet som egenskab afhænger af fleksibiliteten i arkitekturen og muligheden for at samle separate klynger til en samlet logisk enhed.
Simpliciteten og hastigheden af skalerbarhed afhænger ofte af projektets succes. Messaging i den nuværende udførelse vokser sammen med applikationen. Selv hvis vi mangler en klynge med 50-60 maskiner, kan vi ty til federation. Desværre ligger emnet omkring federation uden for rammerne af denne artikel.
Redundans
Når vi taler om belastningsbalancering, har vi allerede diskuteret reservemuligheder for tjenestestyringskontrollere. Men messaging bør også være reserveret. I tilfælde af et nodetab eller maskinfejl, skal messaging automatisk gendannes, og det skal ske hurtigst muligt.
I mine projekter bruger jeg ekstra noder, der overtager belastningen i tilfælde af et nedbrud. I Erlang findes der en standardimplementering af distribueret tilstand for OTP-applikationer. Distributed mode genopretter netop i tilfælde af fejl ved at starte den nedlagte applikation på en anden, forudstartet node. Processen er gennemsigtig, efter et nedbrud flyttes applikationen automatisk til failover-noden. Du kan læse mere om denne funktionalitet. .
Ydeevne
Lad os forsøge at sammenligne ydeevnen af rabbitmq og vores tilpassede messaging rimeligt.
Jeg fandt af rabbitmq-testen fra openstack-teamet.
I punkt 6.14.1.2.1.2.2 i det originale dokument præsenteres resultatet af RPC CAST:
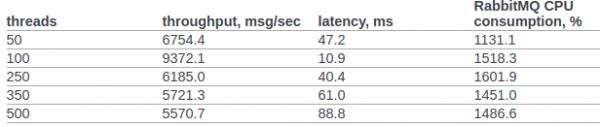
Forud for testene vil vi ikke foretage yderligere indstillinger i OS-kernen eller Erlang VM. Betingelserne for testen:
- erl opts: +A1 +sbtu.
- Testen kører i en enkelt Erlang-node på en bærbar computer med en ældre mobil i7.
- Klyngetestene kører på servere med 10G netværk.
- Koden kører i docker-containere. Netværket er i NAT-tilstand.
Testkoden:
req_resp_bench(_) ->
  W = perftest:comprehensive(10000,
    fun() ->
      messaging:request(?EXCHANGE, default, ping, self()),
      receive
        #'$msg'{message = pong} -> ok
      after 5000 ->
        throw(timeout)
      end
    end
  ),
  true = lists:any(fun(E) -> E >= 30000 end, W),
  ok.
Scenario 1: Testet kører på en bærbar med en gammel i7 mobiludgave. Test, messaging og service kører på en node i samme docker-container:
Sekventielle 10000 cyklusser på ~0 sekunder (26987 cyklusser/s)
Sekventielle 20000 cyklusser på ~1 sekund (26915 cyklusser/s)
Sekventielle 100000 cyklusser på ~4 sekunder (26957 cyklusser/s)
Parallel 2 100000 cyklusser på ~2 sekunder (44240 cyklusser/s)
Parallel 4 100000 cyklusser på ~2 sekunder (53459 cyklusser/s)
Parallel 10 100000 cyklusser på ~2 sekunder (52283 cyklusser/s)
Parallel 100 100000 cyklusser på ~3 sekunder (49317 cyklusser/s)
Scenario 2: 3 noder køres på forskellige maskiner under docker (NAT).
Sekventielle 10000 cyklusser på ~1 sekund (8684 cyklusser/s)
Sekventielle 20000 cyklusser på ~2 sekunder (8424 cyklusser/s)
Sekventielle 100000 cyklusser på ~12 sekunder (8655 cyklusser/s)
Parallel 2 100000 cyklusser på ~7 sekunder (15160 cyklusser/s)
Parallel 4 100000 cyklusser på ~5 sekunder (19133 cyklusser/s)
Parallel 10 100000 cyklusser på ~4 sekunder (24399 cyklusser/s)
Parallel 100 100000 cyklusser på ~3 sekunder (34517 cyklusser/s)
I alle tilfælde oversteg CPU-udnyttelsen ikke 250%
Resumé
Jeg håber, at denne cyklus ikke fremstår som et tankespred, og at min erfaring vil være til reel gavn for forskere inden for distribuerede systemer, samt praktikere, der står ved begyndelsen af at opbygge distribuerede arkitekturer til deres forretningssystemer og med interesse ser på Erlang/Elixir, men er i tvivl om det er værd at...
Foto
Kun registrerede brugere kan deltage i undersøgelsen. , please.
Hvilke emner bør jeg belyse mest detaljeret i cyklussen “Eksperiment VTrade”?
Teori: Markeder, ordrer og deres gyldighed: DAY, GTD, GTC, IOC, FOK, MOO, MOC, LOO, LOC
Ordrebog. Teori og praksis for implementering af bogen med grupperinger
Visualisering af handel: Ticks, barer, opløsninger. Hvordan man opbevarer og sammenkæder
Backoffice. Planlægning og udvikling. Kontrol af medarbejdere og efterforskning af hændelser
API. Vi ser på hvilke interfaces der er nødvendige, og hvordan de implementeres
Opbevaring af information: PostgreSQL, Timescale, Tarantool i handelssystemer
Reaktivitet i handelssystemer
Andet. Jeg skriver i kommentarerne
6 brugere har stemt. 4 brugere har undladt at stemme.
Kilde: habr.com
