

I denne artikel vil jeg gerne tale om særtræk ved arbejdet med All Flash-arrays fra AccelStor på en af de mest populære virtualiseringsplatforme – VMware vSphere. Især vil jeg fokusere på de parametre, der hjælper med at opnå maksimal effekt ved brug af et så kraftfuldt værktøj som All Flash.
All Flash-arrays fra AccelStor NeoSapphire™ repræsenterer eller node-enheder baseret på SSD-lagringsenheder med en helt anden tilgang til implementering af datalagringskonceptet og organisering af adgangen til det ved hjælp af egen teknologi i stedet for de meget populære RAID-algoritmer. Arraysene giver blokadgang for værter gennem Fibre Channel- eller iSCSI-grænseflader. For retfærdighedens skyld skal det nævnes, at modeller med iSCSI-grænseflade også har filadgang som en god bonus. Men i denne artikel vil vi fokusere på brugen af blokprotokoller som de mest effektive for All Flash.
Hele processen med implementering og efterfølgende konfiguration af samarbejdet mellem AccelStor-arrayet og virtualiseringssystemet VMware vSphere kan opdeles i flere faser:
- Implementering af tilslutningstopologi og opsætning af SAN-netværk;
- Konfiguration af All Flash-arrayet;
- Konfiguration af ESXi-værterne;
- Konfiguration af virtuelle maskiner.
Som udstyr til eksemplerne blev der anvendt AccelStor NeoSapphire™-arrays med Fibre Channel- og iSCSI-grænseflader. Som grundlæggende software – VMware vSphere 6.7U1.
Før implementeringen af de systemer, der beskrives i artiklen, anbefales det kraftigt at gennemgå dokumentationen fra VMware vedrørende spørgsmål om ydeevne ( ) og indstillinger for iSCSI ()
Tilslutningstopologi og opsætning af SAN-netværk
De vigtigste komponenter i SAN-netværket er HBA-adaptere i ESXi-værterne, SAN-switches og array-noder. En typisk topologi for et sådant netværk vil se således ud:
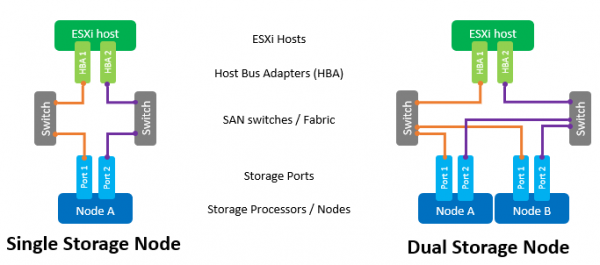
Med termen Switch forstås her både en separat fysisk switch eller et sæt af switches (Fabric) samt et delt enhed imellem forskellige tjenester (VSAN i tilfælde af Fibre Channel og VLAN i tilfælde af iSCSI). Brug af to uafhængige switches/Fabric vil eliminere muligheden for et enkelt fejlpunk.
Direkte forbindelse af værter til arrayet understøttes, men det frarådes stærkt. Ydeevnen fra All Flash arrays er meget høj. For maksimal hastighed er det nødvendigt at benytte alle porte i arrayet. Derfor er det obligatorisk at have mindst en switch mellem værterne og NeoSapphire™.
At have to porte på HBA-værten er også et krav for at opnå maksimal ydeevne og sikre fejltolerance.
Hvis Fibre Channel-grænsefladen anvendes, kræves der zoning-konfiguration for at undgå mulige kollisioner mellem initiatorer og targets. Zonerne opbygges på grundlag af princippet "én initiatorport – en eller flere porte i arrayet".
Hvis iSCSI-forbindelse anvendes, og en switch deles med andre tjenester, er det vigtigt at isolere iSCSI-trafikken inden for et separat VLAN. Det anbefales også stærkt at aktivere Jumbo Frames (MTU = 9000) for at øge størrelsen på pakkerne i netværket og dermed reducere mængden af overhead under transmission. Det er dog vigtigt at huske, at parameteren MTU skal ændres på alle netværkets komponenter i kæden "initiator-switch-target" for korrekt funktion.
Konfiguration af All Flash array
Arrayet leveres til kunderne med allerede dannede grupper . Derfor er det ikke nødvendigt at foretage handlinger for at sammenflette de opbevaringsenheder i en enkelt struktur. Det er tilstrækkeligt blot at oprette de nødvendige volumener i den ønskede størrelse og mængde.
For nemheds skyld er der en funktion til batchoprettelse af flere volumener med den specificerede størrelse på én gang. Som standard oprettes "tynde" volumener, da dette gør det muligt at udnytte den tilgængelige lagerplads mere effektivt (blandt andet takket være støtte til Space Reclamation). Med hensyn til ydeevne er forskellen mellem "tynde" og "tykke" volumener ikke mere end 1%. Men hvis det er nødvendigt at "udnytte alle ressourcer" fra arrayet, kan enhver "tynd" volumen altid konverteres til en "tyk". Men det skal huskes, at denne operation er irreversibel.
Hereafter, it is necessary to "publish" the created volumes and configure access rights for them on the part of the hosts using ACL (IP addresses for iSCSI and WWPN for FC) and physical separation by array ports. For iSCSI models, this is done by creating a Target.
For FC models, publication occurs by creating a LUN for each port of the array.
To accelerate the configuration process, hosts can be grouped together. Moreover, if a multi-port FC HBA is used on the host (which is usually the case in practice), the system automatically determines that the ports of such an HBA belong to the same host due to WWPNs differing by one. Batch creation of Target/LUN is also supported for both interfaces.
An important note when using the iSCSI interface is to create several targets for volumes at once to increase performance, as the queue on the target cannot be modified, and it will essentially be a bottleneck.
Configuring ESXi Hosts
From the perspective of ESXi hosts, the basic configuration is carried out according to a quite expected scenario. The sequence of actions for iSCSI connection:
- Add Software iSCSI Adapter (not required if it's already added, or if using a Hardware iSCSI Adapter);
- Create a vSwitch through which the iSCSI traffic will pass and add physical uplink and VMkernel to it;
- Add the addresses of the array to Dynamic Discovery;
- Create a Datastore
Some important notes:
- In general, it is certainly possible to use an existing vSwitch, but with a separate vSwitch, managing host settings will be significantly easier.
- It is necessary to separate Management traffic and iSCSI over separate physical links and/or VLANs to avoid performance issues.
- The IP addresses of VMkernel and the corresponding ports of the All Flash array must be within the same subnet again due to performance issues.
- To ensure fault tolerance according to VMware rules, the vSwitch must have at least two physical uplinks.
- If Jumbo Frames are used, it is necessary to change the MTU for both the vSwitch and the VMkernel.
- Det vil ikke være overflødigt at minde om, at ifølge VMware's anbefalinger for fysiske adaptere, der skal bruges til iSCSI trafik, er det nødvendigt at konfigurere Teaming and Failover. Specifikt skal hver VMkernel kun arbejde gennem én uplink, mens den anden uplink skal sættes til unused. For at sikre redundans skal to VMkernals tilføjes, hver af dem skal arbejde gennem sin egen uplink.
VMkernel Adapter (vmk#)
Fysisk Netværksadapter (vmnic#)
vmk1 (Storage01)
Aktive Adaptere
vmnic2
Ubrugte Adaptere
vmnic3
vmk2 (Storage02)
Aktive Adaptere
vmnic3
Ubrugte Adaptere
vmnic2
Til forbindelse via Fibre Channel kræves der ingen forudgående handlinger. Du kan straks oprette et Datastore.
Efter oprettelsen af Datastore skal du sikre dig, at Round Robin-politikken anvendes for stierne til Target/LUN som den mest effektive.
Som standard planlægger VMware at bruge denne politik efter mønsteret: 1000 anmodninger via den første sti, de næste 1000 anmodninger via den anden sti osv. Sådan interaktion mellem hosten og et to-controller array vil være ubalanceret. Derfor anbefaler vi at indstille Round Robin policy = 1 gennem Esxcli/PowerCLI.
Parametre
For Esxcli:
- Vis tilgængelige LUNs
esxcli storage nmp device list
- Kopier enhedsnavn
- Ændre Round Robin Policy
esxcli storage nmp psp roundrobin deviceconfig set —type=iops —iops=1 —device=«Device_ID»
De fleste moderne applikationer er designet til at udveksle store datapakker for at maksimere båndbredden og reducere belastningen på CPU'en. Derfor sender ESXi som standard I/O-anmodninger til storage-enheden i portioner op til 32767KB. Imidlertid vil det være mere effektivt i nogle scenarier at udveksle i mindre portioner. For AccelStor arrays er følgende scenarier relevante:
- Den virtuelle maskine bruger UEFI i stedet for Legacy BIOS
- vSphere Replication anvendes
For sådanne scenarier anbefales det at ændre parameteren Disk.DiskMaxIOSize til 4096.
For iSCSI-forbindelser anbefales det at ændre parameteren Login Timeout til 30 (som standard 5) for at forbedre forbindelsesstabiliteten og deaktivere forsinkelsen af bekræftelser af sendte pakker DelayedAck. Begge muligheder findes i vSphere Client: Host → Configure → Storage → Storage Adapters → Advanced Options for iSCSI adapteren.
Et væsentligt punkt er antallet af anvendte volumes til datastore. Det er klart, at ønsket om at forenkle administrationen kan føre til at oprette én stor volume til hele kapaciteten af arrayet. Men det at have flere volumes, og dermed flere datastores, har en gavnlig effekt på den samlede ydeevne (mere om køerne lidt længere nede). Derfor anbefaler vi at oprette mindst to volumes.
For ikke så længe siden rådgav VMware om at begrænse antallet af virtuelle maskiner på én datastore for igen at opnå den højst mulige ydeevne. Men nu, især med udbredelsen af VDI, er dette problem ikke så presserende. Men det ændrer ikke det gamle princip – at fordele virtuelle maskiner, der kræver intensiv I/O, på forskellige datastores. Der er ikke noget bedre til at bestemme det optimale antal virtuelle maskiner på én volume end at gennemføre inden for din infrastruktur.
Konfiguration af virtuelle maskiner
Der er ingen særlige krav til opsætning af virtuelle maskiner, eller rettere sagt de er ganske almindelige:
- Brug den maksimalt mulige version af VM (kompatibilitet)
- Vær omhyggelig med at angive størrelsen af RAM ved tæt placering af virtuelle maskiner, for eksempel i VDI (da der som standard oprettes en sidefil, der er svarende med RAM-størrelsen ved opstart, hvilket bruger værdifuld kapacitet og påvirker den samlede ydeevne)
- Brug de mest ydeevnedygtige versioner af adapterne til I/O: netværkstype VMXNET 3 og SCSI-type PVSCSI
- Brug typen disk Thick Provision Eager Zeroed for maksimal ydeevne og Thin Provisioning for maksimal effektiv udnyttelse af lagerplads
- Begræns om muligt driften af I/O-uskadelige maskiner ved hjælp af Virtual Disk Limit
- Installer altid VMware Tools
Bemærkninger om køerne
Kø (eller Outstanding I/Os) er antallet af ind-/uddataanmodninger (SCSI-kommandoer), der venter på behandling på et givet tidspunkt for et specifikt device/applikation. I tilfælde af, at køen overbelastes, udstedes fejlmeddelelser om QFULL, hvilket i sidste ende resulterer i en stigning i latenstid. Ved brug af diskbaserede (spindel) lagringssystemer gælder det teoretisk, at jo højere køen er, desto højere er ydeevnen. Dog bør man være varsom, da man let kan ramme QFULL. I tilfælde af All Flash systemer er det på den ene side lidt lettere, da arrayet har latenser, der er ordentlig lavere, og derfor kræves det ofte ikke at justere størrelsen på køerne separat. På den anden side kræver nogle brugs-scenarier (stærk ubalance i IO-kravene for specifikke virtuelle maskiner, test af maksimal ydeevne osv.) om ikke at ændre på køparametrene, så i det mindste forstå, hvilke resultater der kan opnås, og, vigtigst af alt, på hvilke måder.
På selve All Flash arrayet AccelStor er der ingen grænser med hensyn til volumener eller ind-/uddata porte. Om nødvendigt kan selv et enkelt volum få alle ressourcerne fra arrayet. Den eneste begrænsning på køerne findes ved iSCSI targets. Derfor blev der tidligere nævnt et behov for at oprette flere (ideelt op til 8 stk.) targets pr. volum for at overvinde denne grænse. Derudover skal det gentages, at AccelStor arrayene er yderst effektive løsninger. Derfor bør alle interface-porte i systemet anvendes for at opnå maksimal hastighed.
Fra ESXi værtens perspektiv er situationen helt anderledes. Selve værten anvender en praksis, hvor ressourceadgang er ligelig for alle deltagere. Derfor findes der separate IO-køer til gæste-OS og HBA. Køerne til gæste-OS kombineres fra køerne til den virtuelle SCSI-adapter og den virtuelle disk:
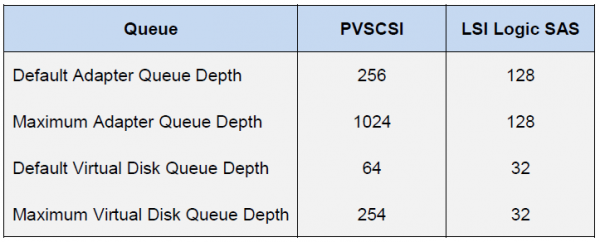
Køen til HBA afhænger af den specifikke type/leverandør:
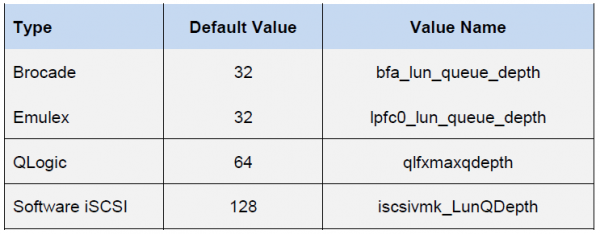
Den endelige ydeevne for den virtuelle maskine vil blive bestemt af den laveste værdi af kødybdegrænsen (Queue Depth limit) blandt hostkomponenterne.
Takket være disse værdier kan vi vurdere de ydeevneindikatorer, som vi kan opnå i en given konfiguration. For eksempel ønsker vi at finde den teoretiske ydeevne for en virtuel maskine (uden henvisning til blokken) med en latency på 0,5 ms. Så vil dens IOPS = (1.000/latency) * Outstanding I/Os (Queue Depth limit)
Eksempler
Eksempel 1
- FC Emulex HBA Adapter
- Én VM på datastore
- VMware Paravirtual SCSI Adapter
Her defineres Queue Depth limit af Emulex HBA. Derfor er IOPS = (1000/0,5)*32 = 64K
Eksempel 2
- VMware iSCSI Software Adapter
- Én VM på datastore
- VMware Paravirtual SCSI Adapter
Her defineres Queue Depth limit allerede af Paravirtual SCSI Adapter. Derfor er IOPS = (1000/0,5)*64 = 128K
Topmodellerne af All Flash arrays fra AccelStor (for eksempel, ) kan levere 700K IOPS til skrivning ved 4K-blokke. Med en sådan blokstørrelse er det helt klart, at én virtuel maskine ikke kan belaste en sådan array. Dette kræver 11 (for eksempel 1) eller 6 (for eksempel 2) virtuelle maskiner.
Resultatet er, at med den rette opsætning af alle de beskrevne komponenter i det virtuelle datacenter kan man opnå ganske imponerende resultater med hensyn til ydeevne.
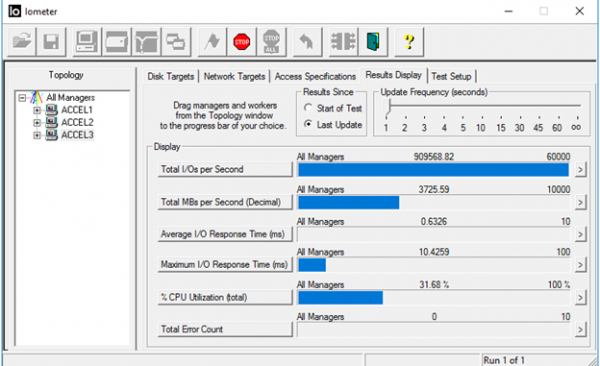
4K Random, 70% Læs/30% Skriv
I virkeligheden er verden meget mere kompleks, end man kan beskrive med en simpel formel. På én vært er der altid mange virtuelle maskiner med forskellige konfigurationer og krav til IO. Og behandlingen af input/output udføres af værtens processor, hvis kapacitet ikke er uendelig. Så for at udnytte det fulde potentiale af den samme i virkeligheden kræves der tre værter. Derudover bidrager applikationer, der kører inde i de virtuelle maskiner, med deres egne korrektioner. Derfor anbefaler vi for præcisions sizing All Flash arrays inde i kundens infrastruktur med reelle nuværende opgaver.
Kilde: habr.com
