

Teknologier til at forbedre ydeevnen, der er baseret på brugen af SSD'er og bredt anvendt i lagringssystemer, blev for længe siden opfundet. Først og fremmest er det brugen af SSD'er som lagringsplads, hvilket er 100% effektivt, men dyrt. Derfor anvendes teknologier som tiering og caching, hvor SSD'er kun bruges til de mest efterspurgte ('varme') data. Tiering er godt til scenarier med langvarig (dage-uger) brug af 'varme' data. Caching, derimod, er til kortvarig (minutter-timer) brug. Begge disse muligheder er implementeret i lagringssystemet. . I denne artikel vil vi gennemgå implementeringen af den anden algoritme – .
Essensen af SSD caching teknologien er at bruge SSD'er som en mellemstation mellem harddiske og controllerens RAM. Ydeevnen af SSD'er er selvfølgelig lavere end ydeevnen af controllerens eget cache, men kapaciteten er til gengæld langt højere. Derfor får vi et kompromis mellem hastighed og volumen.
Indikationer for brug af SSD-cache til læsning:
- Overvægt af læseoperationer frem for skriveoperationer (ofte karakteristisk for databaser og webapplikationer);
- Tilstedeværelsen af en flaskehals i form af harddiskarrayets ydeevne;
- Volumen af efterspurgte data er mindre end volumen af SSD-cache.
Indikationerne for brug af SSD-cache til læsning + skrivning er de samme som årsagerne, bortset fra arten af operationerne - blandet type (f.eks. filserver).
Flertallet af leverandører af lagringssystemer bruger SSD-cache i deres produkter kun til læseoperationer. Den væsentligste forskel fra dem er muligheden for at bruge cachen også til skrivning. For at aktivere funktionaliteten af SSD caching i QSAN-lagringssystemet kræves der køb af en separat licens (leveres elektronisk).
SSD-cache i XCubeSAN er fysisk implementeret som separate SSD-cache puljer. Der kan være op til fire puljer i systemet. Hver pulje bruger naturligvis sit eget sæt af SSD'er. I egenskaberne for den virtuelle disk definerer vi, om den skal bruge cache puljen, og hvilken specifik pulje der skal anvendes. Aktivering og deaktivering af cache-brug for volumener kan ske online uden at stoppe ind-/udgang. SSD'er kan også tilføjes til eller fjernes fra puljen "live". Ved oprettelse af en SSD-cache pulje skal man vælge, hvilken driftsmode den skal fungere i: kun læsning eller læsning + skrivning. Dette afhænger af den fysiske organisation. Da der kan være flere cache puljer, kan de have forskellige funktionaliteter (dvs. systemet kan have cache puljer til både læsning og læsning + skrivning samtidig).
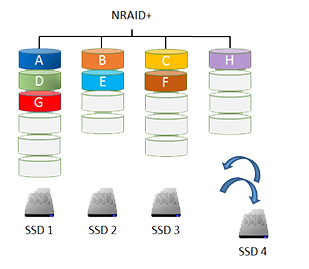
Hvis cache puljen kun bruges til læsning, kan den bestå af 1-8 SSD'er. Drevene behøver ikke nødvendigvis at have samme kapacitet eller være fra samme producent, da de kombineres i NRAID+ strukturen. Alle SSD'er i puljen bruges fælles. Systemet forsøger automatisk at parallelisere de indkommende anmodninger mellem alle SSD'er for at opnå maksimal ydeevne. Hvis en af SSD'erne skulle fejle, vil det ikke være katastrofalt: cachen indeholder kun en kopi af de data, der er gemt på arrayet af harddiske. Det tilgængelige SSD-cache kapacitet vil blot falde (eller blive nul, hvis den oprindelige SSD-cache kun kom fra en enhed).
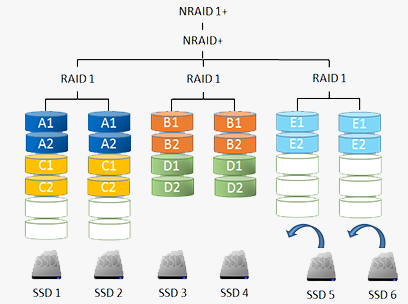
Hvis cachen derimod bruges til læse + skrive operationer, skal antallet af SSD'er i puljen være et lige tal, da indholdet spejles på par af enheder (NRAID 1+ struktur anvendes). Dublikation af cachen er nødvendig, fordi den kan indeholde data, som endnu ikke er blevet skrevet til harddiskene. I dette tilfælde ville et fejl på en SSD i cache puljen føre til tab af information. I NRAID 1+ tilfældet vil nedbrud af en SSD blot føre til, at cachen skifter til "kun læsning" med tilbagelægning af de uregistrerede data til harddisk arrayet. Efter udskiftning af den defekte SSD vil cachen vende tilbage til sin oprindelige driftsmode. For øvrigt kan man for ekstra sikkerhed tildele en dedikeret hot spare til cachen, der arbejder i læse + skrive mode.
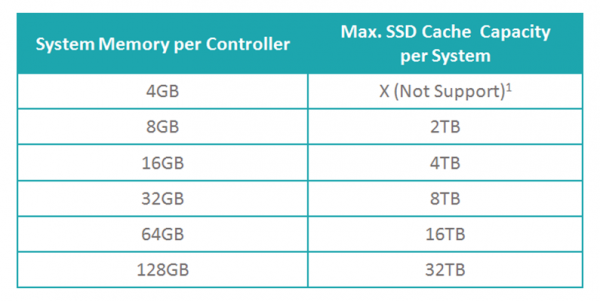
Ved brug af SSD-cachefunktionen i XCubeSAN er der en række krav til rækkefølgen af controllerens hukommelse: Jo mere systemhukommelse, desto større vil cache-poolen være tilgængelig.
I modsætning til de fleste producenter af lagringssystemer, der kun tilbyder mulighed for at aktivere/deaktivere SSD-cachen, giver QSAN større muligheder. Især kan man vælge cache-arbejdsmodus afhængigt af belastningens art. Der er tre foruddefinerede skabeloner, der er tættest på at arbejde i forhold til de tilsvarende tjenester: databasesystem, filsystem, webtjeneste. Derudover kan administratoren oprette sin egen profil ved at indtaste de ønskede parameterindstillinger:
- Block størrelse (Cache Block Size) – 1/2/4 MB
- Antallet af læseanmodninger for blokken, så den kopieres til cachen (Populate-on-Read Threshold) – 1..4
- Antallet af skriveanmodninger for blokken, så den kopieres til cachen (Populate-on-Write Threshold) – 0..4
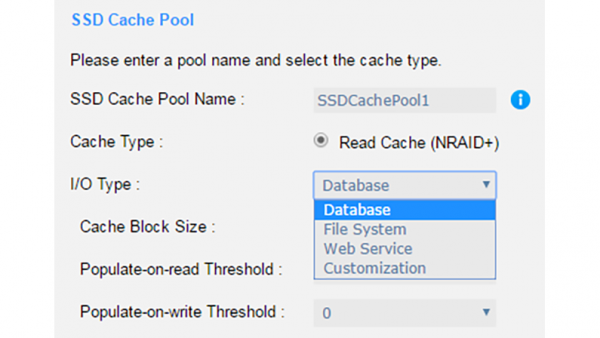
Profiler kan ændres 'on-the-fly', men naturligvis med rydning af cacheindholdet og opvarmning af den igen.
Når man ser på SSD-cache-princippet, kan man fremhæve de vigtigste operationer, når man arbejder med den:
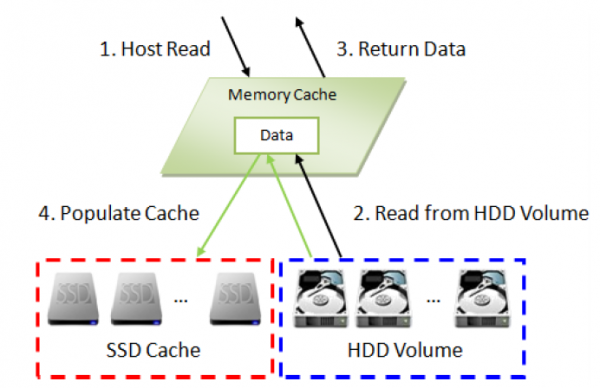
Læsning af data, når de ikke er i cachen
- Anmodning fra værten går til controllere;
- Da de anmodede data ikke er i SSD-cachen, læses de fra hårde diske;
- De læste data sendes til værten. Samtidig tjekkes det, om disse blokke er 'varme';
- Hvis ja, kopieres de til SSD-cachen til fremtidig brug.
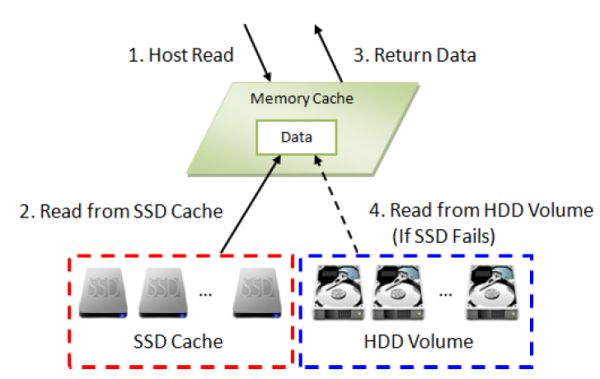
Læsning af data, når de er til stede i cachen
- Anmodning fra værten går til controllere;
- Da de anmodede data er i SSD-cachen, læses de derfra;
- De læste data sendes til værten.
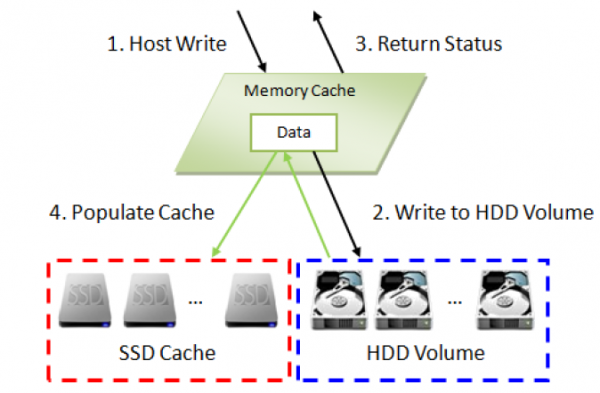
Skrivning af data ved brug af cache til læsning
- Anmodning om skrivning fra værten går til controllere;
- Dataene skrives til hårde diske;
- Værten modtager en bekræftelse på, at skrivningen er vellykket;
- Samtidig kontrolleres det, om blokken er 'varm' (sammenlignes med parameteren Populate-on-Write Threshold). Hvis ja, kopieres den til SSD-cachen til efterfølgende brug.
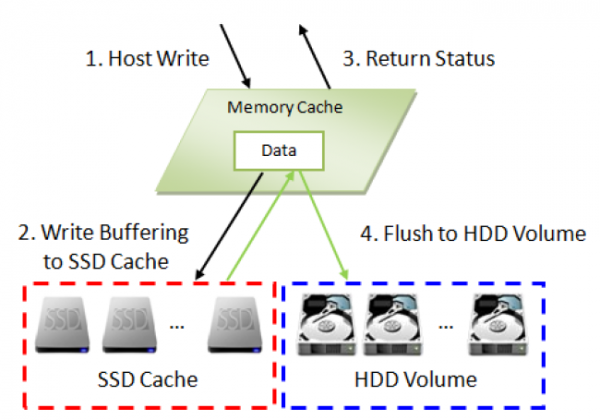
Skrivning af data ved brug af cache til læsning + skrivning
- Anmodning om skrivning fra værten går til controllere;
- Dataene skrives til SSD-cachen;
- Værten modtager en bekræftelse på, at skrivningen er vellykket;
- Data from the SSD cache is written to hard drives in the background;
Case check
Testbænk
2 servers (CPU: 2 x Xeon E5-2620v3 2.4Hz / RAM: 32GB) connected by two ports via Fibre Channel 16G directly to the XCubeSAN XS5224D storage system (16GB RAM/controller).
16 x Seagate Constellation ES, ST500NM0001, 500GB, SAS 6Gb/s were used combined in RAID5 (15+1) for the data array and 8 x HGST Ultrastar SSD800MH.B, HUSMH8010BSS200, 100GB, SAS 12Gb/s as cache.
2 volumes were created: one for each server.
Test 1. SSD cache read-only with 1-8 SSDs
SSD Cache
- I/O Type: Customization
- Cache Block Size: 4MB
- Populate-on-read Threshold: 1
- Populate-on-write Threshold: 0
I/O Pattern
- Tool: IOmeter V1.1.0
- Workers: 1
- Outstanding (Queue Depth): 128
- Access Specifications: 4KB, 100% Read, 100% Random
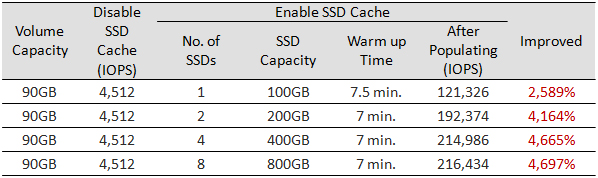
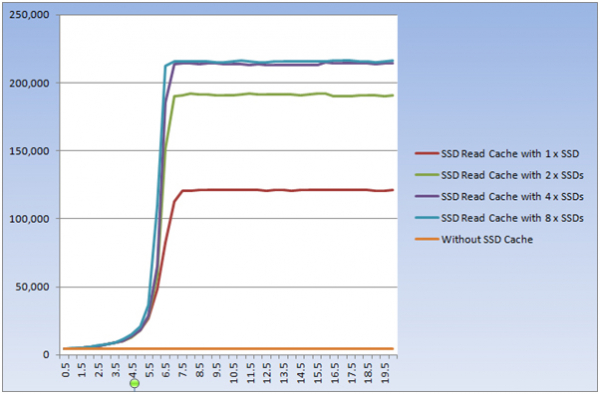
In theory, the more SSDs in the cache pool, the higher the performance. This was confirmed in practice. However, a significant increase in the number of SSDs with a small number of volumes does not lead to explosive effects.
Test 2. SSD cache in read + write mode with 2-8 SSDs
SSD Cache
- I/O Type: Customization
- Cache Block Size: 4MB
- Populate-on-read Threshold: 1
- Populate-on-write Threshold: 1
I/O Pattern
- Tool: IOmeter V1.1.0
- Workers: 1
- Outstanding (Queue Depth): 128
- Access Specifications: 4KB, 100% Write, 100% Random
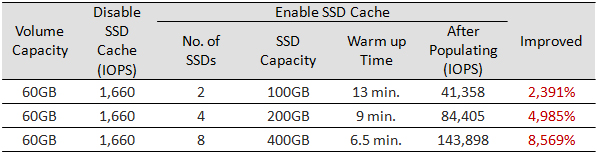
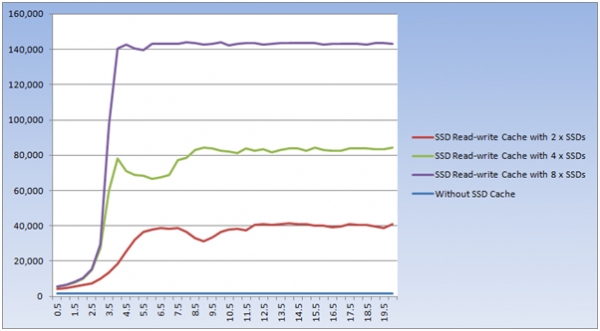
The same result: explosive performance growth and scaling with an increase in the number of SSDs.
In both tests, the amount of working data was less than the total cache size. Therefore, over time, all blocks were copied to the cache. Essentially, the work was carried out with the SSDs, practically not touching the hard drives. The goal of these tests was to clearly demonstrate the efficiency of cache warming and scaling its performance depending on the number of SSDs.
Now let’s come back down to earth and check a more realistic situation, where the data volume exceeds the cache size. To ensure the test is completed in a reasonable time (the 'warming' period of the cache significantly increases with the volume size), we will limit the volume size to 120GB.
Test 3. Database operation emulation
SSD Cache
- I/O Type: Database
- Cache Block Size: 1MB
- Populate-on-read Threshold: 2
- Populate-on-write Threshold: 1
I/O Pattern
- Tool: IOmeter V1.1.0
- Workers: 1
- Outstanding (Queue Depth): 128
- Access Specifications: 8KB, 67% Read, 100% Random
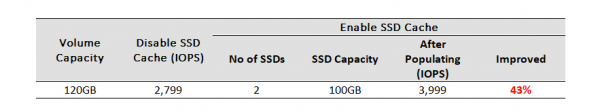
Dom
An obvious conclusion is that using SSD cache is quite effective for enhancing the performance of any storage system. Denne erklæring gælder i høj grad: SSD-cache-funktionen er fremragende implementeret. Dette gælder for støtte til læse- og læse + skrive-tilstande, fleksible indstillinger til arbejde for alle brugsscenarier samt det samlede systemets præstation. Derfor kan man for en meget rimelig pris (licensprisen svarer til prisen på 1-2 SSD'er) markant forbedre den samlede ydeevne.
Kilde: habr.com
