

Hej alle sammen, vi deler nu den anden del af publikationen „Virtuelle filsystemer i Linux: hvorfor de er nødvendige, og hvordan de fungerer?“ Den første del kan læses . Vi minder om, at denne serie af publikationer er knyttet til lanceringen af et nyt hold for kurset , som snart starter.
Hvordan man overvåger VFS med eBPF og bcc værktøjer
Den nemmeste måde at forstå, hvordan kernen arbejder med filer sysfs – er at observere dette i praksis, og den nemmeste måde at overvåge ARM64 på er at bruge eBPF. eBPF (forkortelse for Berkeley Packet Filter) består af en virtuel maskine, der kører i , som privilegerede brugere kan anmode om (query) fra kommandolinjen. Kildeteksterne i kernen fortæller læseren, hvad kernen kan gøre; at køre eBPF værktøjer i et belastet system viser, hvad kernen faktisk gør.
Heldigvis er det ret nemt at begynde at bruge eBPF med værktøjer, der er tilgængelige som pakker fra den generelle distribution og grundigt dokumenteret . Værktøjer bcc – er scripts i Python med små kodeindsatser i C, hvilket betyder, at enhver, der er fortrolig med begge sprog, nemt kan modificere dem. I bcc/tools er der 80 Python scripts, så det er sandsynligt, at udvikleren eller systemadministratoren kan finde noget passende til deres opgave.
For at få en overfladisk forståelse af, hvilken opgave VFS udfører i et kørende system, kan du prøve vfscount eller vfsstat. Det viser for eksempel, at dusinvis af kald vfs_open() og "dets venner" sker bogstaveligt talt hver sekund.
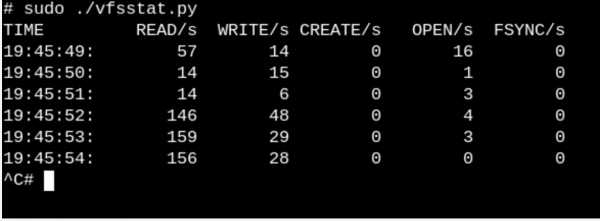
vfsstat.pyer et Python-script med C-kodeindsatser, der simpelthen tæller VFS-funktionskald.
Lad os give et mere banalt eksempel og se, hvad der sker, når vi indsætter et USB-flashdrev i computeren, og systemet opdager det.
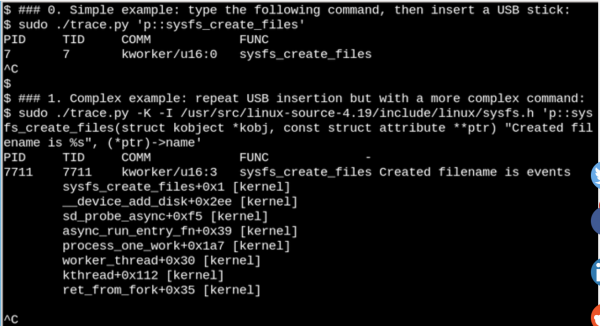
Med eBPF kan vi se, hvad der sker i
/sys, når et USB-flashdrev indsættes. Her vises et simpelt og komplekst eksempel.
I eksemplet vist ovenfor bcc værktøjet udskriver en meddelelse, når kommandoen sysfs_create_files()køres. Vi ser, at sysfs_create_files() blev kørt ved hjælp af kworker strømmen i respons på det, at USB-stikket blev indsat, men hvilken fil blev oprettet? Det andet eksempel viser hele styrken af eBPF. Her trace.py udskriver en kerne-backtrace (kernel backtrace) (indstillingen -K) og navnet på den fil, der blev oprettet. sysfs_create_files()Indsættelse i enkle udsagn er kode i C, der inkluderer en let genkendelig formatstreng, der leveres af et Python-script, som kører LLVM. just-in-time kompilator. Denne streng kompilere og udfører den i en virtuel maskine inde i kernen. Den fulde funktionssignatur sysfs_create_files () skal gengives i den anden kommando, så formatstrengen kan referere til en af parametrene. Fejl i dette C-kodefragment fører til genkendelige fejl fra C-kompilatoren. For eksempel, hvis parameteren -l udelades, vil du se «Failed to compile BPF text.» Udviklere, der er fortrolige med C og Python, vil finde værktøjerne bcc lette at udvide og ændre.
Når USB-drevet sættes ind, vil kerne-backtrace vise, at PID 7711 er den proces kworker, der oprettede filen «events» i sysfs. Tilsvarende vil et kald til sysfs_remove_files() vise, at fjernelsen af drevet førte til slettelsen af filen events, hvilket svarer til det overordnede koncept med referenceoptælling. I denne forbindelse vil visning af sysfs_create_link () med eBPF under indsættelse af USB-drevet vise, at der er oprettet mindst 48 symbolske links.
Hvad er så formålet med filen events? Brug til at søge efter , viser, at den kalder disk_add_events (), og enten "media_change", eller "eject_request" kan blive skrevet til begivenhedens fil. Her informerer kerne-lagsystemet userspace om tilstedeværelsen og fjernelsen af disk. Bemærk, hvor informativ denne undersøgelsesmetode er med hensyn til indsættelse af USB-drevet sammenlignet med at forsøge at finde ud af, hvordan alt fungerer, udelukkende fra kildeteksten.
Rodfiltrene, der kun er til læsning, muliggør indbyggede enheder.
Selvfølgelig slukker ingen serveren eller deres computer ved at trække stikket ud af stikkontakten. Men hvorfor? Det er fordi, at monterede filsystemer på fysiske lagringsenheder kan have forsinkede optegnelser, og datastrukturen, der registrerer deres tilstand, muligvis ikke synkroniseres med optegnelserne i lagringen. Når dette sker, må systemejere vente på den næste boot for at køre fsck filesystem-recovery og i værste fald miste data.
Men vi ved alle, at mange IoT-enheder, samt routere, termostater og biler nu kører på Linux. Mange af disse enheder har stort set ikke nogen brugergrænseflade, og der er ingen måde at slukke for dem 'rent'. Forestil dig at starte en bil med et fladt batteri, når strømmen til kontrolenheden konstant svinger op og ned. Hvordan er det muligt, at systemet starter uden en lang fsck, når motoren endelig begynder at køre? Svaret er enkelt. Indbyggede enheder er afhængige af det rodfæstede filsystem (forkortet ro-rootfs (read-only root filesystem).
ro-rootfs tilbyder mange fordele, der er mindre åbenlyse end uforfalsket. En fordel er, at malware ikke kan skrive til /usr eller /lib, hvis ingen Linux-processer kan skrive dertil. En anden fordel er, at i høj grad uforanderligt filsystem er afgørende for feltsupport af fjerndrevne enheder, da supportpersonalet bruger lokale systemer, der nominelt er identiske med systemerne på stedet. Måske den vigtigste (men også mest snedige) fordel er, at ro-rootfs tvinger udviklere til at beslutte, hvilke systemobjekter der skal være uforanderlige, allerede på designstadiet. Arbejde med ro-rootfs kan være besværligt og smertefuldt, som det ofte er med konstante variabler i programmeringssprog, men deres fordele opvejer let de ekstra omkostninger.
Oprettelse rootfs i skrivebeskyttet tilstand kræver nogle ekstra bestræbelser fra udviklerne af indlejrede systemer, og det er netop her, VFS kommer ind i billedet. Linux kræver, at filer i /var skal være tilgængelige til skrivning, og desuden vil mange populære applikationer, der kører indbyggede systemer, forsøge at oprette konfigurations- dot-filer i $HOME. En af løsningerne for konfigurationsfiler i hjemmemappen er normalt deres forudgenerering og samling i rootfs. For /var en af de mulige tilgange er at montere den i en separat partition, der er tilgængelig for skrivning, mens selve / monteres kun kun-læsning. En anden populær alternativ er brugen af bind- eller overlay mounts.
Bind- og overlay mounts, brugen af dem i containere
Udførelse af kommandoen man mount er den bedste måde at lære om bind- og overlay mounts, som giver udviklere og systemadministratorer mulighed for at opbygge et filsystem på én sti og derefter give det til applikationer på en anden. For indlejrede systemer betyder dette muligheden for at gemme filer i /var på et skrivebeskyttet USB-drev, men overlay- eller bind-mounting af stien fra tmpfs i /var ved opstart vil tillade applikationer at skrive til det. Ved næste opstart vil ændringerne i /var være tabt. Overlay mounting skaber en fusion mellem tmpfs og det underliggende filsystem og tillader tilsyneladende ændringer af eksisterende filer i ro-tootf mens bind mounting kan gøre nye tomme tmpfs mapper synlige som skrivebare i ro-rootfs stier. Mens overlayfs er den korrekte (correct) type filsystem, er bind mounting implementeret i .
Baseret på beskrivelsen af overlay og bind mounting er det ingen overraskelse, at aktivt bruger dem. Lad os se, hvad der sker, når vi bruger til at starte en container ved hjælp af værktøjet mountsnoop fra bcc.
Kald system-nspawn starter containeren under kørslen mountsnoop.py.
Lad os se, hvad vi har fået:
Kørsel mountsnoop under ‘opstarten’ af containeren viser, at containerens køremiljø i høj grad afhænger af bind-mounting (Kun starten af en lang output vises).
Her systemd-nspawn giver udvalgte filer fra . Funktioner og sysfs værten til containeren som stier i dens rootfs. Udover MS_BIND flaget, der indstiller bind mounting, bestemmer nogle andre flag i det monterede system forholdet mellem ændringerne i værtsnavnerummet og containeren. For eksempel kan bind mounting enten tillade ændringer i /proc og /sys i containeren eller skjule dem afhængigt af kaldet.
Konklusion
At forstå den indre struktur af Linux kan virke som en uoverkommelig opgave, da selve kernen indeholder en enorm mængde kode, uden at tage højde for brugerrummets applikationer og systemopkaldsintrfaces i bibliotekerne på C, som glibc. En af måderne at gøre fremskridt på er at læse kildekoden til en del af kernen med fokus på at forstå systemopkald og overskrifter, der henvender sig til brugerrummet, samt de grundlæggende interne grænseflader i kernen, for eksempel tabellen file_operations. Filoperationer sikrer principperne bag "alt er en fil", så håndtering af dem er særlig tilfredsstillende. Kildefilerne til kernen på C i den øverste mappe fs/ repræsenterer implementeringen af virtuelle filsystemer, som er et lag af skaller, der giver bred og relativt nem kompatibilitet med populære filsystemer og lagringsenheder. Montering med binding og overlay gennem Linux-navneområder er magien ved VFS, som gør det muligt at skabe containere og rodfilsystemer, der kun er skrivebeskyttede. I kombination med studiet af kildekoden, kernens eBPF-værktøj og dets grænseflade bcc
gør det nemmere at forske i kernen end nogensinde før.
Venner, skriv venligst, var denne artikel nyttig for dig? Måske har du nogle kommentarer eller bemærkninger? Og for dem, der er interesserede i kurset ”Linux Administrator”, inviterer vi til , som finder sted den 18. april.
Kilde: habr.com
