

Emnet for fejltolerance i datalagringssystemer er altid aktuelt, da en fejltolerance i vores tids virtuelle og konsoliderede ressourcer vil være det led, hvis svigt ikke blot vil resultere i en almindelig nedbrud, men også i langvarige driftsstop. Derfor har moderne datalagringssystemer et væld af duplicerede komponenter (helt ned til kontrollerne). Men er sådan beskyttelse tilstrækkelig?
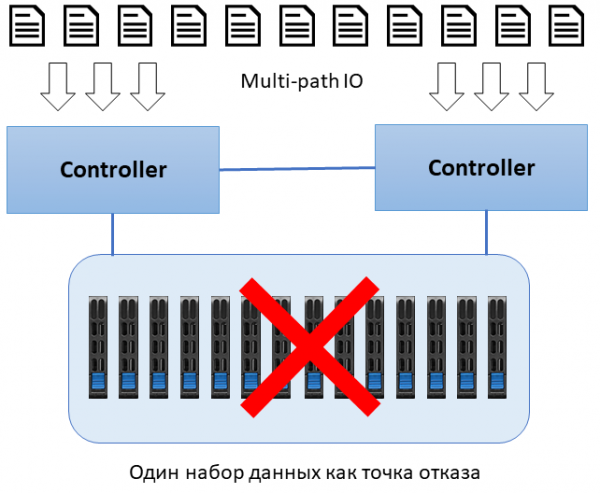
Alle leverandører nævner altid den høje fejltolerance i deres datalagringssystemer, når de oplister deres specifikationer, og tilføjer uundgåeligt termen "uden enkelt fejlpunkter". Lad os tage et nærmere kig på et typisk datalagringssystem. For at undgå driftsstop i forbindelse med vedligeholdelse, bliver komponenterne i datalagringssystemerne duplikeret; dette inkluderer strømforsyninger, kølemoduler, ind-/udgangsporte, lagringsenheder (i form af RAID) og selvfølgelig kontrollerne. Hvis man ser nøje på denne arkitektur, kan man bemærke mindst to potentielle fejlpunkter, som der ikke tales om:
- Tilstedeværelsen af en enkelt backplane
- Tilstedeværelsen af en enkelt kopi af data
Backplane er en teknisk kompleks enhed, som altid gennemgår grundig testning under produktionen. Derfor er det sjældent, at der opstår tilfælde, hvor den helt svigter. Men selv i tilfælde af delvise fejl, som for eksempel en defekt slot til lagringsenheder, vil det være nødvendigt at udskifte den med en fuldstændig nedlukning af datalagringssystemet.
At oprette flere kopier af data synes ikke umiddelbart at være et problem. For eksempel er Clone-funktionen i datalagringssystemer, som gør det muligt at opdatere en fuld kopi af data med jævne mellemrum, ret udbredt. Men i tilfælde af problemer med den samme backplane vil kopien være ligeså utilgængelig som originalen.
En åbenlys løsning på at overvinde disse mangler er at replikere til et andet lagersystem. Hvis man ser bort fra den forventede fordobling af omkostningerne til "hardware" (vi antager trods alt, at dem, der vælger denne løsning, tænker rationelt og allerede accepterer dette faktum), vil der stadig være yderligere omkostninger til at organisere replikationen i form af licenser, ekstra software og hardware. Og vigtigst af alt - der skal på en eller anden måde sikres konsistens i de replikeringerede data. Det vil sige, at der skal bygges en virtualizer til lagersystemet/vSAN osv., hvilket også kræver økonomiske og tidsmæssige ressourcer.
Ved oprettelsen af deres high availability-systemer var målet at komme af med de ovennævnte mangler. Så blev der udviklet en fortolkning af teknologien Shared Nothing, som frit oversat betyder "uden brug af delte enheder".
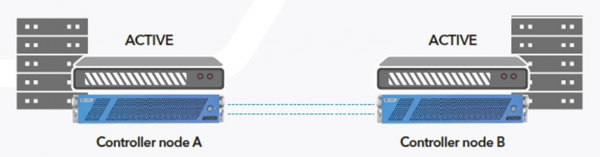
Koncept arkitekturen indebærer brugen af to uafhængige noder (controllere), hvor hver har sit eget datakompendium. Der udføres synkron replikation mellem noderne via en InfiniBand 56G-grænseflade, helt gennemsigtigt for den software, der kører over lagersystemet. Som et resultat kræves der ikke anvendelse af virtualizere, softwareagenter osv.
Det fysiske zvidis med to noder fra AccelStor kan udføres i to modeller:
- — baseret på Twin-servere i et 2U kabinet, hvis moderat ydeevne og kapacitet på op til 22 TB er nødvendigt;
- — baseret på separate 2U-servere, hvis høj ydeevne og stor kapacitet (op til 57 TB) er nødvendig.
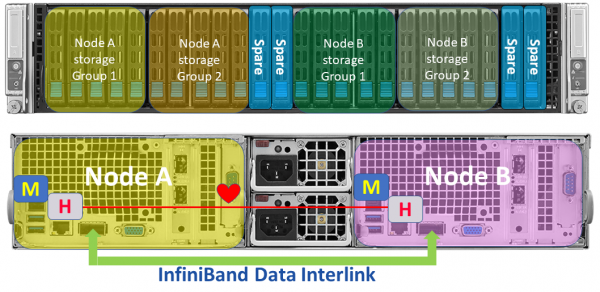
H510-modellen baseret på Twin-serveren
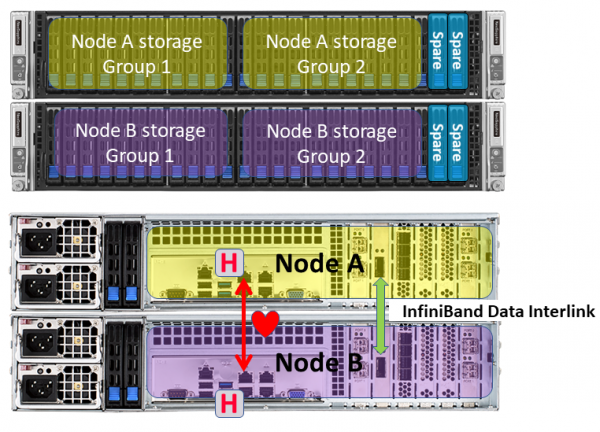
H710-modellen baseret på separate servere
Brugen af forskellige formfaktorer skyldes behovet for et varierende antal SSD'er for at nå det ønskede volum og ydeevne. Desuden er Twin-platformen billigere og muliggør mere prisvenlige løsninger, selvom der er en vis betinget "mangel" i form af en enkelt backplane. Alt andet, herunder driftsprincipperne, er i begge modeller fuldstændig identisk.
Datasættet i hver node har to grupper , plus 2 hot spare. Hver gruppe er i stand til at modstå nedbruddet af en SSD. Alle indkommende skriveanmodninger styres af noden i overensstemmelse med FlexiRemap omformer til sekventielle kæder med 4KB blokke, som derefter skrives til SSD i den mest optimale tilstand (sekventiel skrivning). Bekræftelse af skrivning til vært gives først efter den fysiske placering af dataene på SSD, dvs. uden caching i RAM. Dette opnår en imponerende ydeevne på op til 600K IOPS til skrivning og 1M+ IOPS til læsning (model H710).
Som tidligere nævnt foregår synkronisering af datasæt i realtid via InfiniBand 56G-grænsefladen, som har høj båndbredde og lav latenstid. For at maksimere effektiviteten af kommunikationskanalen ved overførsel af små pakker. Da der kun er én kommunikationskanal, anvendes et dedikeret 1GbE-link til yderligere pulscheck. Gennem dette link sendes kun heartbeat, så der stilles ikke krav til hastighedsparametre.
I tilfælde af at systemets kapacitet øges (op til 400+ TB) ved hjælp af de tilsluttes også parvis for at overholde konceptet "uden enkelt fejlsituation".
Til ekstra databeskyttelse (udover at AccelStor allerede har to kopier) anvendes en særlig algoritme, der træder i kraft ved fejl i en SSD. Hvis en SSD fejler, begynder noden at genopbygge data på en af hot spare-enhederne. Gruppen FlexiRemap, som er i degraded tilstand, skifter til read only-tilstand. Dette gøres for at undgå interferens mellem skrivnings- og genopbygningsoperationer på den reserverede disk, hvilket i sidste ende fremskynder genopbygningsprocessen og forkorter den tid, hvor systemet potentielt er sårbart. Når genopbygningen er afsluttet, vender noden tilbage til normal read-write-tilstand.
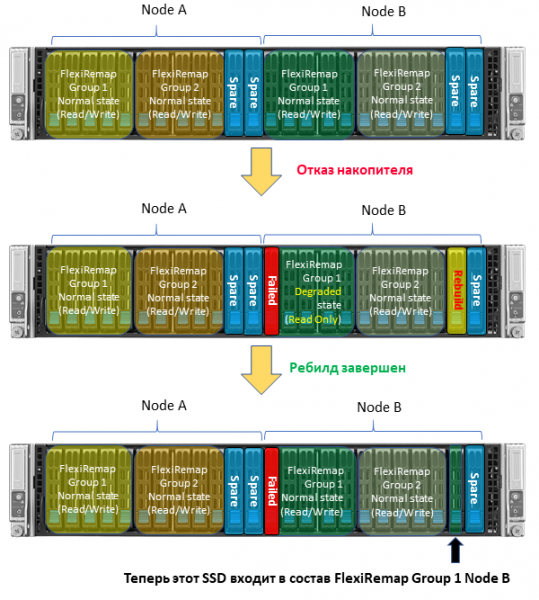
Selvfølgelig, som med andre systemer, falder den samlede ydeevne under genopbygning (da en af grupperne FlexiRemap ikke er aktiv til skrivning). Men selve genopbygningsprocessen sker rekordhurtigt, hvilket adskiller AccelStor-systemer fra løsninger fra andre leverandører.
En anden nyttig funktion ved Nothing Shared-teknologien i arkitekturen er, at noderne arbejder i den såkaldte true active-active-tilstand. I modsætning til "klassisk" arkitektur, hvor en specifik volumen/pool kun ejes af én controller, mens den anden blot udfører I/O-operationer, er der i systemerne Hver node arbejder med sit eget datasæt og overfører ikke anmodninger til "naboen". Dette øger systemets samlede ydeevne ved at tillade parallel behandling af input/output-anmodninger af noderne og adgang til lagerenheder. Der findes faktisk ikke noget koncept som failover, da det ikke er nødvendigt at overføre kontrollen af volumener til en anden node i tilfælde af fejl.
Sammenlignet med teknologien Nothing Shared i arkitekturen, vil den ved første øjekast have en anelse mindre fleksibilitet i forhold til fuld duplikation af lagringssystemer. Dette gælder især for oprettelse af kommunikationslinjer mellem lagringssystemerne. I H710-modellen kan noderne placeres op til 100 meter væk ved hjælp af de ikke helt billige aktive optiske kabler InfiniBand. Men selv sammenlignet med almindelig synkron replikation fra andre leverandører via tilgængelig Fibre Channel over større afstande vil løsningen fra AccelStor være billigere og lettere at installere/vedligeholde, da det ikke er nødvendigt at installere virtualiseringslagringssystemer og/eller integrere med software (hvilket ikke altid er muligt i princippet). Desuden skal vi huske, at AccelStor-løsningerne er All Flash-array med ydeevne, der overstiger de "klassiske" lagringssystemer med SSD-only.
Ved brug af teknologien Nothing Shared kan arkitekturen fra AccelStor opnå en tilgængelighed for lagringssystemet på niveauet 99.9999% til en ganske rimelig pris. Sammen med den høje pålidelighed af løsningen, blandt andet takket være brugen af to kopier af data, og den imponerende ydeevne takket være proprietære algoritmer , løsninger fra er fremragende kandidater til nøglepositioner i opbygningen af moderne datacentre.
Kilde: habr.com
