

Et ikke ubetydeligt antal enterprise-applikationer og virtualiseringssystemer har deres egne mekanismer til opbygning af failover-løsninger. Specifikt er Oracle RAC (Oracle Real Application Cluster) et cluster af to eller flere Oracle-databaseservere, der arbejder sammen for at balancere belastningen og sikre failover på server-/applikationsniveau. For at arbejde i denne tilstand er et fælles lager nødvendigt, som normalt udgøres af et SAN.
Som vi allerede har diskuteret i en af vores , har selve SAN'en, på trods af tilstedeværelsen af redundante komponenter (herunder controllere), stadig fejlpunkter – primært i form af et enkelt datasæt. Derfor, for at opbygge en Oracle-løsning med høje pålidelighedskrav, skal skemaet "N servere - ét SAN" kompliceres.
Først og fremmest skal vi selvfølgelig finde ud af, hvilke risici vi forsøger at forsikre os imod. I denne artikel vil vi ikke overveje beskyttelse mod trusler som "meteoritten der ramte". Så opbygning af en geografisk spredt disaster recovery-løsning forbliver et emne for en af de kommende artikler. Her vil vi se på det såkaldte Cross-Rack disaster recovery-løsning, når beskyttelsen opbygges på serverrackniveau. Racksene kan være i samme rum eller forskellige, men typisk inden for én bygning.
Disse racks skal indeholde alle nødvendige udstyr og software, der muliggør drift af Oracle-databaser uafhængigt af tilstanden hos "naboen". Med andre ord, ved at bruge Cross-Rack disaster recovery-løsningen udelukker vi risici ved fejl:
- Oracle-applikationsservere
- Lagringssystemer
- Switche
- Total nedbrud af alt udstyr i racken:
- Strømsvigt
- Kølesystemfejl
- Eksterne faktorer (mennesker, natur osv.)
Redundans af Oracle-servere indebærer selve princippet for Oracle RAC og implementeres via applikationen. Redundans af switching-midler er heller ikke et problem. Men det er ikke så enkelt med redundansen af lagringssystemet.
Den enkleste mulighed er at replikere data fra det primære lagringssystem til det sekundære. Synchronous eller asynchronous, afhængigt af lagringssystemets muligheder. Ved asynkron replikation opstår straks spørgsmålet om sikringen af datakonsistens i forhold til Oracle. Men selvom der er en softwareintegration med applikationen, vil der alligevel være behov for administratorers manuelle indgreb for at skifte klyngen til det sekundære lager ved nedbrud på det primære lagringssystem.
En mere kompleks mulighed er software- og/eller hardware 'virtualizere' af lagringssystemet, som fjerner problemer med konsistens og manuel indgriben. Men kompleksiteten ved implementering og efterfølgende administration, samt den ganske urimelige pris for disse løsninger skræmmer mange væk.
Netop til sådanne scenarier, som Cross-Rack disaster recovery, passer AccelStor NeoSapphire™-løsningen perfekt. med anvendelse af Shared-Nothing-arkitektur. Denne model repræsenterer et to-node lagringssystem, der bruger sin egen teknologi FlexiRemap® til at arbejde med flash-lagringsenheder. Takket være NeoSapphire™ H710 kan opnå ydeevne på op til 600K IOPS@4K random write og 1M+ IOPS@4K random read, hvilket er uopnåeligt ved brug af klassiske RAID-baserede lagringssystemer.
Men den vigtigste egenskab ved NeoSapphire™ H710 er udførelsen af de to noder i form af separate kabinetter, hvor hver har sin egen kopi af dataene. Synkroniseringen af noderne sker via et eksternt InfiniBand-interface. Takket være denne arkitektur kan noderne placeres på forskellige lokationer op til 100 meter væk, hvilket muliggør Cross-Rack disaster recovery. Begge noder arbejder fuldt synkront. For værtsmaskinerne ser H710 ud som et almindeligt to-controller lagringssystem. Derfor er der ikke behov for ekstra software- og hardwaremuligheder eller særlig komplekse indstillinger.
Sammenlignes de ovenfor beskrevne løsninger for Cross-Rack disaster recovery, fremhæver AccelStor-løsningen sig tydeligt blandt de øvrige:
AccelStor NeoSapphire™ Shared Nothing Architecture
Software- eller hardware 'virtualizer' af lagringssystemet
Løsning baseret på replikation
Tilgængelighed
Servernedbrud
Ingen nedetid
Ingen nedetid
Ingen nedetid
Switch-nedbrud
Ingen nedetid
Ingen nedetid
Ingen nedetid
Lagringssystem-nedbrud
Ingen nedetid
Ingen nedetid
Nedetid
Hele rack-nedbrud
Ingen nedetid
Ingen nedetid
Nedetid
Omkostninger og kompleksitet
Pris for løsningen
Lav*
Høj
Høj
Implementeringskompleksitet
Lav
Høj
Høj
*AccelStor NeoSapphire™ er stadig en All Flash-lagringsløsning, som per definition ikke er «gratis», især når man har dobbelt kapacitet. Men sammenlignet med den samlede omkostning for en løsning baseret på den med lignende fra andre leverandører, kan prisen betragtes som lav.
Topologien for tilslutning af applikationsservere og All Flash-lagringsnoder vil se således ud:
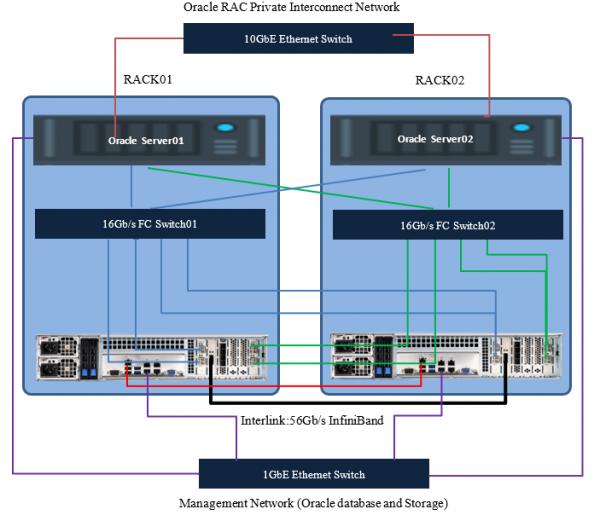
Når man planlægger topologien, er det også yderst anbefalet at duplikere styrings- og interconnect-switchene for serverne.
Her og fremover vil der blive talt om tilslutning via Fibre Channel. I tilfælde af brug af iSCSI vil det være det samme, med forbehold for de anvendte typer switches og lidt forskellige indstillinger for lagermediet.
Forberedende arbejde på lagermediet
Brugt udstyr og software
Specifikationer for servere og switches
Komponenter
Description
Oracle Database 11g servere
To
Serveroperativsystem
Oracle Linux
Oracle databaseversion
11g (RAC)
Processorer pr. server
To 16 cores Intel® Xeon® CPU E5-2667 v2 @ 3.30GHz
Fysisk hukommelse pr. server
128GB
FC-netværk
16Gb/s FC med multipathing
FC HBA
Emulex Lpe-16002B
Dedikerede offentlige 1GbE-porte til klyngeadministration
Intel ethernetadapter RJ45
16Gb/s FC-switch
Brocade 6505
Dedikerede private 10GbE-porte til datasynkronisering
Intel X520
Specifikation for AccelStor NeoSapphire™ All Flash-lagringsløsning
Komponenter
Description
Lagringssystem
NeoSapphire™ høj tilgængelighedsmodel: H710
Billedversion
4.0.1
Samlet antal drev
48
Drevstørrelse
1.92TB
Drevtype
SSD
FC målporte
16 x 16Gb porte (8 pr. node)
Administrationsporte
Den 1GbE ethernetkabel, der forbinder til værter via en ethernet switch
Heartbeat port
Den 1GbE ethernetkabel, der forbinder mellem to lagernoder
Datasynkroniseringsport
56Gb/s InfiniBand-kabel
Før lagermediet tages i brug, skal det initialiseres. Som standard er lederadressen for begge noder den samme (192.168.1.1). Du skal skiftevis oprette forbindelse til dem og angive nye (allerede forskellige) lederadresser og konfigurere tidsynkronisering, hvorefter administrationsportene kan tilsluttes et samlet netværk. Derefter bliver noderne samlet i en HA-par ved at tildele subnet til Interlink-forbindelser.
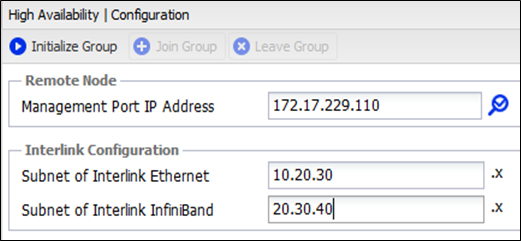
Når initialiseringen er afsluttet, kan lagermediet administreres fra enhver node.
Dernæst opretter vi de nødvendige volumener og offentliggør dem for applikationsservere.
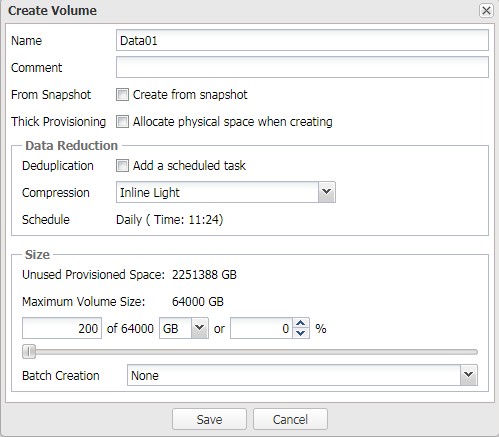
Det anbefales stærkt at oprette flere volumener til Oracle ASM, da dette vil øge antallet af targets for serverne, hvilket i sidste ende forbedrer den samlede ydeevne (mere om køer et andet sted) ).
Testkonfiguration
Lagringsvolumen navn
Volumenstørrelse
Data01
200GB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Nogle forklaringer om driftsmodi for arrayet og de processer, der opstår ved nødsituationer.
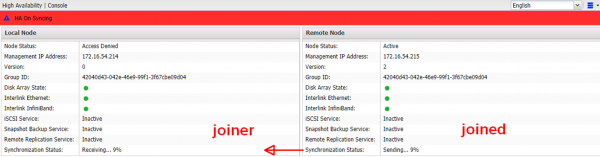
Hver nodes datasæt har en parameter "versionsnummer". Efter den første initialisering er det ens og lig med 1. Hvis versionsnummeret af en eller anden grund er forskelligt, vil data altid blive synkroniseret fra den ældre version til den yngre, hvorefter nummeret for den yngre version justeres, hvilket betyder, at kopierne er identiske. Årsagerne til, at versioner kan være forskellige, er:
- Planlagt genstart af en af noderne.
- Fejl på en af noderne på grund af pludselig strømafbrydelse (strøm, overophedning osv.).
- Afbrudt InfiniBand-forbindelse med umulighed for synkronisering.
- Fejl på en af noderne på grund af datakorruption. Her vil der være behov for at oprette en ny HA-gruppe og fuld synkronisering af datasættet.
Under alle omstændigheder øger noden, der forbliver online, sit versionsnummer med én, så den kan synkronisere sit datasæt med parret efter genoprettelse af forbindelsen.
Hvis der opstår afbrydelse på Ethernet-linket, skifter Heartbeat midlertidigt til InfiniBand og vender tilbage inden for 10 sekunder, når forbindelsen er genoprettet.
Host-konfigurationer
For at sikre fejltolerance og øge ydeevnen skal MPIO-support aktiveres for arrayet. Dette kræver, at du tilføjer nogle linjer i filen /etc/multipath.conf og derefter genstarter multipath-tjenesten.
Skjult tekstdevices {
device {
vendor "AStor"
path_grouping_policy "group_by_prio"
path_selector "queue-length 0"
path_checker "tur"
features "0"
hardware_handler "0"
prio "const"
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
Derudover, for at ASM fungerer med MPIO via ASMLib, skal du ændre filen /etc/sysconfig/oracleasm og derefter køre /etc/init.d/oracleasm scandisks.
Skjult tekst
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER="dm"
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE="sd"
Bemærk
Hvis du ikke ønsker at bruge ASMLib, kan du bruge UDEV-regler, som danner grundlaget for ASMLib.
Fra version 12.1.0.2 er Oracle Database muligheden tilgængelig til installation som en del af ASMFD-softwaren.
Det er vigtigt at sikre, at de opdelt diske til Oracle ASM er korrekt justeret i forhold til blokstørrelsen, som arrayet fysisk arbejder med (4K). Ellers kan der opstå ydeevneproblemer. Derfor skal du oprette volumener med de relevante parametre:
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Fordeling af databaser på de oprettede volumener til vores testkonfiguration
Lagringsvolumen navn
Volumenstørrelse
Volumen LUNs kortlægning
ASM Volumen Enhedsdetalje
Allokeringsenhedsstørrelse
Data01
200GB
Kortlæg alle lagervolumener til lagersystemets alle dataporter
Redundans: Normal
Navn: DGDATA
Formål: Datafiler
4MB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Redundans: Normal
Navn: DGGRID1
Formål: Grid: CRS og afstemning
4MB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Redundans: Normal
Navn: DGGRID2
Formål: Grid: CRS og afstemning
4MB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redundans: Normal
Navn: DGREDO1
Formål: Redo-log for tråd 1
4MB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redundans: Normal
Navn: DGREDO2
Formål: Redo-log for tråd 2
4MB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Databaseindstillinger
- Blokstørrelse = 8K
- Swapplads = 16GB
- Deaktiver AMM (Automatisk Hukommelsesstyring)
- Deaktiver Transparente Store Sider
Andre indstillinger
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness=10
✓ vm.min_free_kbytes=524288 # sæt ikke dette, hvis du bruger Linux x86
✓ vm.vfs_cache_pressure=200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus "/as sysdba"
ændre systemindstilling til processes=2000 scope=spfile;
ændre systemindstilling til open_cursors=2000 scope=spfile;
ændre systemindstilling til session_cached_cursors=300 scope=spfile;
ændre systemindstilling til db_files=8192 scope=spfile;
Test af fejlbarhed
For demonstrationsformål blev HammerDB anvendt til at emulere OLTP-belastning. HammerDB konfiguration:
Antal lagre
256
Samlede transaktioner pr. bruger
1000000000000
Virtuelle brugere
256
Som resultat blev der opnået en måling på 2.1M TPM, hvilket er langt fra maksimal ydeevne for arrangementet , men er et 'loft' for den nuværende hardwarekonfiguration af serverne (primært på grund af processorerne) og deres antal. Målet med denne test er dog stadig at demonstrere pålideligheden af løsningen som helhed, ikke for at nå ydeevne-toppe. Så lad os bare tage udgangspunkt i dette tal.
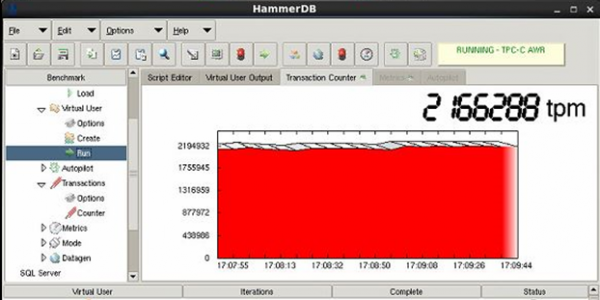
Test af fejl på en af noderne
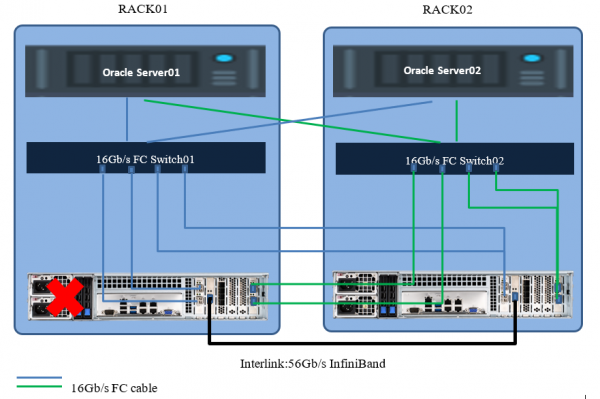
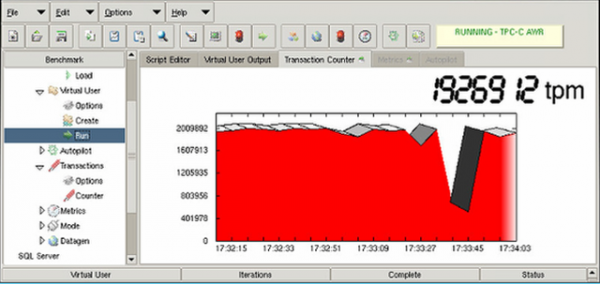
Værterne mistede noget af stien til lagringen, men fortsatte med at arbejde gennem de resterende med den anden node. Ydeevnen faldt i nogle sekunder på grund af genopbygning af veje, og kom derefter tilbage til normale niveauer. Der var ikke nogen serviceafbrydelse.
Test af fejl på skabet med alt udstyr
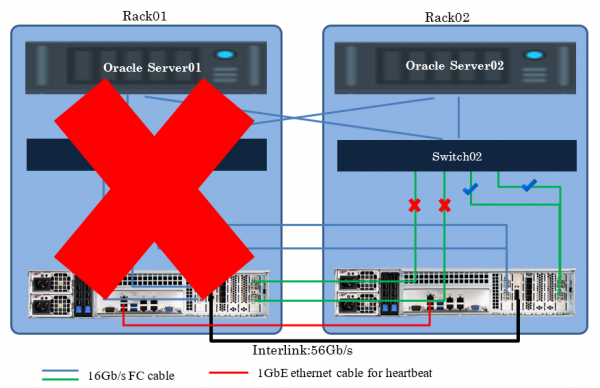
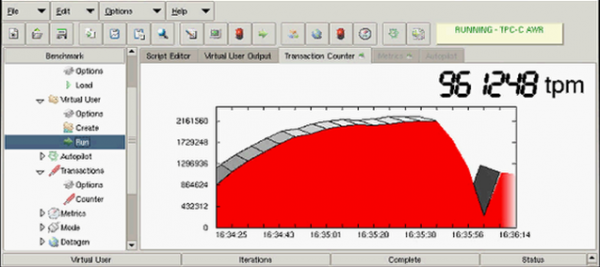
I dette tilfælde faldt ydeevnen også i nogle sekunder på grund af genopbygning af veje, og kom derefter tilbage til halvdelen af den oprindelige værdi. Resultatet faldt til det halve af det oprindelige på grund af udelukkelse af én applikationsserver. Der var heller ikke nogen serviceafbrydelse.
Hvis der er behov for at implementere en fejlsikker Cross-Rack disaster recovery-løsning for Oracle til en rimelig pris og med minimal indsats til implementering/administration, så vil samarbejde mellem Oracle RAC og arkitekturen være en af de bedste muligheder. I stedet for Oracle RAC kan ethvert andet software, der muliggør clustering, de samme DBMS eller virtualiseringssystemer bruges. Princippet for løsningens opbygning forbliver det samme. Og det endelige resultat – nul værdi for RTO og RPO.
Kilde: habr.com
